sqlite-vec 是 SQLite 的一个扩展,给数据库加一种向量列类型,再提供按距离排序的查询。它不是独立的数据库,也不起服务,只是一个 289280 字节的 dll。
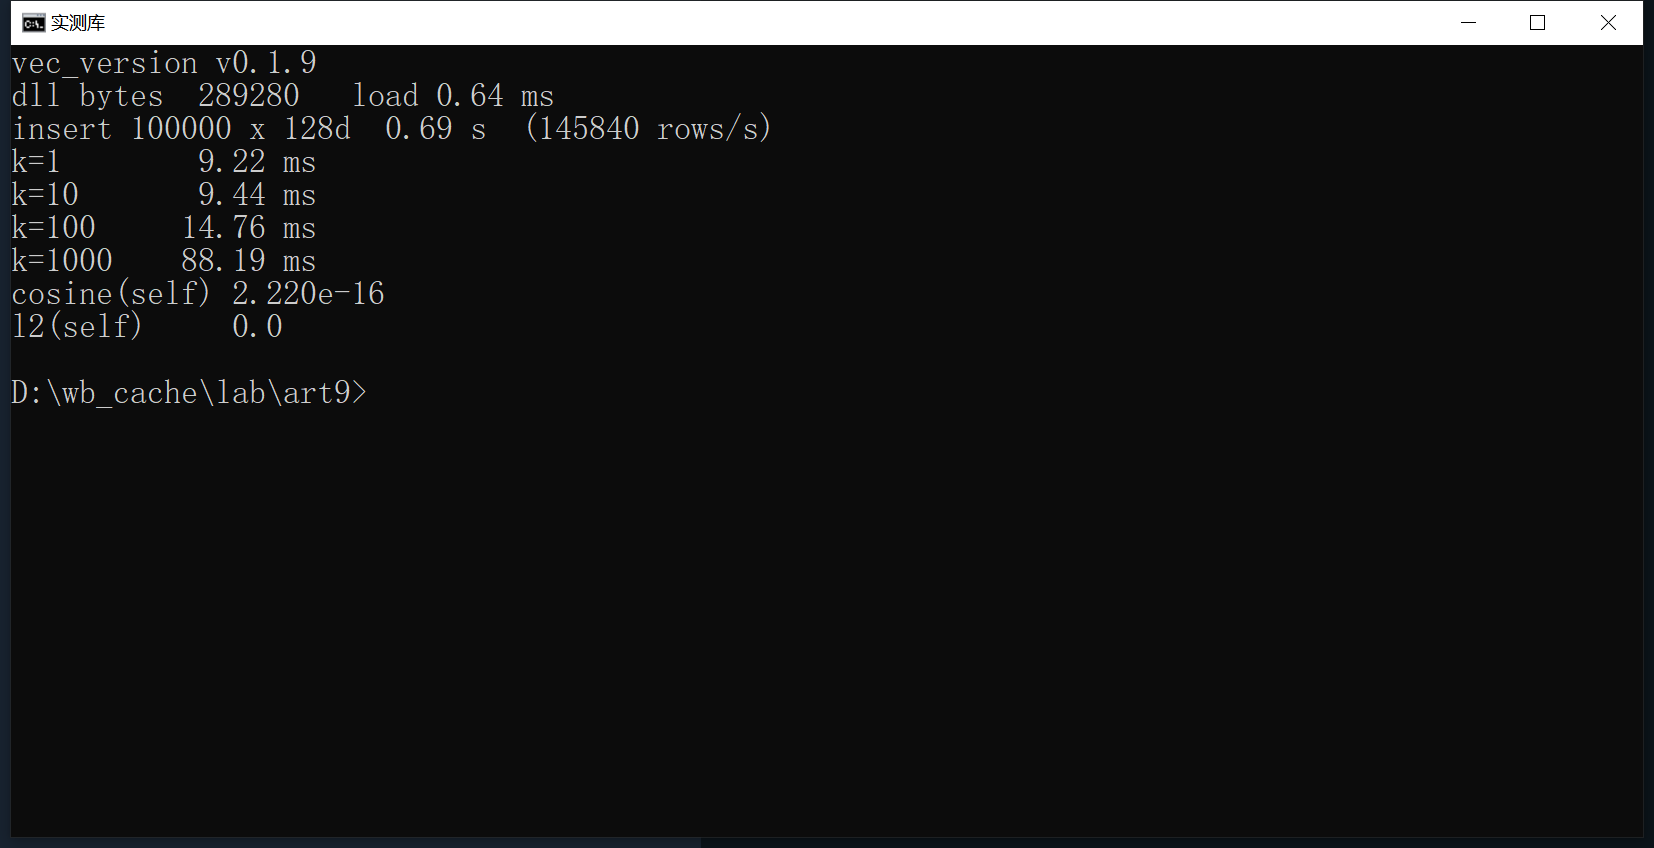
实测插入 10 万条 128 维向量用 0.69 秒,KNN 查 10 条 9.44 毫秒。这个延迟说明它走的是暴力扫描,没有建索引,选择它之前得先算一下自己的数据量。
282 KB 的 dll,加载 11 毫秒
con = sqlite3.connect(":memory:")
con.enable_load_extension(True)
con.load_extension("vec0.dll")
con.execute("select vec_version()").fetchone()
('v0.1.9',)
dll 289280 字节。第一次加载 10.93 毫秒(要读盘),同一个进程里再加载一次只要 0.64 毫秒。加载之后 SQLite 多了一个虚拟表类型 vec0,以及一组 vec_distance_* 函数。
没有守护进程、没有端口、没有独立的存储格式。索引文件就是一个普通的 .db,备份和迁移跟别的 SQLite 文件一样处理。
十万条 128 维,0.69 秒写完
| 操作 | 耗时 | 吞吐 |
|---|---|---|
| 加载扩展(首次) | 10.93 毫秒 | — |
| 加载扩展(进程内二次) | 0.64 毫秒 | — |
| 插入 100000 条 128 维 | 0.69 秒 | 145840 条/秒 |
| KNN k=10 | 9.44 毫秒 | — |
| 落盘体积 | 53702656 字节 | 51.2 MB |
| dll 体积 | 289280 字节 | 282 KB |
14.5 万条每秒这个写入速度说明它没有建索引,只是把向量按行存进去。真正的索引结构(HNSW 那一类)写入会慢一个数量级,因为要维护图结构。
向量用 struct.pack("%df" % dim, *vec) 打包成二进制再插,别传 Python 列表。列表会被逐个元素转换,写入速度掉到几十分之一。
k=1 和 k=10 一样快,说明它在全表扫
同样是那 10 万条向量,只改返回条数:
| k | 耗时 | 相对 k=1 |
|---|---|---|
| 1 | 9.22 毫秒 | 1.00 倍 |
| 10 | 9.44 毫秒 | 1.02 倍 |
| 100 | 14.76 毫秒 | 1.60 倍 |
| 1000 | 88.19 毫秒 | 9.56 倍 |
k 从 1 加到 10 只多花 0.22 毫秒,因为它无论如何都要把 10 万条全部算一遍距离,k 只决定最后排序取几个。真正变慢是在 k=1000,排序本身开始占时间。
把这个数字换算一下:10 万条 × 128 维 × 4 字节 = 51.2 MB,9 毫秒扫完相当于每秒读 5.6 GB,正好是内存带宽的量级。数据量涨到 100 万条,单次查询就是 100 毫秒往上。
落盘就是原始大小,没有压缩
10 万条 128 维 float32 理论大小是 51.2 MB,实际落盘的 .db 是 53702656 字节,几乎一模一样。这说明存的就是原始向量,没有量化、没有压缩。
好处是精度不丢,坏处是占空间。换 768 维的模型(很多中文 embedding 是这个维度),同样 10 万条就是 307 MB;100 万条 3 GB。选模型的时候把这条算进去。
三个距离函数,有一个会报错
select vec_distance_cosine(?, ?)  ->  2.220446049250313e-16
select vec_distance_l2(?, ?)      ->  0.0
select vec_distance_hamming(?, ?) ->  Cannot calculate hamming distance
                                      between two float32 vector
同一个向量跟自己算,余弦距离是 2.22e-16、L2 距离是 0.0。前者不是精确的 0,是浮点误差,判断「完全相同」时不能直接比 0,要给个 1e-9 的容差。
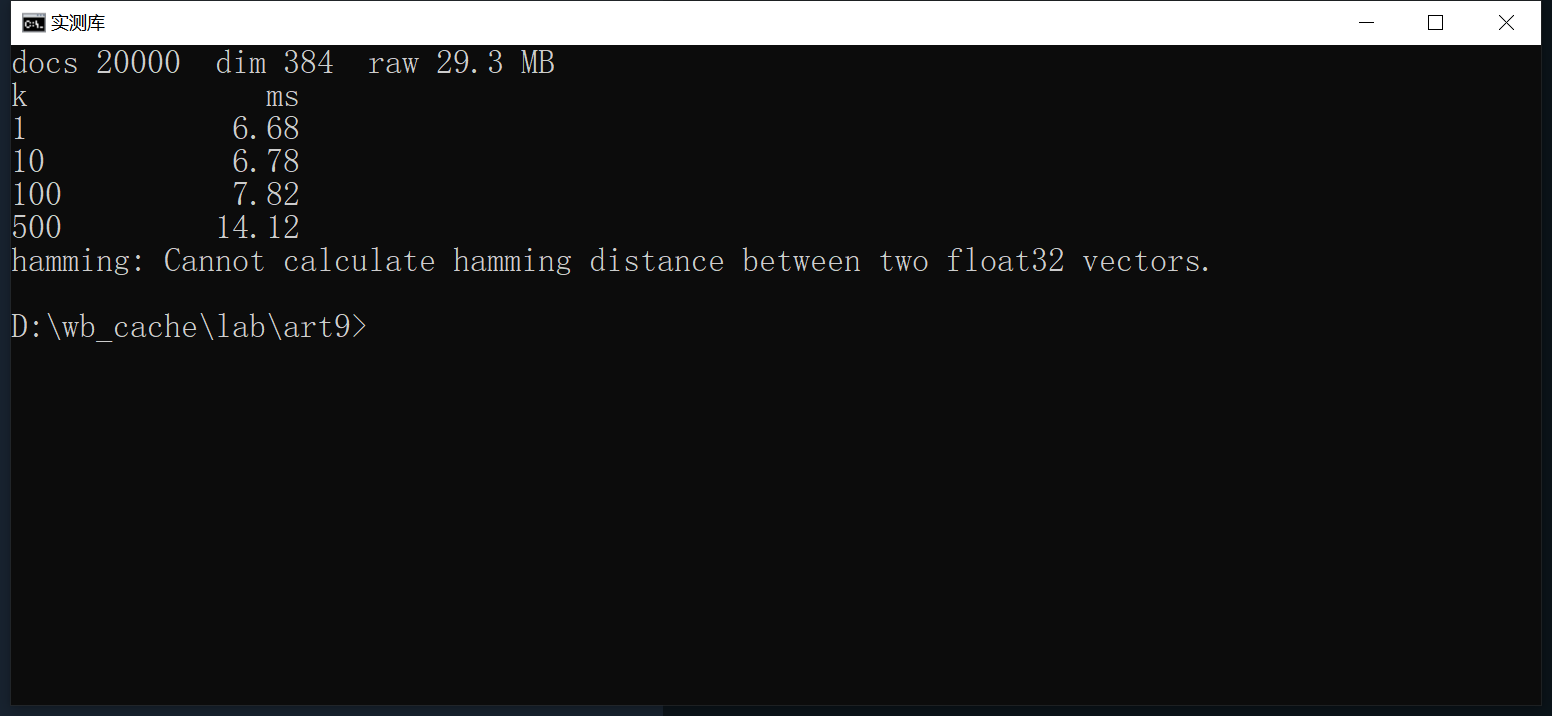
hamming 只能用于二进制向量(bit 类型),拿 float32 去调会直接抛异常。如果要用它,列类型得声明成 bit[128] 之类,不是 float[128]。
十万条以内够用,再多就换
这个量级下它的表现很好:单次查询 10 毫秒、写入每秒 14 万条、一个 dll 零依赖、还能跟业务表做 JOIN。个人知识库、几千到几万条文档的语义检索,用它比部署一个向量数据库省事得多。
数据量上到百万级就该换方案了,因为每次查询都要全表扫。带 HNSW 索引的方案(qdrant、milvus 那一类)建索引慢、占内存,但查询是亚毫秒级,跟数据量基本无关。
还有一件要提前想清楚:它只管存和查,不负责生成向量。embedding 得自己调模型算好再写进来,模型换了维度就变了,整张表要重建。