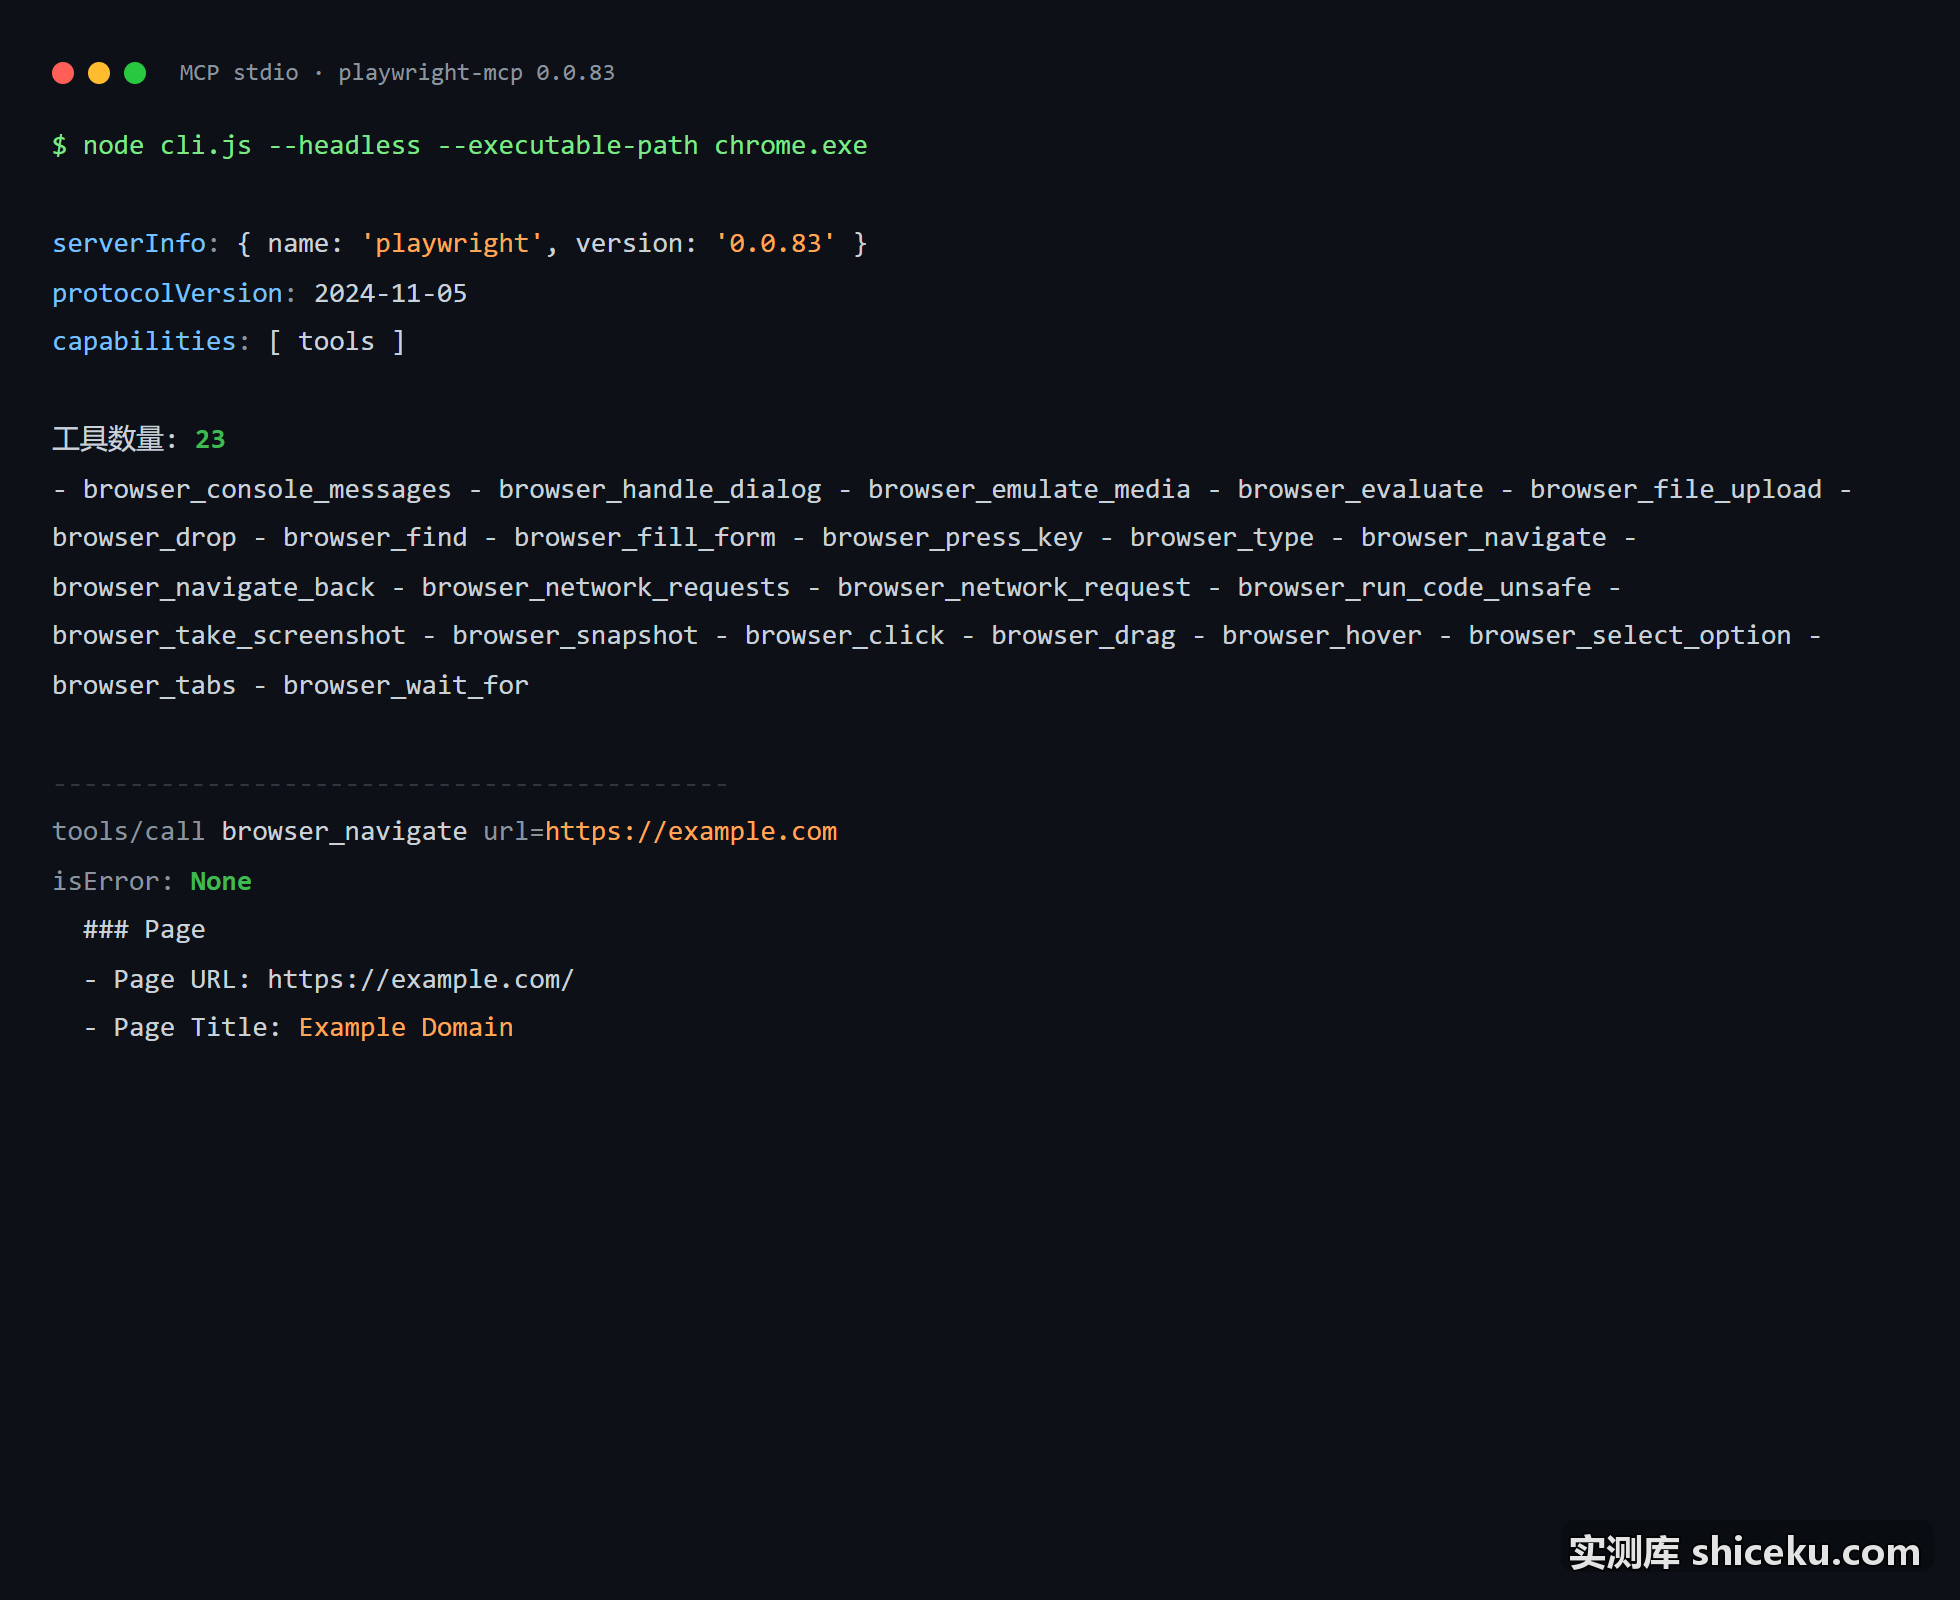
装完 @playwright/mcp 0.0.83 之后,AI 客户端通过 MCP 协议连上它,就能让 AI 操控浏览器:开页面、点击、填表、截图,一共 23 个工具。我在 Windows 上把服务单独跑起来验证了一遍,握手成功,browser_navigate 拿到 example.com 的页面标题,browser_take_screenshot 截出一张 450636 字节的图。第一次启动撞了个坑,直接敲 playwright-mcp 这个名字会报 WinError 2。
它把浏览器操作包成 MCP 工具,握手走标准输入输出,不占端口。
我是用脚本按 JSON-RPC over stdio 驱动它的,没接 Claude Desktop 或 Cursor。
装它要多久,装了什么?
npm install -g @playwright/[email protected]
playwright-mcp --version
added 3 packages in 3s,从敲命令到装完 7 秒。第二条命令输出 Version 0.0.83。
包本体解压后只有 91398 字节,直接依赖两个:playwright 和 playwright-core。
为什么直接敲 playwright-mcp 会报 WinError 2?
用脚本按常规方式起子进程,把这个名字当可执行文件传进去,会直接抛:
FileNotFoundError: [WinError 2] 系统找不到指定的文件问题在 npm 的 bin 上。全局目录里那个没有扩展名的 playwright-mcp 是 shell 脚本,Windows 的进程创建 API 不认。
同一个目录下的 playwright-mcp.cmd 是可以直接调的,实测输出 Version 0.0.83。另一种写法是让 node 去跑 cli.js:
node "$(npm root -g)/@playwright/mcp/cli.js" --headless怎么让它用本机 Chrome,而不是再下一份浏览器?
加 --executable-path 指到系统里已有的 Chrome,就不用另装一份约 150MB 的 chromium。
node "$(npm root -g)/@playwright/mcp/cli.js" --headless ^
  --executable-path "C:/Program Files/Google/Chrome/Application/chrome.exe"
不加这个参数我也试了,服务能起来,navigate 也正常返回,stderr 没有任何输出,具体落在哪份浏览器上没细查。配合 --headless 运行时没有窗口。
23 个工具分别管什么?
握手只有三步:initialize、notifications/initialized、tools/list。服务端回的 serverInfo 是 { name: playwright, version: 0.0.83 },protocolVersion 2024-11-05,capabilities 里只有 tools 一项。
tools/list 返回 23 个,按用途分四类:
| 类别 | 工具 |
|---|---|
| 跳转与结构 | browser_navigate, browser_navigate_back, browser_snapshot |
| 交互 | browser_click, browser_type, browser_press_key, browser_select_option, browser_hover, browser_drag, browser_fill_form |
| 文件 | browser_file_upload, browser_drop |
| 观测 | browser_take_screenshot, browser_console_messages, browser_network_requests, browser_network_request, browser_evaluate, browser_find |
| 控制流 | browser_wait_for, browser_handle_dialog, browser_tabs, browser_emulate_media, browser_run_code_unsafe |
怎么确认它真的在操作浏览器?
调 browser_navigate 打开 https://example.com,返回里 isError 为空,正文写着 Page URL 和 Page Title: Example Domain,同时在当前目录生成一份 .playwright-mcp/page-2026-10-20T09-11-49-070Z.yml 快照。
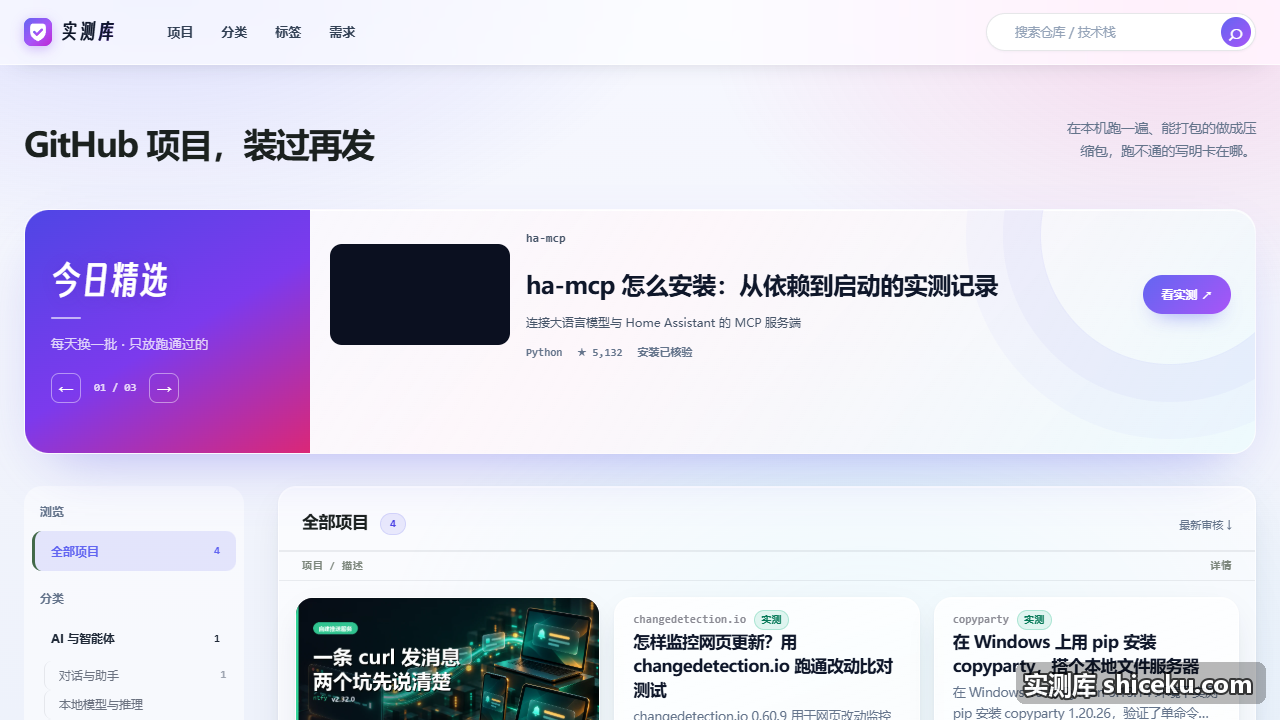
再调 browser_take_screenshot 要一张图,返回的 content 里带 image 类型,base64 解出来 450636 字节。
我让它截的是本站首页,图里「今日精选」「全部项目」和 changedetection.io 的卡片都在,说明页面真的渲染出来了,不是只回了个状态码。
它占端口吗?
不占。用 netstat -ano 查该进程,没有 LISTENING 记录,全程走 stdio。
这一点对本地工具很重要:不用管端口冲突,也没法从外部连进来。
常见问题
必须装 Claude Desktop 或 Cursor 才能用吗?
不必须。任何能按 JSON-RPC over stdio 通信的客户端都能驱动它。我这次就是自己写脚本发请求,没接图形客户端。
不装浏览器能跑吗?
实测能起来,navigate 也返回正常,stderr 没报错。但它最终用哪份浏览器执行,取决于你环境里已有的东西。想明确指定就加 --executable-path。
23 个工具要全学吗?
不用。日常用得最多的是 navigate、click、type、snapshot、take_screenshot 这几个,剩下的按需查。
它和直接写 playwright 脚本有什么区别?
区别在于调用方。写脚本是你自己写逻辑;挂成 MCP 之后,是 AI 客户端决定调哪个工具、传什么参数。这次只验证了服务端能正常响应,没有验证 AI 侧的决策质量。
适合谁
适合想让 AI 直接操作浏览器的人。典型的几种场景:
- 自动填表,不用你手写选择器
- 抓页面内容,让模型自己判断该看哪块
- 跑可视化检查,点完截一张图留证
如果你只是要写固定流程的爬虫,直接用 playwright 库更省事,多一层 MCP 反而绕。