Qdrant 是一个向量数据库,单文件二进制就能跑,对外给 HTTP 与 gRPC 两套接口。它常被拿来存 embedding、做语义检索,也能给 AI 应用当记忆层。这篇在 Windows 上起服务、建集合,写两百个点、测检索延迟,并用官方控制台把结果核对了一遍。
一个 82.5 MB 的 exe,启动 0.66 秒
二进制        qdrant.exe,86,529,536 字节(82.5 MB)
版本          1.19.2(commit 016542aa5deb6c66380bb137badf73d54f742bde)
HTTP 端口     6333
gRPC 端口     6334
首次启动      1.11 秒
二次启动      0.66 秒
没有依赖,不用装 Python 或 JVM,回车就有服务。启动完成后访问根路径会返回服务名和版本号,日志里还会打印控制台地址与一行 Agentic Skills 链接。数据目录用环境变量指定:QDRANT__STORAGE__STORAGE_PATH,端口同理,双下划线就是配置层级。
官方控制台在 Windows 包里没带
默认访问 /dashboard          404
需要两个环境变量
  QDRANT__SERVICE__ENABLE_STATIC_CONTENT=true
  QDRANT__SERVICE__STATIC_CONTENT_DIR=解压后的 dist 目录
静态资源来源                qdrant-web-ui v0.2.19 的 dist-qdrant.zip,7,194,275 字节
Docker 镜像里控制台是打进去的,Windows 单文件版本不带。要把界面补上,去官方前端仓库下一个 dist-qdrant.zip 解开,再让服务把静态目录指过去。设好之后 /dashboard/ 返回 1,790 字节的入口页,界面和 API 同源,不存在跨域问题。
建集合 2203 毫秒,写 200 个点 168 毫秒
PUT /collections/shiceku_docs      2203.2 毫秒(首次建集合,含存储初始化)
向量配置                           size=64,distance=Cosine
PUT /collections/.../points?wait=true   168 毫秒,写入 200 个点
返回状态                           completed
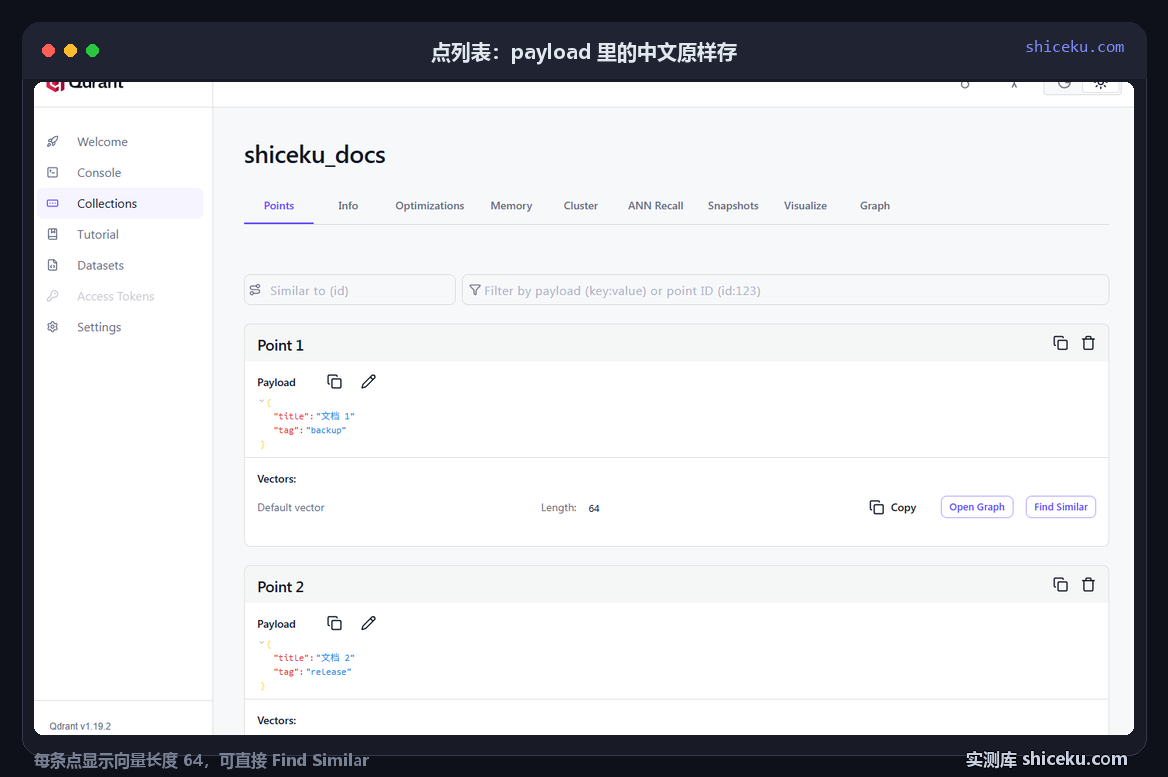
第一次建集合慢在初始化存储上,后面的操作都在毫秒级。写入用 wait=true 会等索引落地再返回,所以这 168 毫秒是可确认写成的耗时,不是丢进队列就返回。每个点带了 payload:标题和标签,中文直接存,不用转码。
检索中位 1.4 毫秒,首条得分 0.8564
| 指标 | 实测值 |
|---|---|
| 检索五次耗时 | 2.1 / 1.4 / 1.3 / 1.4 / 1.4 毫秒 |
| 中位数 | 1.4 毫秒 |
| top-5 首条得分 | 0.8564(Cosine) |
| 返回条数 | limit=5,with_payload=true |
这 1.4 毫秒是 HTTP 往返加检索的总时间。查询向量是 64 个浮点数拼成的数组,直接放在 vector 字段里,没走批量接口。两百个点、64 维的量太小,说明不了大规模性能,但能说明接口本身几乎不占时间。真到百万级,瓶颈会落在索引构建与内存上,查询接口这一层不会成为主要开销。
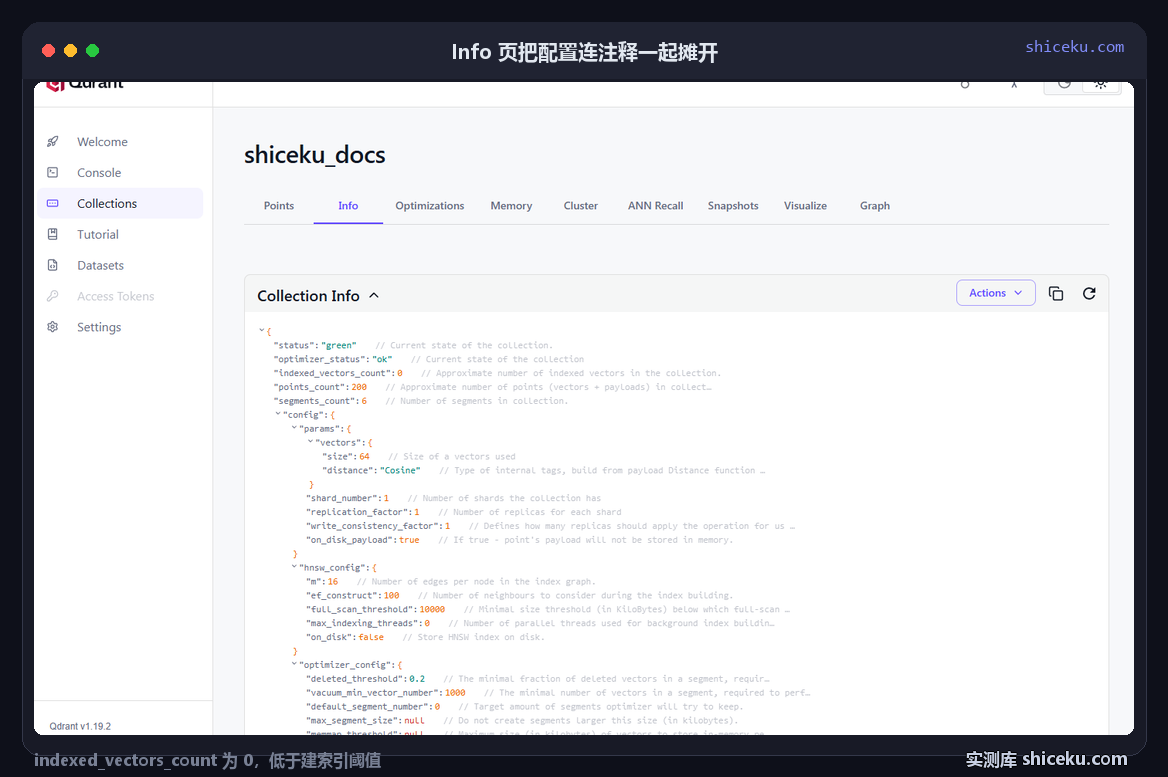
Info 页显示索引是空的,原因在阈值
status                green
optimizer_status      ok
points_count          200
segments_count        6
indexed_vectors_count 0
hnsw_config           m=16,ef_construct=100,full_scan_threshold=10000
optimizer_config      indexing_threshold=10000
控制台的 Info 页把整份配置连注释一起摊开,这点比看文档快。注意到 indexed_vectors_count 显示 0,数据其实都在:两百个点低于 10000 的建索引阈值,查询走全量扫描。等点数过万才会自动建 HNSW 索引,届时同样的查询会明显变快。
数据落盘 102 个文件,482 MB
storage 目录    102 个文件
占用            482,551,037 字节(约 460 MB)
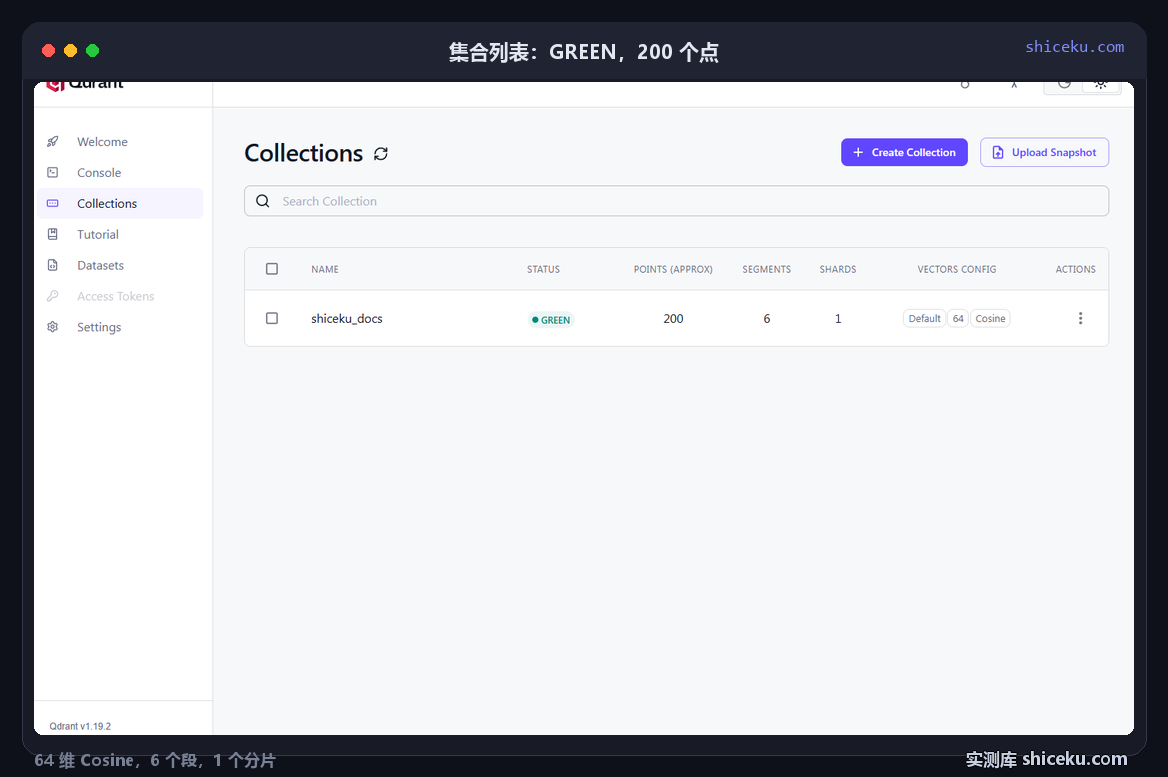
集合状态        GREEN,200 个点,6 个段,1 个分片,1 个副本
两百条 64 维向量本身只有几百 KB,磁盘占用却到 460 MB,多出来的是段文件与预分配空间。评估容量时按「点数乘以向量维度乘以四字节」算出来的数字会严重偏低,实际还要加上索引与段开销。单看 200 条 64 维向量,原始数据不到 1 MB,占比不到千分之二。控制台的 Collections 页能看到段数,段越多通常说明写入越零散。
实测范围:Windows 10 22H2(10.0.19045.6466) / Qdrant 1.19.2 / qdrant-web-ui 0.2.19 / 2026-10-22。百万级数据 / 过滤检索 / 快照恢复、集群与鉴权都没有验证,不作结论。