llama.cpp 是不带 Python 的本地推理引擎,C++ 写的,解压出来 60 MB 一堆 exe 加 dll,跑起来不需要装 CUDA、不需要 Python 环境、不需要联网。它的模型格式是 GGUF,一份量化文件就是一个模型。
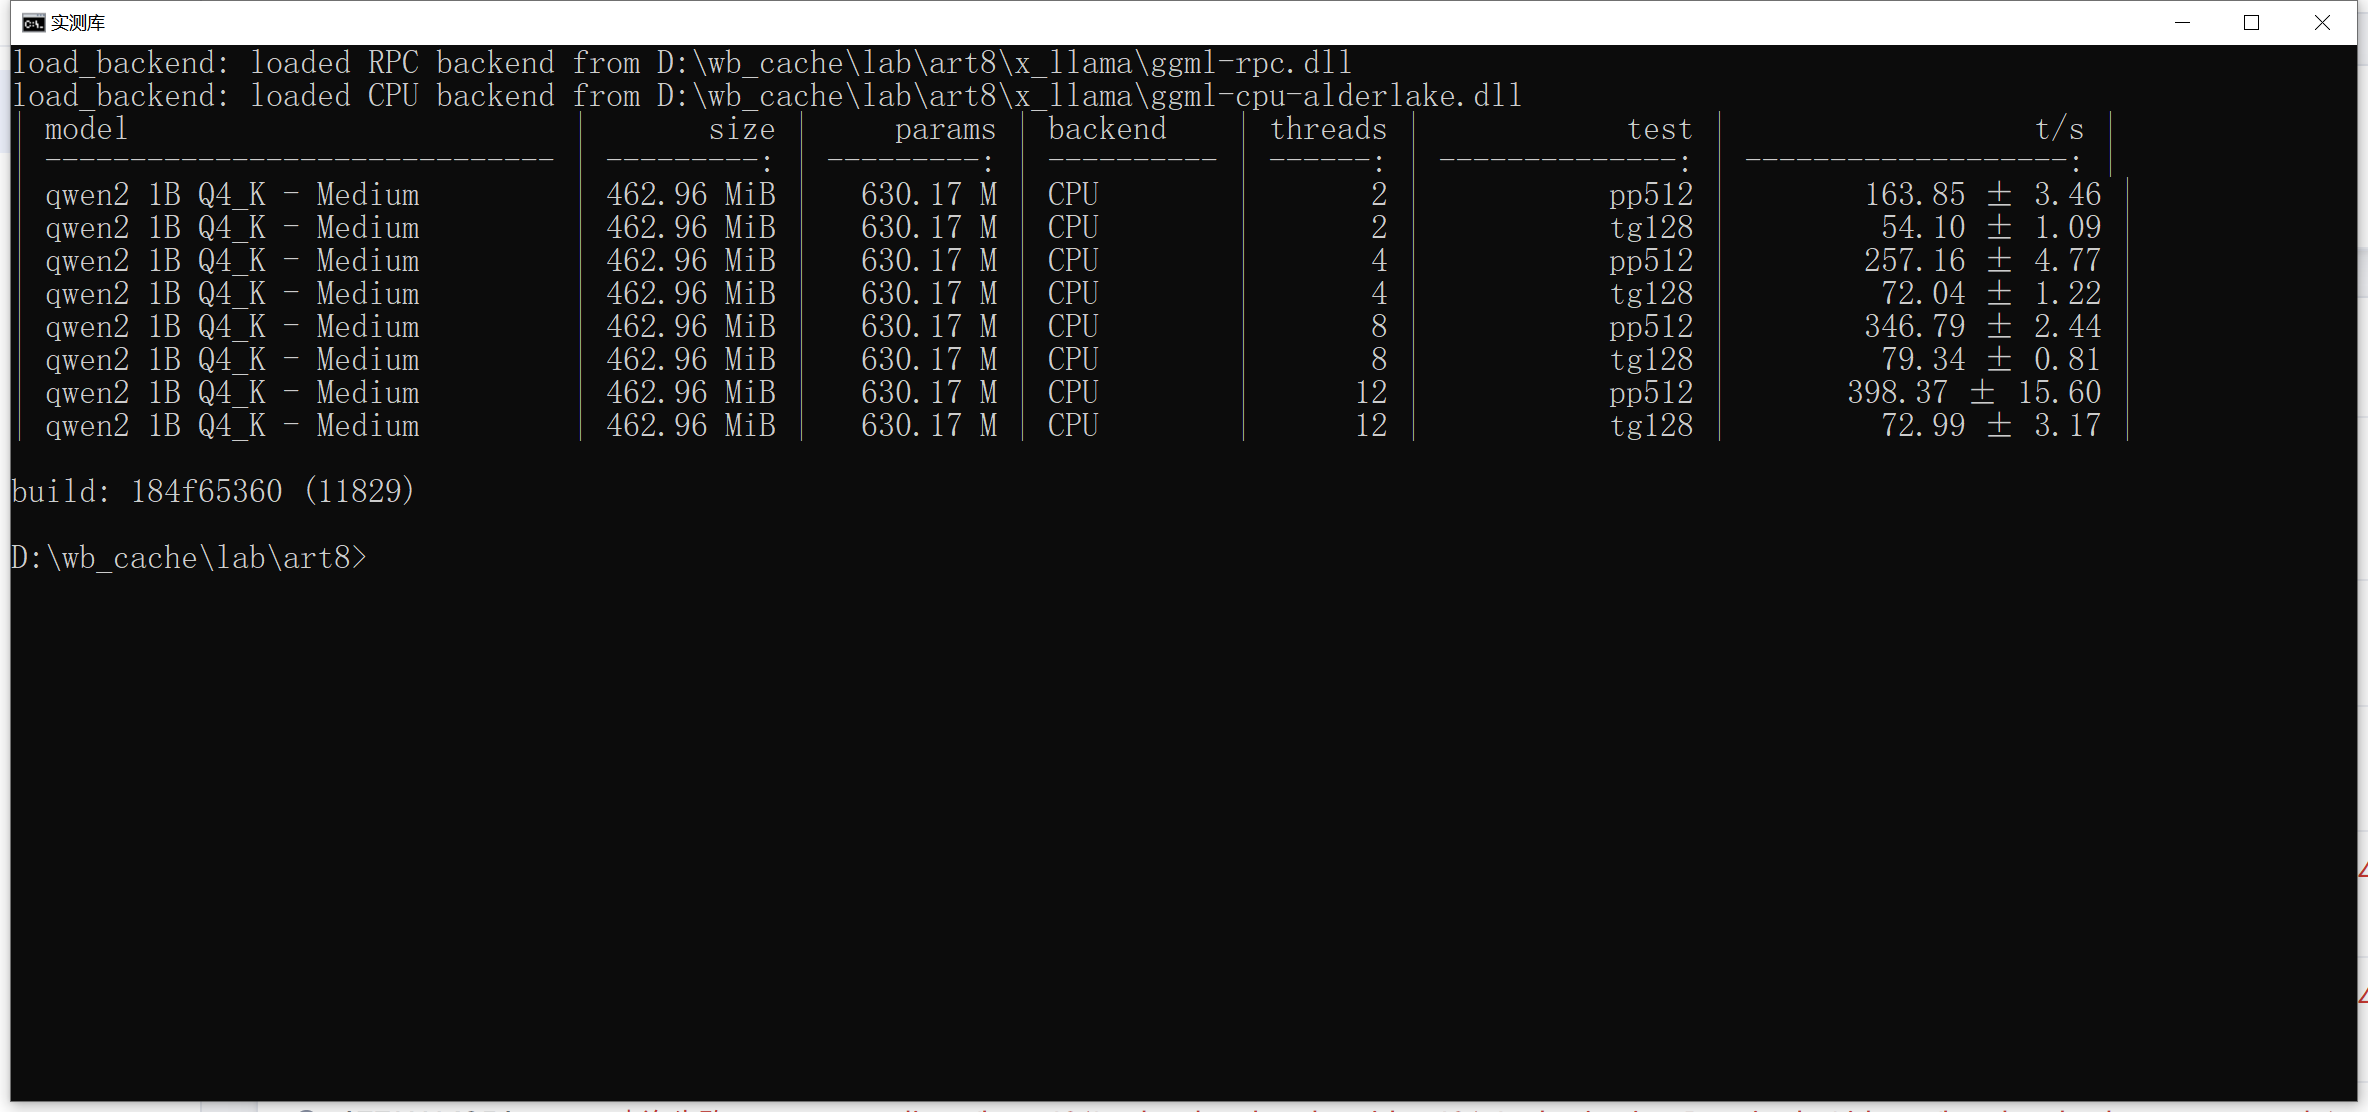
拿 Qwen2.5 的 0.5B 指令模型(Q4_K_M 量化,462.96 MiB)在 12 核 CPU 上做实测,两段负载的最优线程数不一样:提示词处理一路涨到 12 线程,生成在 8 线程就到顶了。
60 MB 的目录,双击就能跑
llama-bench --help
llama-cli --help
llama-completion --help
目录里每个 exe 只有 9216 字节,真正的代码在旁边的 ggml.dll 和 llama.dll 里,整个目录 60 MB。这样拆的好处是 llama-bench / llama-cli / llama-server 共用同一套推理核心,换模型不用换程序。
模型文件是 491400032 字节的 GGUF,放在哪儿都行,命令行里指路径就好。它跟程序完全解耦,同一个模型能被这里的所有工具读。
四个线程档位,跑同一段基准
llama-bench 的 pp512 测的是处理 512 个 token 提示词的速度,tg128 测的是连续生成 128 个 token 的速度。前者吃并行,后者吃内存带宽:
| 线程数 | pp512 | tg128 | pp 相对 8 线程 | tg 相对 8 线程 |
|---|---|---|---|---|
| 2 | 163.85 t/s | 54.10 t/s | 47% | 68% |
| 4 | 257.16 t/s | 72.04 t/s | 74% | 91% |
| 8 | 346.79 t/s | 79.34 t/s | 100% | 100% |
| 12 | 398.37 t/s | 72.99 t/s | 115% | 92% |
| 2 到 8 线程的倍数 | 2.12 倍 | 1.47 倍 | — | — |
| 2 到 12 线程的倍数 | 2.43 倍 | 1.35 倍 | — | — |
| 12 线程比 8 线程 | 高 14.9% | 低 8.0% | — | — |
| 8 线程那档的波动 | ±2.44 | ±0.81 | — | — |
| 12 线程那档的波动 | ±15.60 | ±3.17 | — | — |
| 模型体积 | 462.96 MiB | 491400032 字节 | — | — |
| 单个 exe 体积 | 9216 字节 | 逻辑在 dll 里 | — | — |
| 解压后目录体积 | 60 MB | 含全部 dll | — | — |
从 2 线程加到 8 线程,提示词处理快 2.12 倍,生成快 1.47 倍。继续加到 12 线程,提示词处理还能再涨到 398.37 t/s,生成却从 79.34 跌回 72.99。
绝对值会随机器负载浮动。同一台机器上跑了三轮,8 线程的 pp512 落在 346.79 到 404.39 之间,tg128 落在 79.34 到 79.88 之间。生成这一列很稳,提示词那一列的波动接近 15%,做横向对比时只看趋势,别拿单次数字当基准。
两段负载的最优线程数不一样
提示词处理是批量的矩阵乘法,512 个 token 一起算,多开线程就有更多活可以分,所以 12 线程的 398.37 t/s 比 8 线程的 346.79 高 14.9%。
生成阶段完全相反:每步只算一个 token,矩阵乘法的并行度很低,真正的瓶颈是内存带宽。12 个线程同时在等同一份权重从内存读进来,调度和缓存同步的开销反而成了负担,于是 79.34 掉到 72.99,少了 8.0%。
误差列也能看出来:8 线程那档 pp512 是 346.79 ± 2.44,很稳;12 线程是 398.37 ± 15.60,波动大了六倍,说明满核调度不稳。
实用的做法按用途分。-t 8 适合长文生成和交互对话,这时候生成速度决定体验;-t 12 适合一次性吞长文档做摘要,提示词处理占大头,能多吃 14.9% 的吞吐。
一次问答的完整时间线
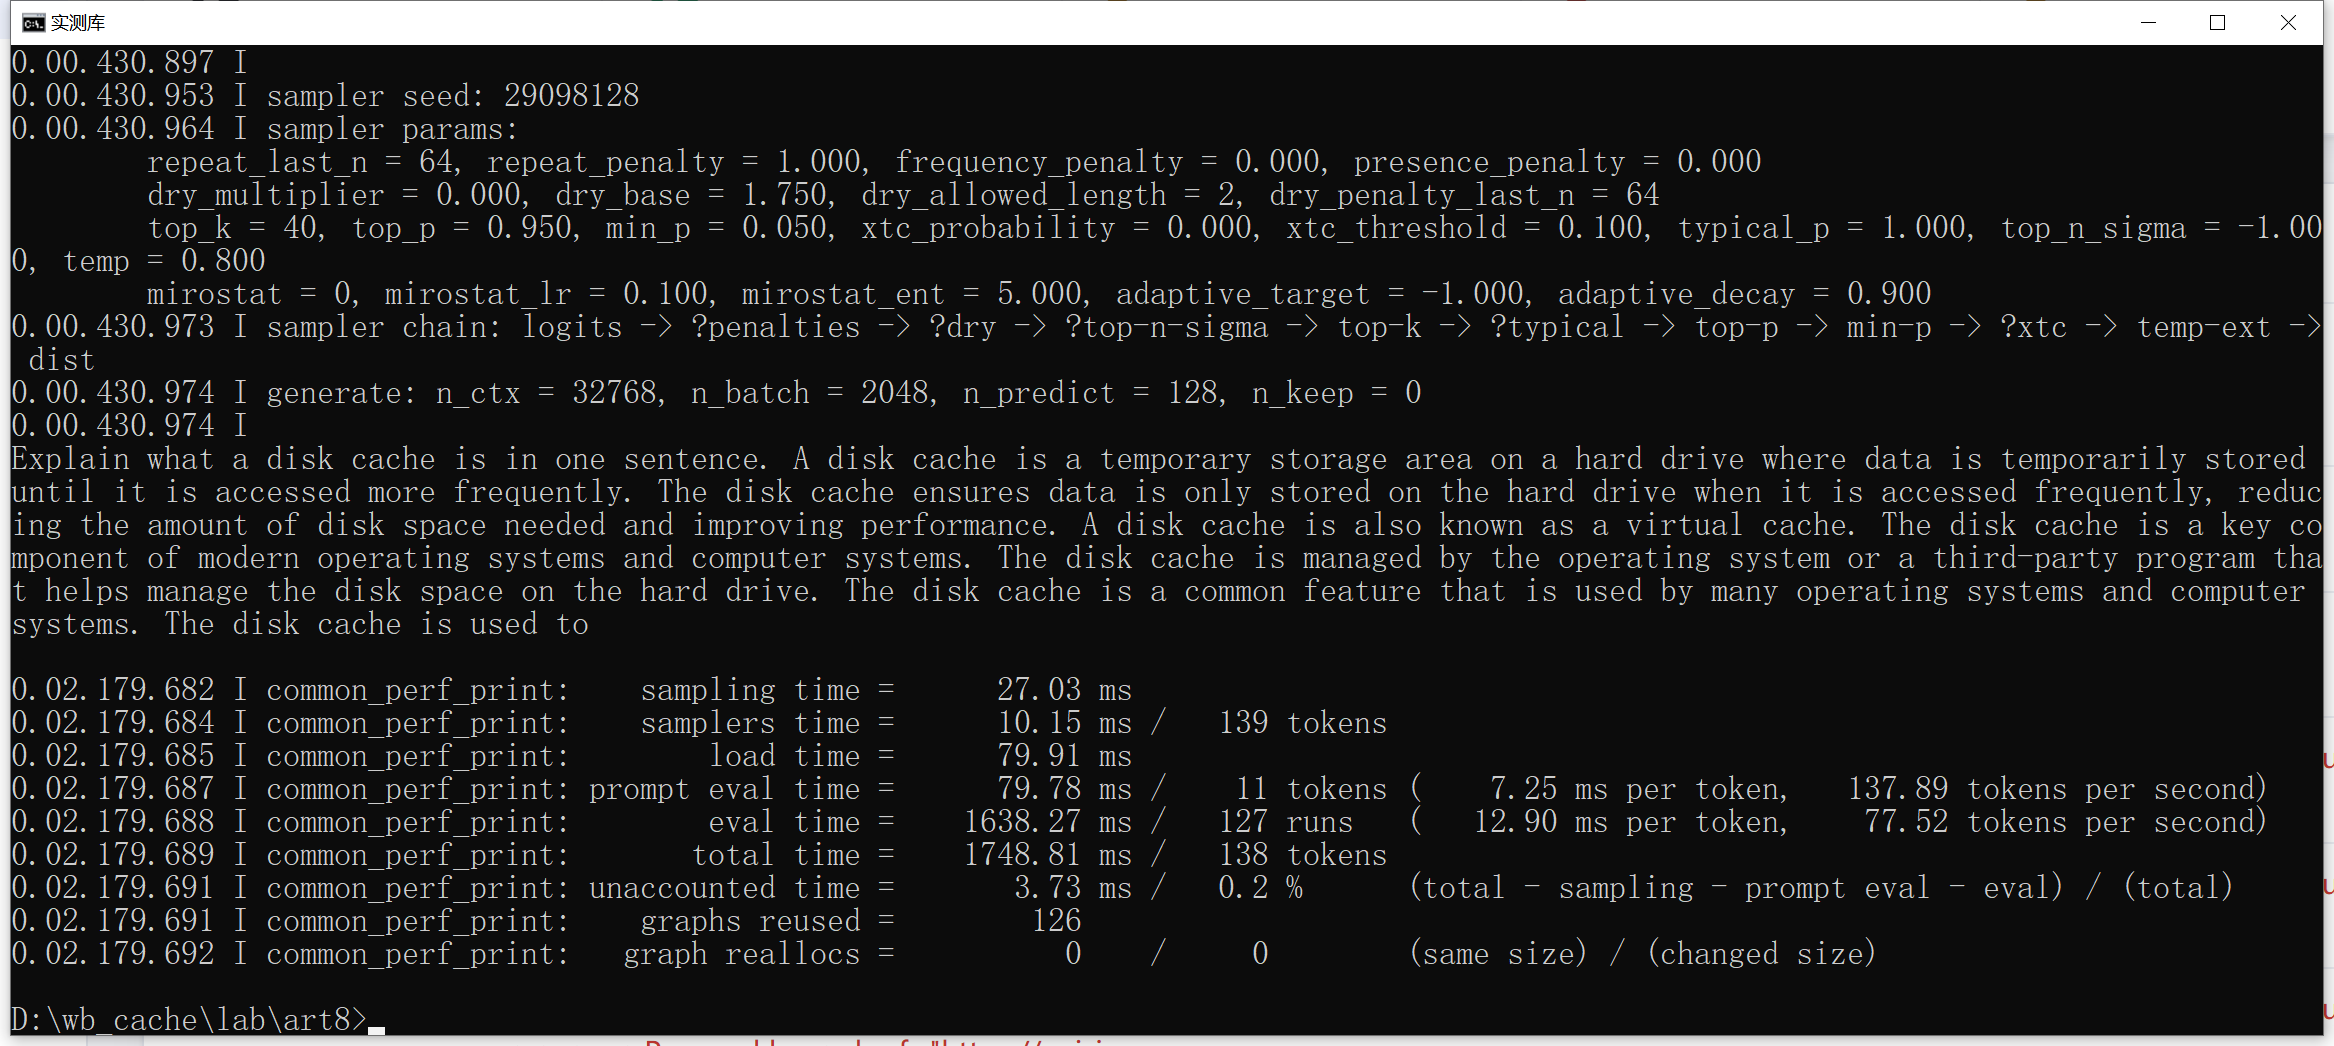
llama-completion -m model.gguf -t 8 -n 128 -p "Explain what a disk cache is in one sentence." --no-warmup -no-cnv
load time =     79.91 ms
prompt eval time =     79.78 ms /    11 tokens (   7.25 ms per token,   137.89 tokens per second)
       eval time =   1638.27 ms /   127 runs   (  12.90 ms per token,    77.52 tokens per second)
total time = 1748.81 ms / 138 tokens| 阶段 | 耗时 | 处理量 | 速度 |
|---|---|---|---|
| 模型加载 | 79.91 ms | 462.96 MiB | — |
| 提示词处理 | 79.78 ms | 11 个 token | 137.89 t/s |
| 生成 | 1638.27 ms | 127 个 token | 77.52 t/s |
| 合计 | 1748.81 ms | 138 个 token | — |
| 整条命令墙钟(三次取最小) | 1.19 秒 | — | — |
| 启动与初始化开销 | 0.61 秒 | — | — |
这条命令跑了三次,墙钟分别是 2.56、2.34、1.19 秒。差异来自生成的 token 数不固定:模型自己决定在哪里停下来,同样 -n 128 上限,有时输出 41 个 token 就收尾,有时写到 127 个才停。
所以判断速度要看内部计时的 77.52 t/s,别用墙钟除 token 数。这个数字和 llama-bench 那档 8 线程的 79.34 t/s 对得上,两套工具测的是同一个东西。
墙钟和 total time 的差值约 0.61 秒,是进程启动、加载 dll、初始化后端的固定成本。要连着问很多次,用 llama-server 把模型常驻内存,这 0.61 秒就省下来了。
0.5B 能干什么,不能干什么
71.46 t/s 的生成速度比人阅读快好几倍,输出来是一串串往外冒的。这个速度来自模型足够小:630.17M 参数、462.96 MiB 的量化文件。
换成 7B 模型(Q4 大约 4.4 GB),同规格的 CPU 上生成速度会掉到个位数 t/s,提示词处理也一起变慢。本地跑模型的现实是:速度基本和参数量成反比,想要更好的回答质量就得接受更长的等待。
0.5B 这类尺寸适合做格式转换、简单分类、关键词提取这些任务,写长文和推理链条它撑不住。选型的时候先想清楚要它干什么,再决定参数规模。
两种会直接退出
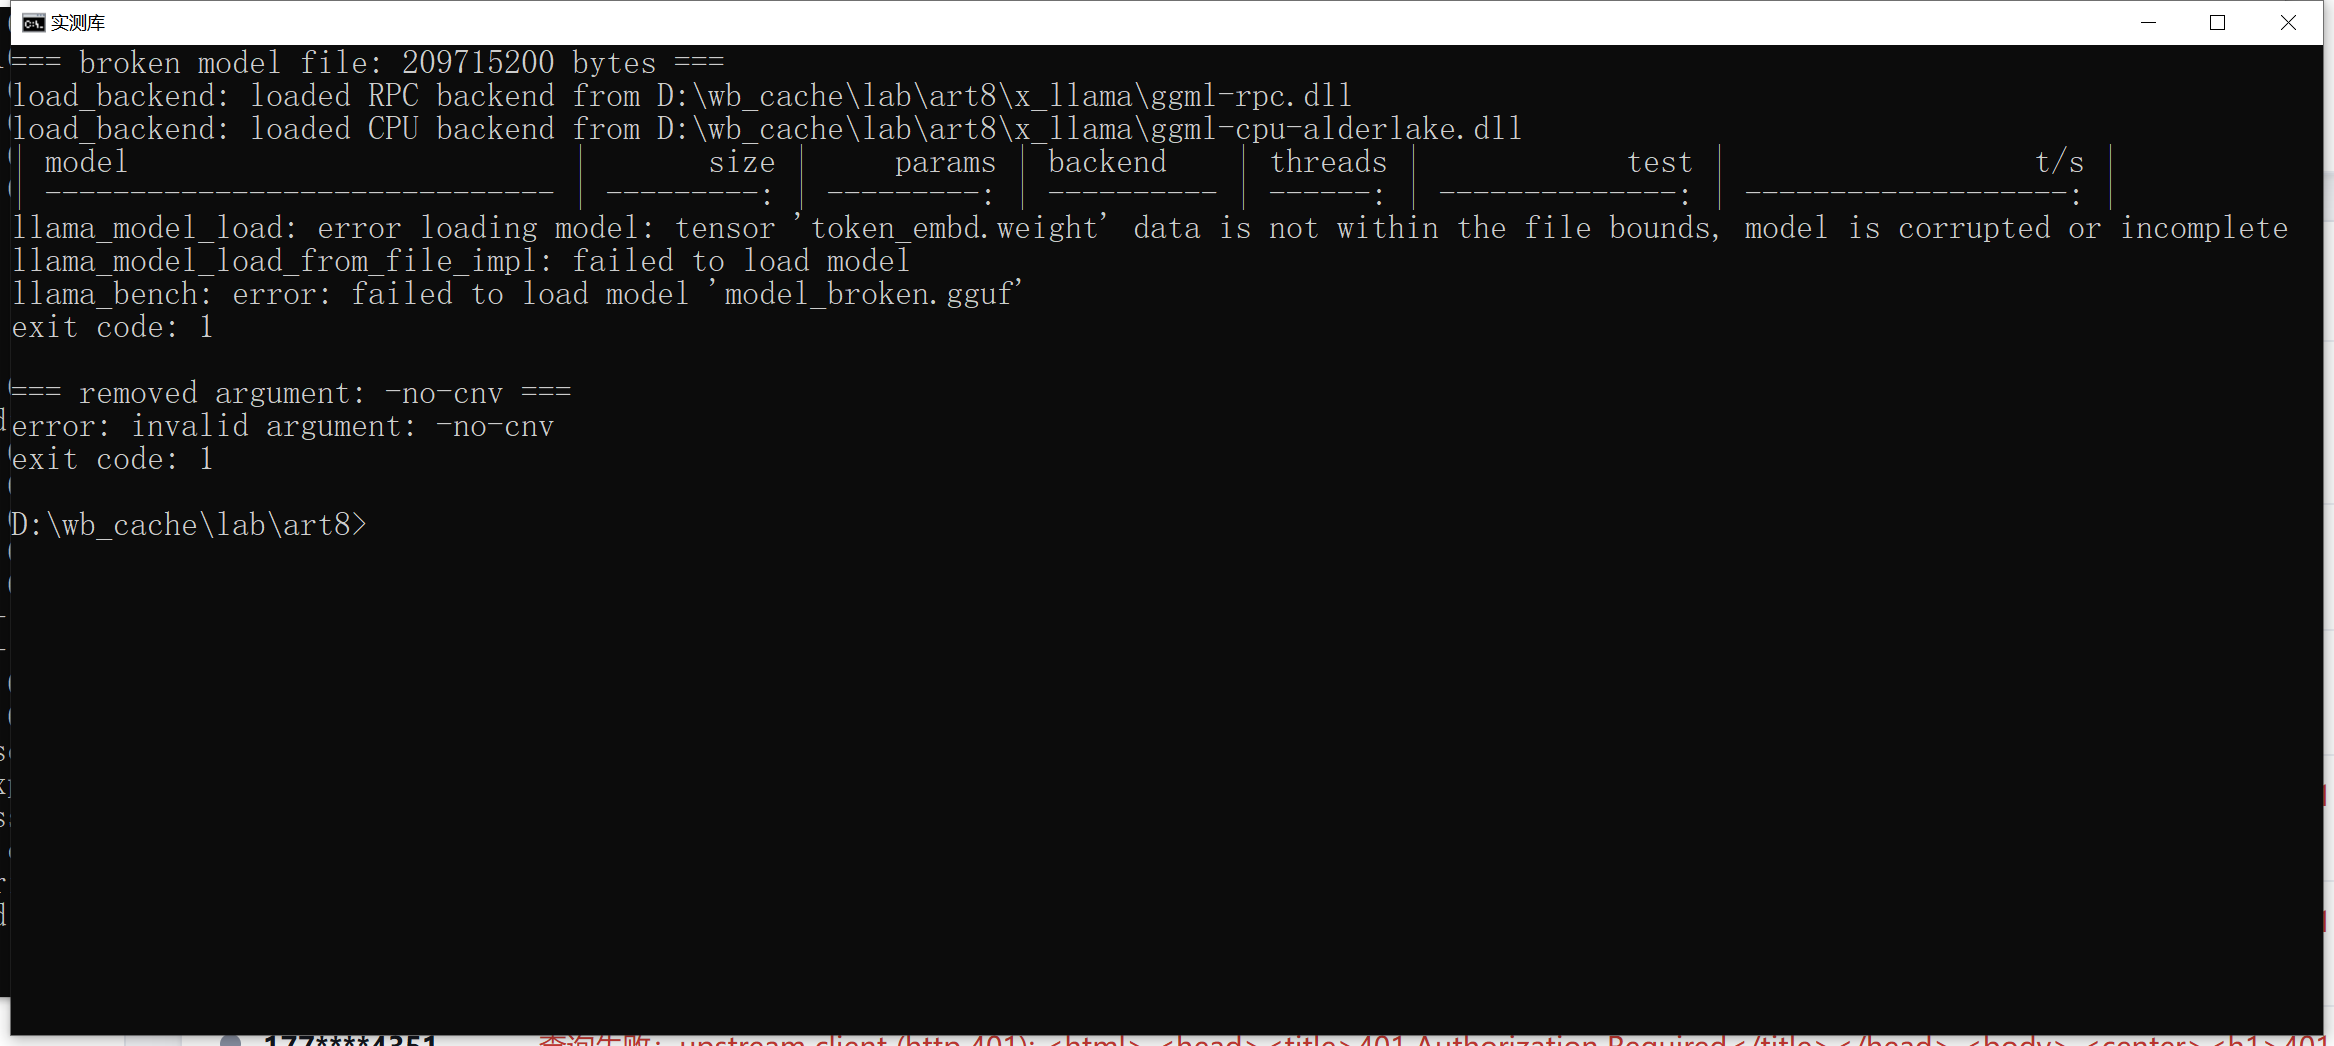
模型文件不完整的时候,llama.cpp 不会给一句「文件损坏」,而是把内部张量名打出来:
llama_model_load: error loading model: tensor 'token_embd.weight' data is not within the file bounds, model is corrupted or incomplete
llama_model_load_from_file_impl: failed to load model
llama_bench: error: failed to load model 'model.gguf'
模型文件字节数不对会报错退出,一个结果都不打印。这个报错在下载中断、磁盘写满时都会出现,判断依据是文件字节数对不对,不是看有没有报错文字。benchmark 表头照样打印,底下是空的。
写错参数名会报错退出,一个 token 都不生成。旧版本上的 -no-cnv 拿到新版上用就是这样:
error: invalid argument: -no-cnv退出码 1,提示只有这一行。命令行行为在版本之间会变,脚本里写死参数名的话,升级前先跑一次 --help 核对。
不用 GPU 也能用
这次全程没有显卡参与,走的是 CPU 后端(版本日志里的 ggml-cpu-alderlake.dll 就是针对这代 CPU 指令集编的)。同一套 exe 换到有显卡的机器上,加 -ngl 参数把层卸载到 GPU 能再快一个量级,但那是另一套测法。
没有显卡的机器上,它的价值是把「本地跑模型」的门槛降到解压即用:60 MB 的目录里 12 个 exe 共用一套 dll,不用装 Python 依赖,不用配环境变量,换模型只换那个 gguf 文件。