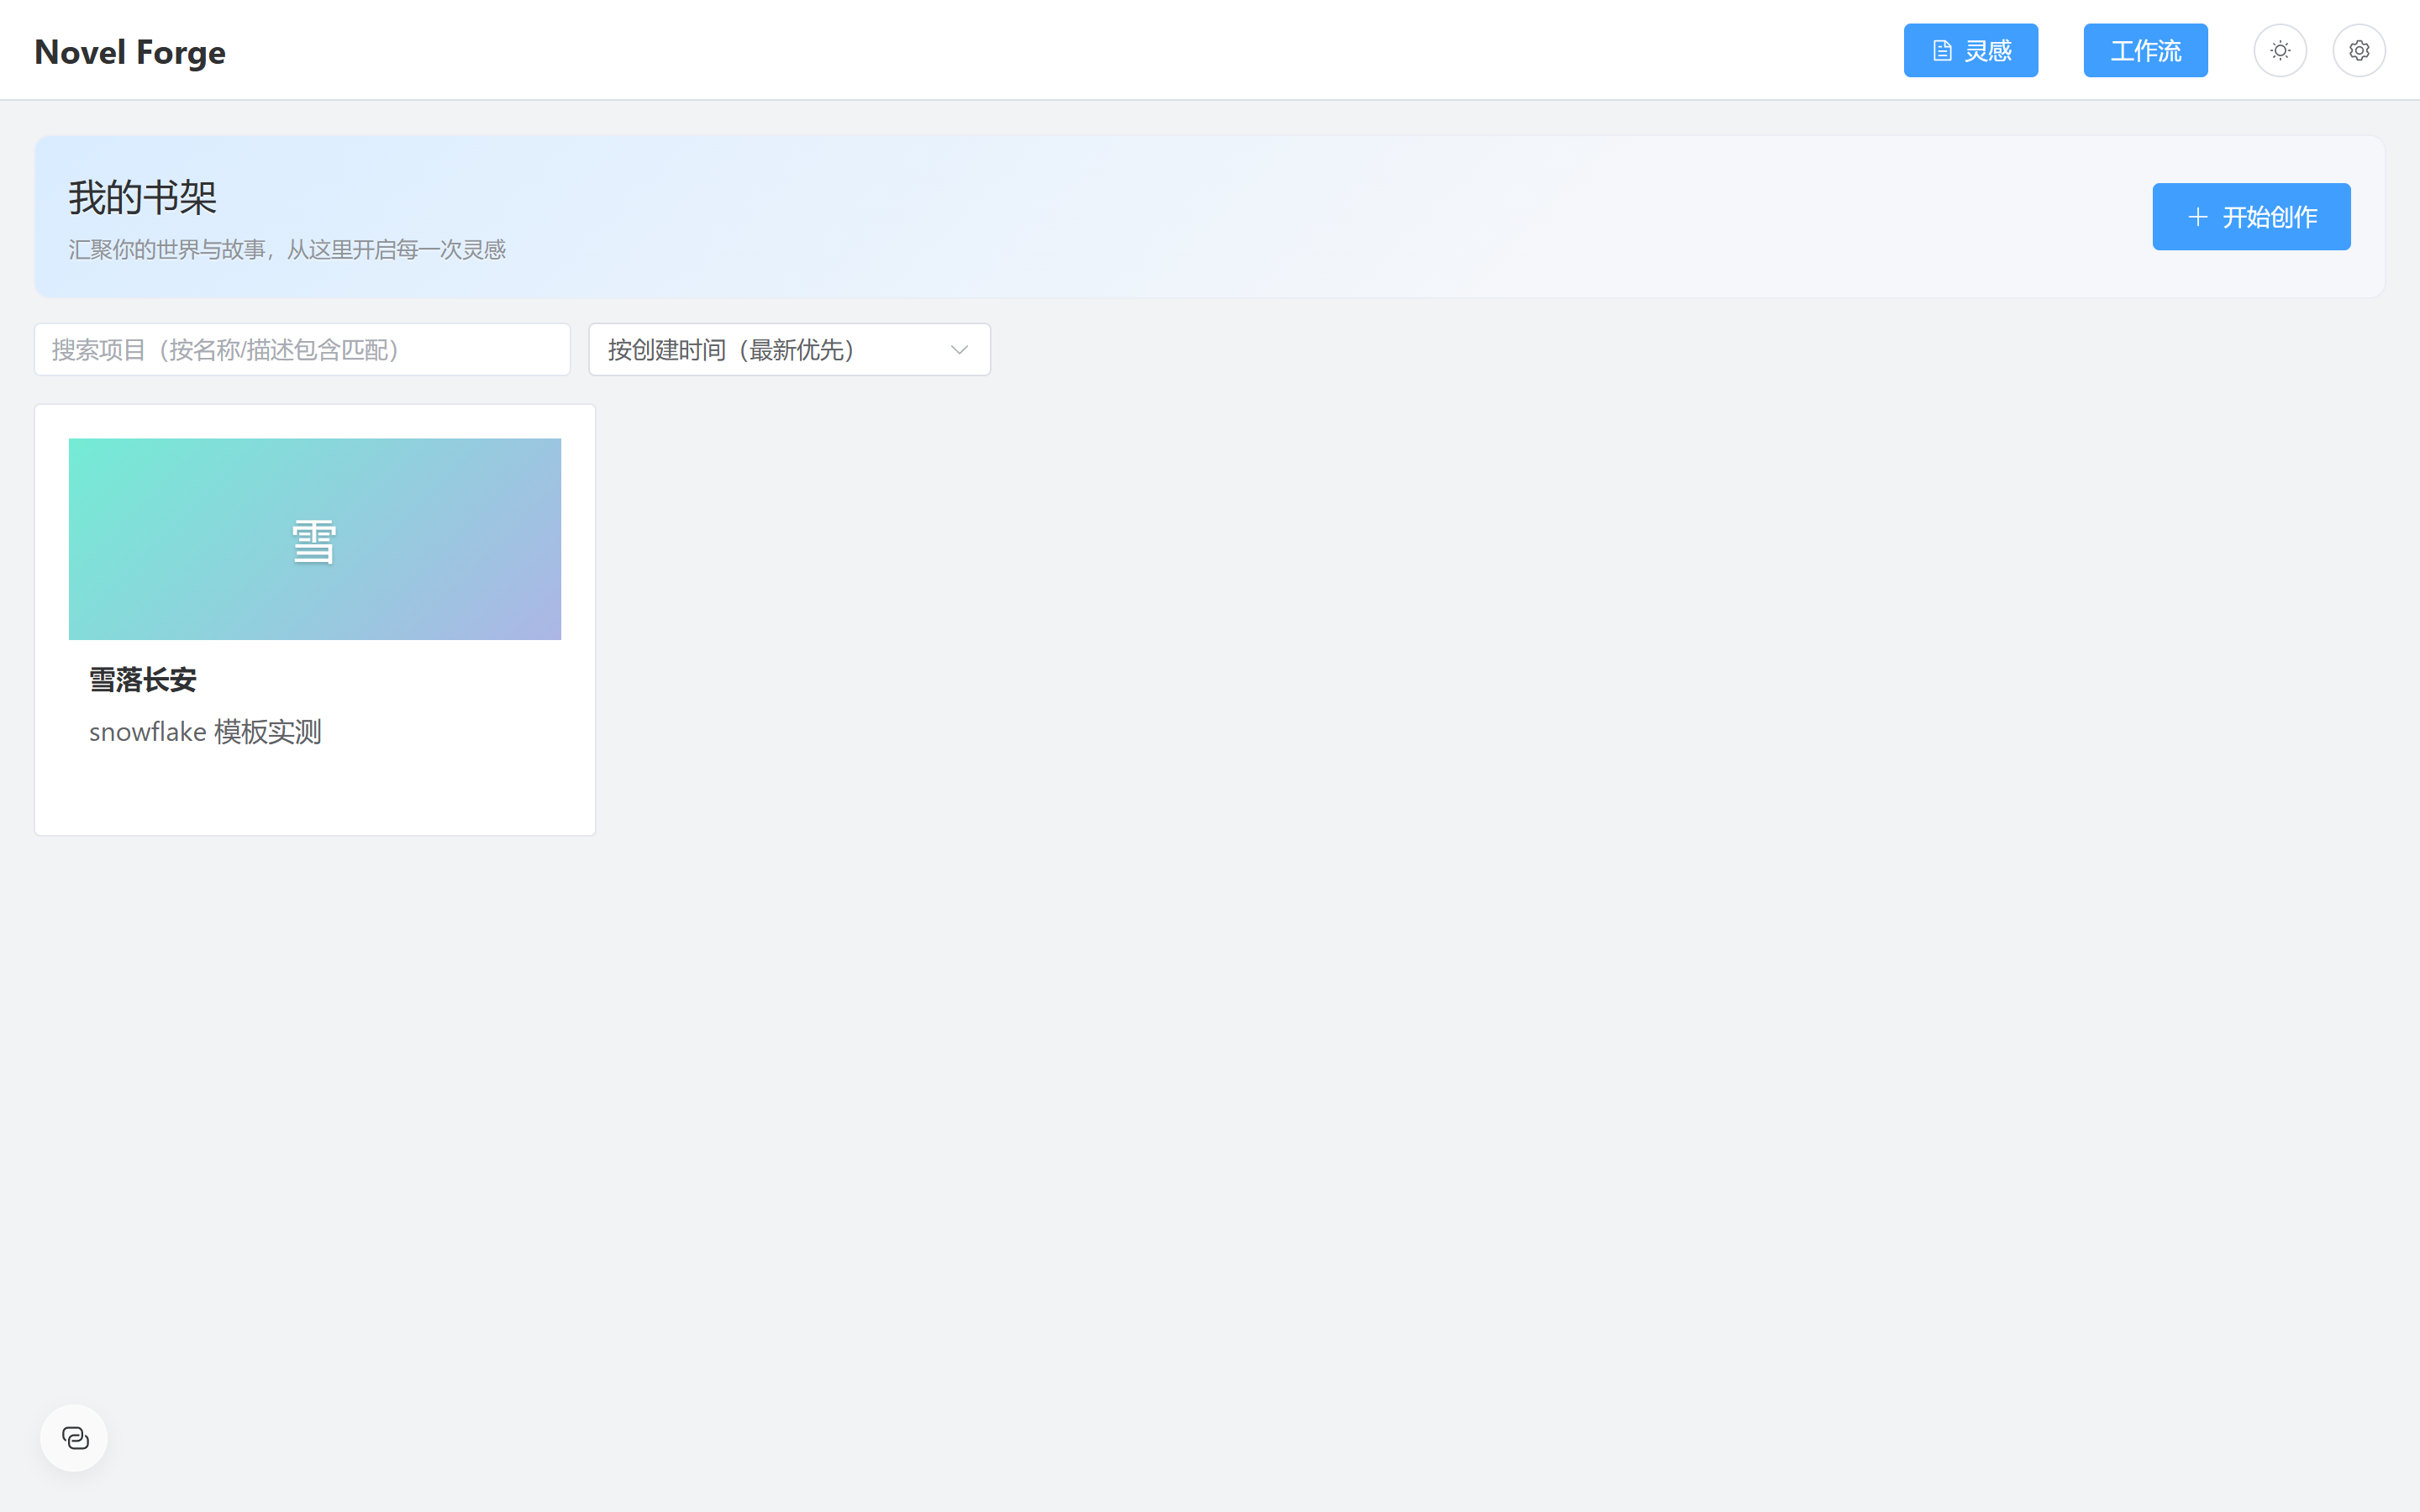
在 Windows 上用 venv 装 NovelForge 0.9.8,这套 AI 长篇小说写作工具的后端起来了,建出 11 张表,19 种卡片类型和 31 条提示词都进了库,7 个内置工作流一条没进去。
启动日志里 7 行都是同一句 Datetime values must have timezone information,装到的 sqlmodel 是 0.0.48。
NovelForge 0.9.8 装完怎么建出第一张卡片?
后端是 FastAPI 加 SQLite,前端是 Vue 加 Electron,两边分开装。数据全在 backend/novelforge.db 一个文件里,不装 Postgres 也能跑,知识图谱默认走 SQLite,Neo4j 是可选项。
cd NovelForge/backend
python -m venv ../nfenv
../nfenv/Scripts/python.exe -V        ->  Python 3.13.14
../nfenv/Scripts/python.exe -m pip install -r requirements.txt
cp .env.example .env
../nfenv/Scripts/python.exe main.py
装依赖花了 1 分 54 秒,requirements.txt 里列的是 fastapi、sqlmodel、langchain 和几个 provider 适配包。启动时跑一遍初始化器,提示词、卡片类型、知识库都成功,只有工作流那一步全挂。
| 命令 | 输出 | 耗时或退出码 |
|---|---|---|
| pip install -r requirements.txt | 无报错 | 1 分 54 秒 |
| python main.py | NovelForge 后端启动完成! | 退出码 0 |
| curl -X POST /api/projects/ | {"status":"success","data":{"name":"雪落长安","id":1}} | HTTP 200 |
库里的实际数量和界面上能看到的一致,只有工作流是 0。
表数量: 11
card | cardtype | foreshadowitem | kgrelation | knowledge | llmconfig
 | nodeexecutionstate | project | prompt | workflow | workflowrun

cardtype 19
prompt 31
workflow 0
openapi: 94 路径 | 131 schema
19 种卡片类型按写作流程排好了序,从立意一路排到成稿,最后三类放素材和通用内容。
| 阶段 | 卡片类型 |
|---|---|
| 立意 | 作品标签、金手指、一句话梗概 |
| 骨架 | 故事大纲、世界观设定、核心蓝图 |
| 分卷 | 分卷大纲、写作指南、阶段大纲 |
| 成稿 | 章节大纲、章节正文、内容审核卡片 |
| 素材 | 角色卡、场景卡、组织卡、物品卡、概念卡 |
| 通用 | 通用文本、文件夹 |
前端这条路不顺。npm install 跑到 6 分 36 秒被拦下来,node_modules 里有 685 个包、占 667 MB,.bin 目录是空的。
npm install  ->  6m 36s
npm error [safe-delete][SAFE_DELETE_BULK_CONFIRM_REQUIRED] {"count":50,"threshold":50,"scope":"turn"}
ls node_modules | wc -l  ->  685
du -sh node_modules      ->  667M
ls node_modules/.bin     ->  (空)
没有 bin 链接就跑不了 npm run dev:web,cross-env 会报找不到命令。绕过这一步直接调 vite 的入口即可,680 毫秒就绪。
VITE_APP_PLATFORM=web node node_modules/vite/bin/vite.js dev -c vite.config.web.ts
VITE v6.3.5  ready in 680 ms
Local: http://localhost:5173/
NovelForge 报 Datetime values must have timezone information 是什么原因?
第一次启动就报错,而且是每个 .wf 文件报一次。
grep -c "初始化工作流 .* 失败" backend.log  ->  7

2026-10-21 05:26:32.361 | ERROR | app.bootstrap.workflows:init_workflows:143
- 初始化工作流 世界观 失败: (builtins.ValueError) Datetime values must have timezone
information. Use datetime.now(timezone.utc), or annotate the field with NaiveDatetime
for naive storage.
[SQL: INSERT INTO workflow (name, description, dsl_version, is_built_in, is_active,
definition_code, is_template, template_category, keep_run_history, triggers_cache,
created_at, updated_at) VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)]
启动收尾还有一条清理任务报同一句错,它的 SQL 是 SELECT workflowrun.id FROM workflowrun WHERE workflowrun.finished_at < ?。
版本对不上是根因的一半。requirements.txt 里 sqlmodel 只写名字不写版本,装出来是 0.0.48。
pip show sqlmodel sqlalchemy pydantic
Name: sqlmodel    Version: 0.0.48
Name: SQLAlchemy  Version: 2.1.5
Name: pydantic    Version: 2.14.1
models.py 里时间字段两种写法混着用。Prompt 的 created_at 显式写了 sa_column=Column(sa.DateTime),所以提示词全部入库,没报错。剩下 6 张表用裸的 datetime = Field(default_factory=datetime.now),一共 14 处。
| 表 | 裸 datetime 字段 | 其中可空 |
|---|---|---|
| Workflow | 2 | 0 |
| WorkflowRun | 3 | 2 |
| NodeExecutionState | 4 | 2 |
| KGRelation | 2 | 0 |
| ForeshadowItem | 2 | 1 |
| Card | 1 | 0 |
| 合计 | 14 | 5 |
裸字段走 SQLModel 推断出来的类型,0.0.48 在绑定参数时要求值带时区;datetime.now 给的是不带时区的值,插入就抛 ValueError。显式写了 sa_column=Column(sa.DateTime) 的字段绕过这层校验,所以同一个文件里两种写法一个能写一个不能写。
models.py 里 14 个时间字段怎么改?
改法照抄 Prompt 表:给裸字段补上 sa_column=Column(sa.DateTime)。非空的顺带加 server_default,可空的只指定类型。
# 改之前
created_at: datetime = Field(default_factory=datetime.now, nullable=False)

# 改之后
created_at: datetime = Field(
    default_factory=datetime.now,
    sa_column=Column(sa.DateTime, nullable=False, server_default=sa.text("CURRENT_TIMESTAMP")),
)

# 可空字段
started_at: Optional[datetime] = Field(default=None, sa_column=Column(sa.DateTime))
批量脚本按非空、可空两种模式匹配,在 0.9.8 原始的 models.py 上跑一遍就替换完,输出两行。
替换非空: 9 替换可空: 5
语法 OK
删掉 novelforge.db 用空库重起一次,验证是不是这 12 处的问题。
2026-10-21 05:30:32.131 | INFO | 已创建内置工作流: 项目创建·雪花创作法 (id=7)
2026-10-21 05:30:32.256 | INFO | app.bootstrap.workflows:init_workflows:149
- 工作流初始化完成: +7, ~0, -0
2026-10-21 05:30:32.259 | INFO | NovelForge 后端启动完成!
ERROR 数: 0
9 + 5 = 14,跟前面按表数出来的 14 处对得上。修复前后差别只在字段声明,表结构没动,老的 db 文件也能直接用。
| 指标 | 修复前 | 修复后 | 差值 |
|---|---|---|---|
| workflow 表行数 | 0 | 7 | 7 - 0 = 7 |
| 启动报错行数 | 7 | 0 | 0 - 7 = -7 |
| 清理任务报错 | 1 | 0 | 0 - 1 = -1 |
NovelForge 的 7 个内置工作流都在哪、代码有多长?
7 个 .wf 文件放在 backend/app/bootstrap/workflows 下,启动时读出来写进 workflow 表的 definition_code 字段。
| 工作流 | 代码行数 | definition_code 字符数 | 硬编码 id |
|---|---|---|---|
| 世界观 | 44 | 884 | 0 |
| 分卷大纲 | 105 | 2255 | 0 |
| 拆书工作流 | 309 | 10263 | 2 |
| 核心蓝图 | 85 | 1775 | 0 |
| 辩论测试 | 86 | 2504 | 1 |
| 阶段大纲 | 70 | 2215 | 0 |
| 项目创建·雪花创作法 | 61 | 920 | 0 |
| 合计 | 760 | 20816 | 3 |
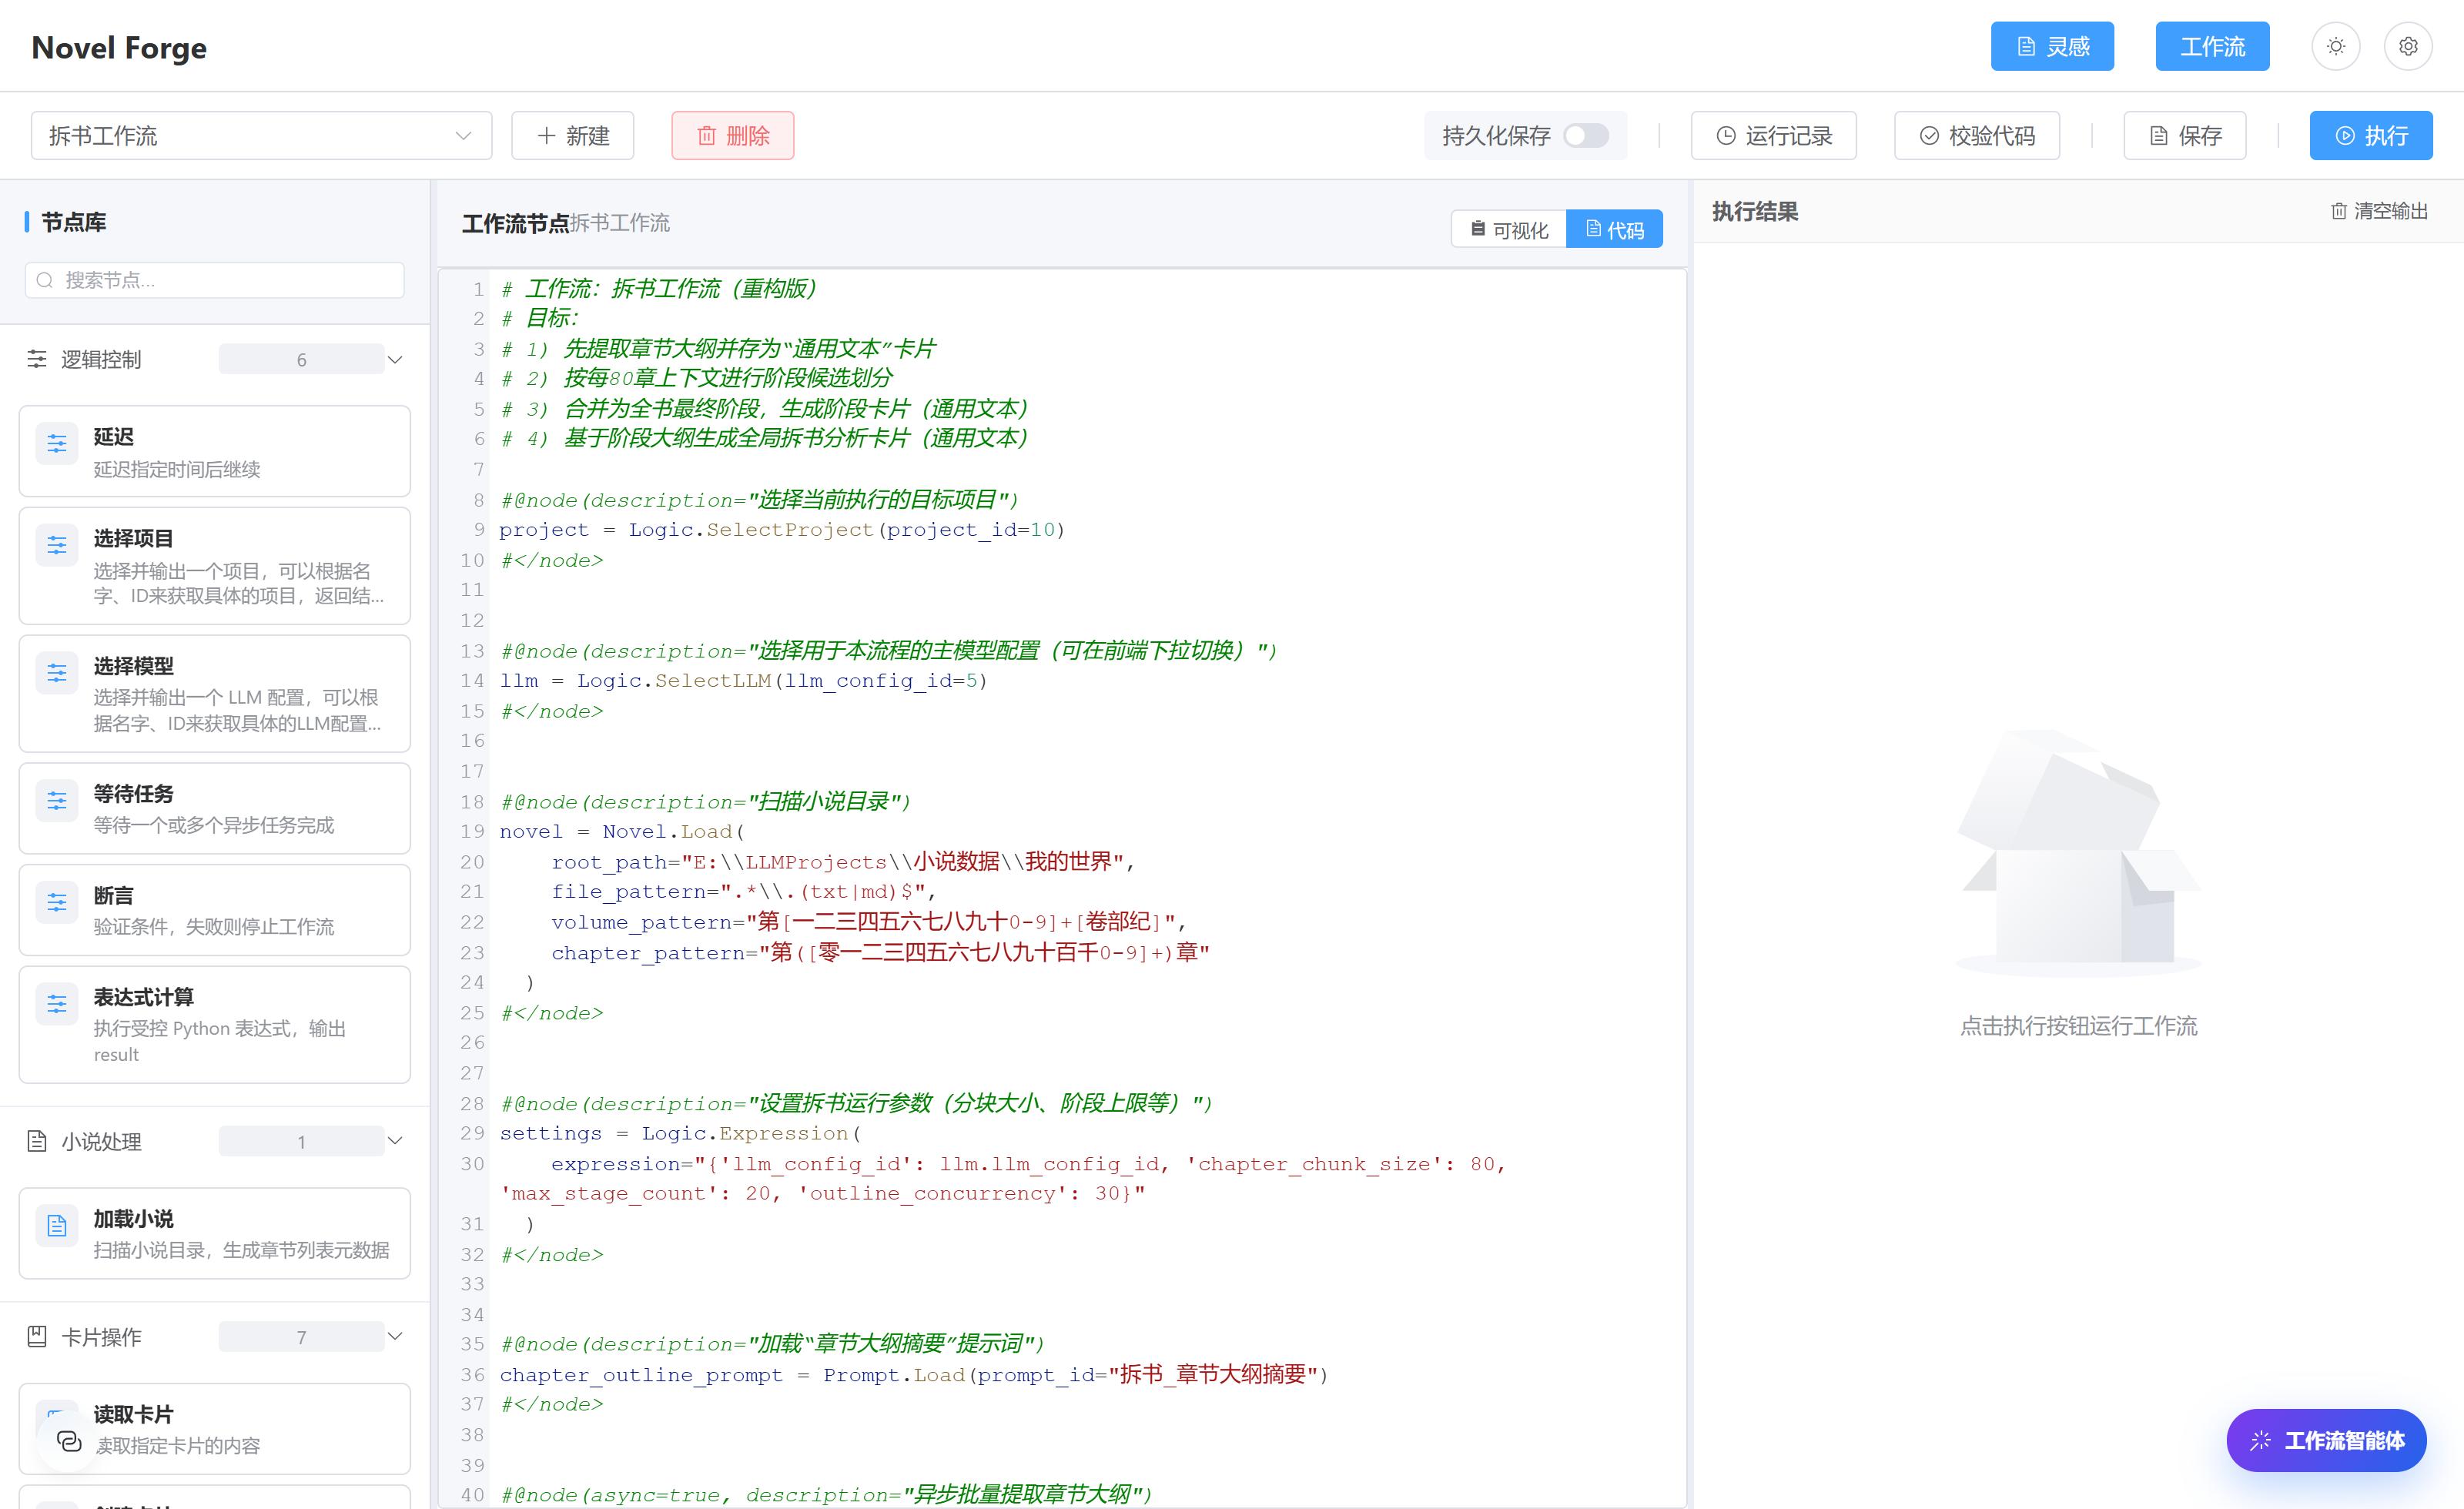
代码不是 JSON 配置,是带 #@node 标记的 Python 片段,标记之间的几行在解析后变成工作流节点。世界观那 44 行从触发器一路写到清空来源列表。
#@node(description="触发器:监听世界观设定卡片保存")
trigger = Trigger.CardSaved(card_type="世界观设定")
# ...

#@node(description="使用表达式节点提取组织列表")
organizations = Logic.Expression(
    expression="card.content.world_view.social_system.major_power_camps or []"
  )
# ...

#@node(description="批量创建组织卡片(父卡片为当前世界观卡片)")
org_cards = Card.BatchUpsert(
    project_id=trigger.project_id,
    parent_id=trigger.card_id,
    card_type="组织卡",
    title_template="{item.name}",
    items=organizations.result
  )
# ...
最后一步是 Card.Update,把 major_power_camps 清空,这样卡片第二次保存时不会重复建一遍组织卡。工作流编辑器里的节点库按用途分 7 组,一共 24 个节点。
| 节点分组 | 数量 | 代表性节点 |
|---|---|---|
| 卡片操作 | 7 | Card.Read、Card.Create、Card.BatchUpsert |
| 逻辑控制 | 6 | Logic.Expression、Logic.Assert、Logic.SelectLLM |
| AI 生成 | 5 | AI.StructuredGenerate、AI.Debate |
| 触发器 | 2 | Trigger.CardSaved、Trigger.ProjectCreated |
| 示例节点 | 2 | Example.Process、Example.BatchProcess |
| 小说处理 | 1 | Novel.Load |
| 数据处理 | 1 | Prompt.Load |
| 合计 | 24 |
卡片生成的约束来自后端 pydantic 模型,31 个响应模型序列化后合计 28198 字节、146 个字段。
schema                         字节   字段   必填
CharacterCard                3048   11    7
VolumeOutline                2639   10    8
Blueprint                    2513    5    5
ReviewResultCardContent      1770   13    8
StageLine                    1593    8    8
ChapterOutline                904    6    6

总字节: 28198  平均: 910  字段总数: 146  模型数: 31
用 template=snowflake 和空白项目建出来差多少?
工作流不是建完项目就自动跑,要看触发条件。项目创建事件对应的触发器写在 workflow.triggers_cache 里,只有匹配到 snowflake 才动。
{"event": "project.created", "match": {"template": "snowflake"}}不带 template 建项目,日志只有一行,卡片库里是空的。
[工作流触发] project.created - 空白项目,不触发工作流
GET /api/projects/1/cards  ->  卡片数: 0
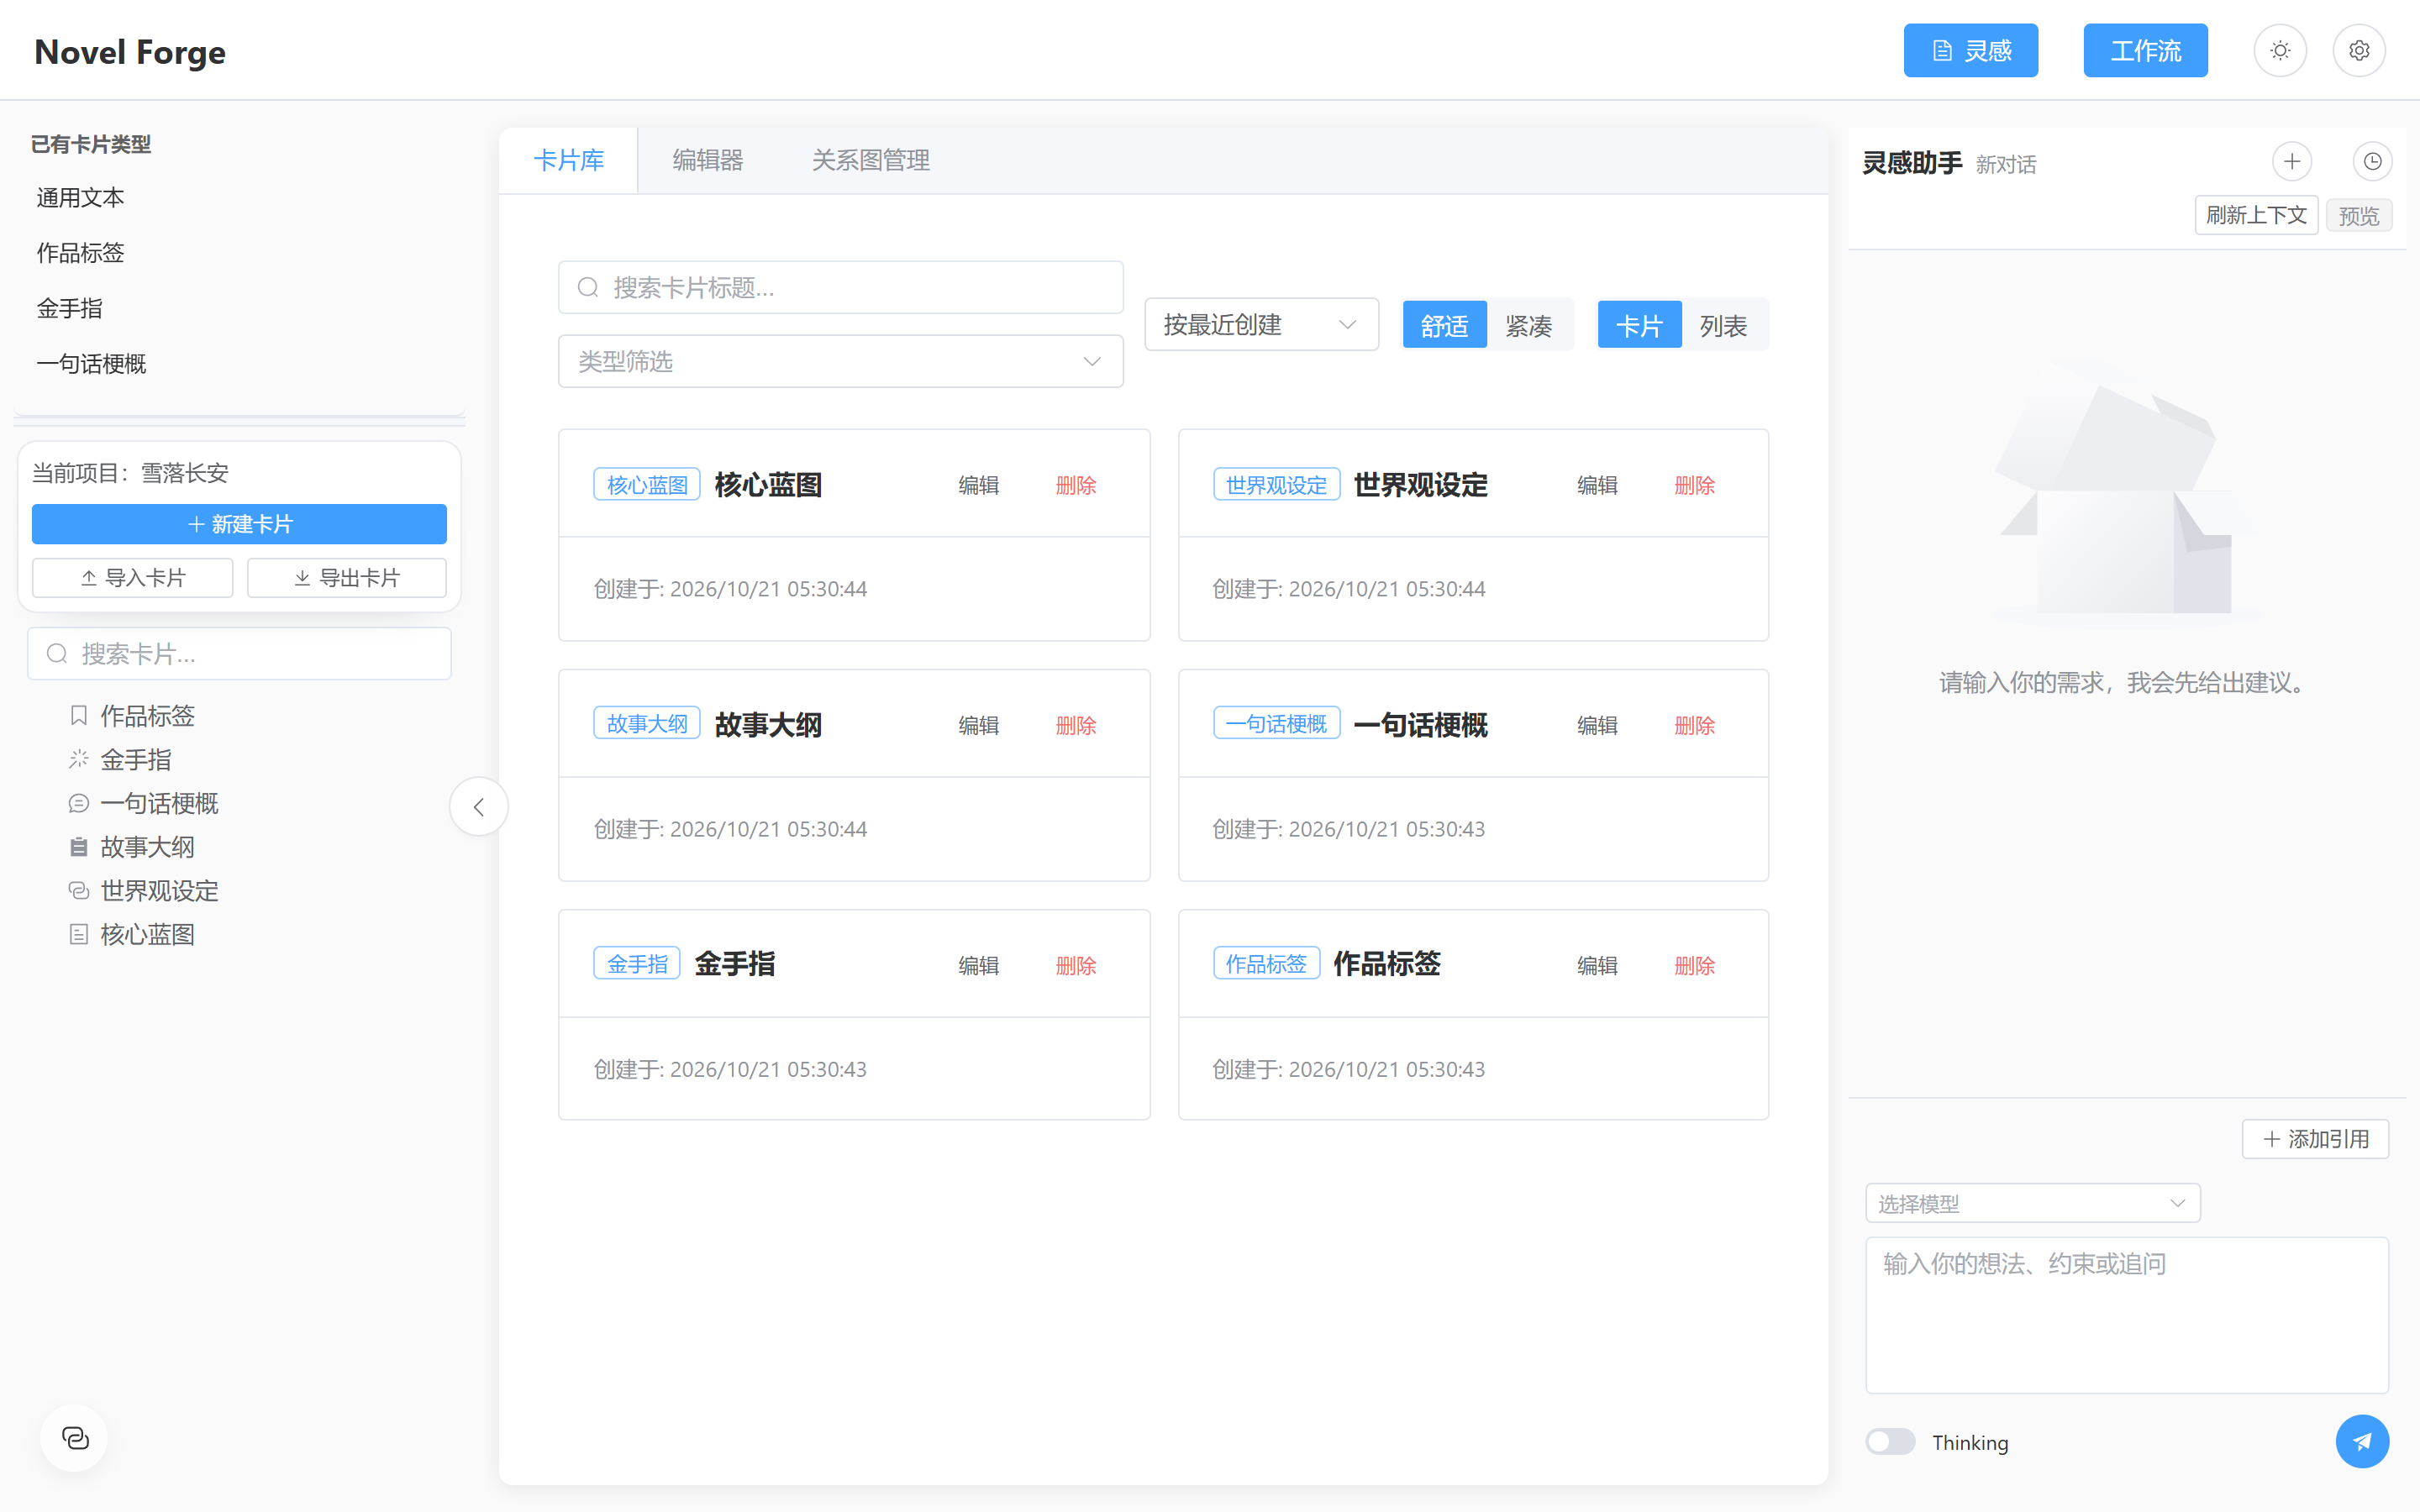
带 template=snowflake 再建一次,雪花创作法工作流被触发,自动落 6 张卡。
POST /api/projects/  {"name":"雪落长安","template":"snowflake"}
-> {"status":"success","data":{"name":"雪落长安","id":1}}

卡片数: 6
 1 作品标签
 2 金手指
 3 一句话梗概
 4 故事大纲
 5 世界观设定
 6 核心蓝图
同样的请求在修复前是 500,因为触发工作流要先写一条运行记录进 workflowrun 表,而那张表的 3 个时间字段都是裸字段。
sqlalchemy.exc.PendingRollbackError: This Session's transaction has been rolled back
due to a previous exception during flush.
Original exception was: (builtins.ValueError) Datetime values must have timezone information.
[SQL: INSERT INTO workflowrun (workflow_id, definition_version, status, scope_json,
params_json, idempotency_key, state_json, error_json, max_execution_time, created_at,
started_at, finished_at, summary_json) VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)]| 建法 | 结果 | 卡片数 |
|---|---|---|
| 空白项目(不带 template) | 日志「空白项目,不触发工作流」 | 0 |
| template=snowflake,修复前 | 500 Internal Server Error | 0 |
| template=snowflake,修复后 | success | 6 |
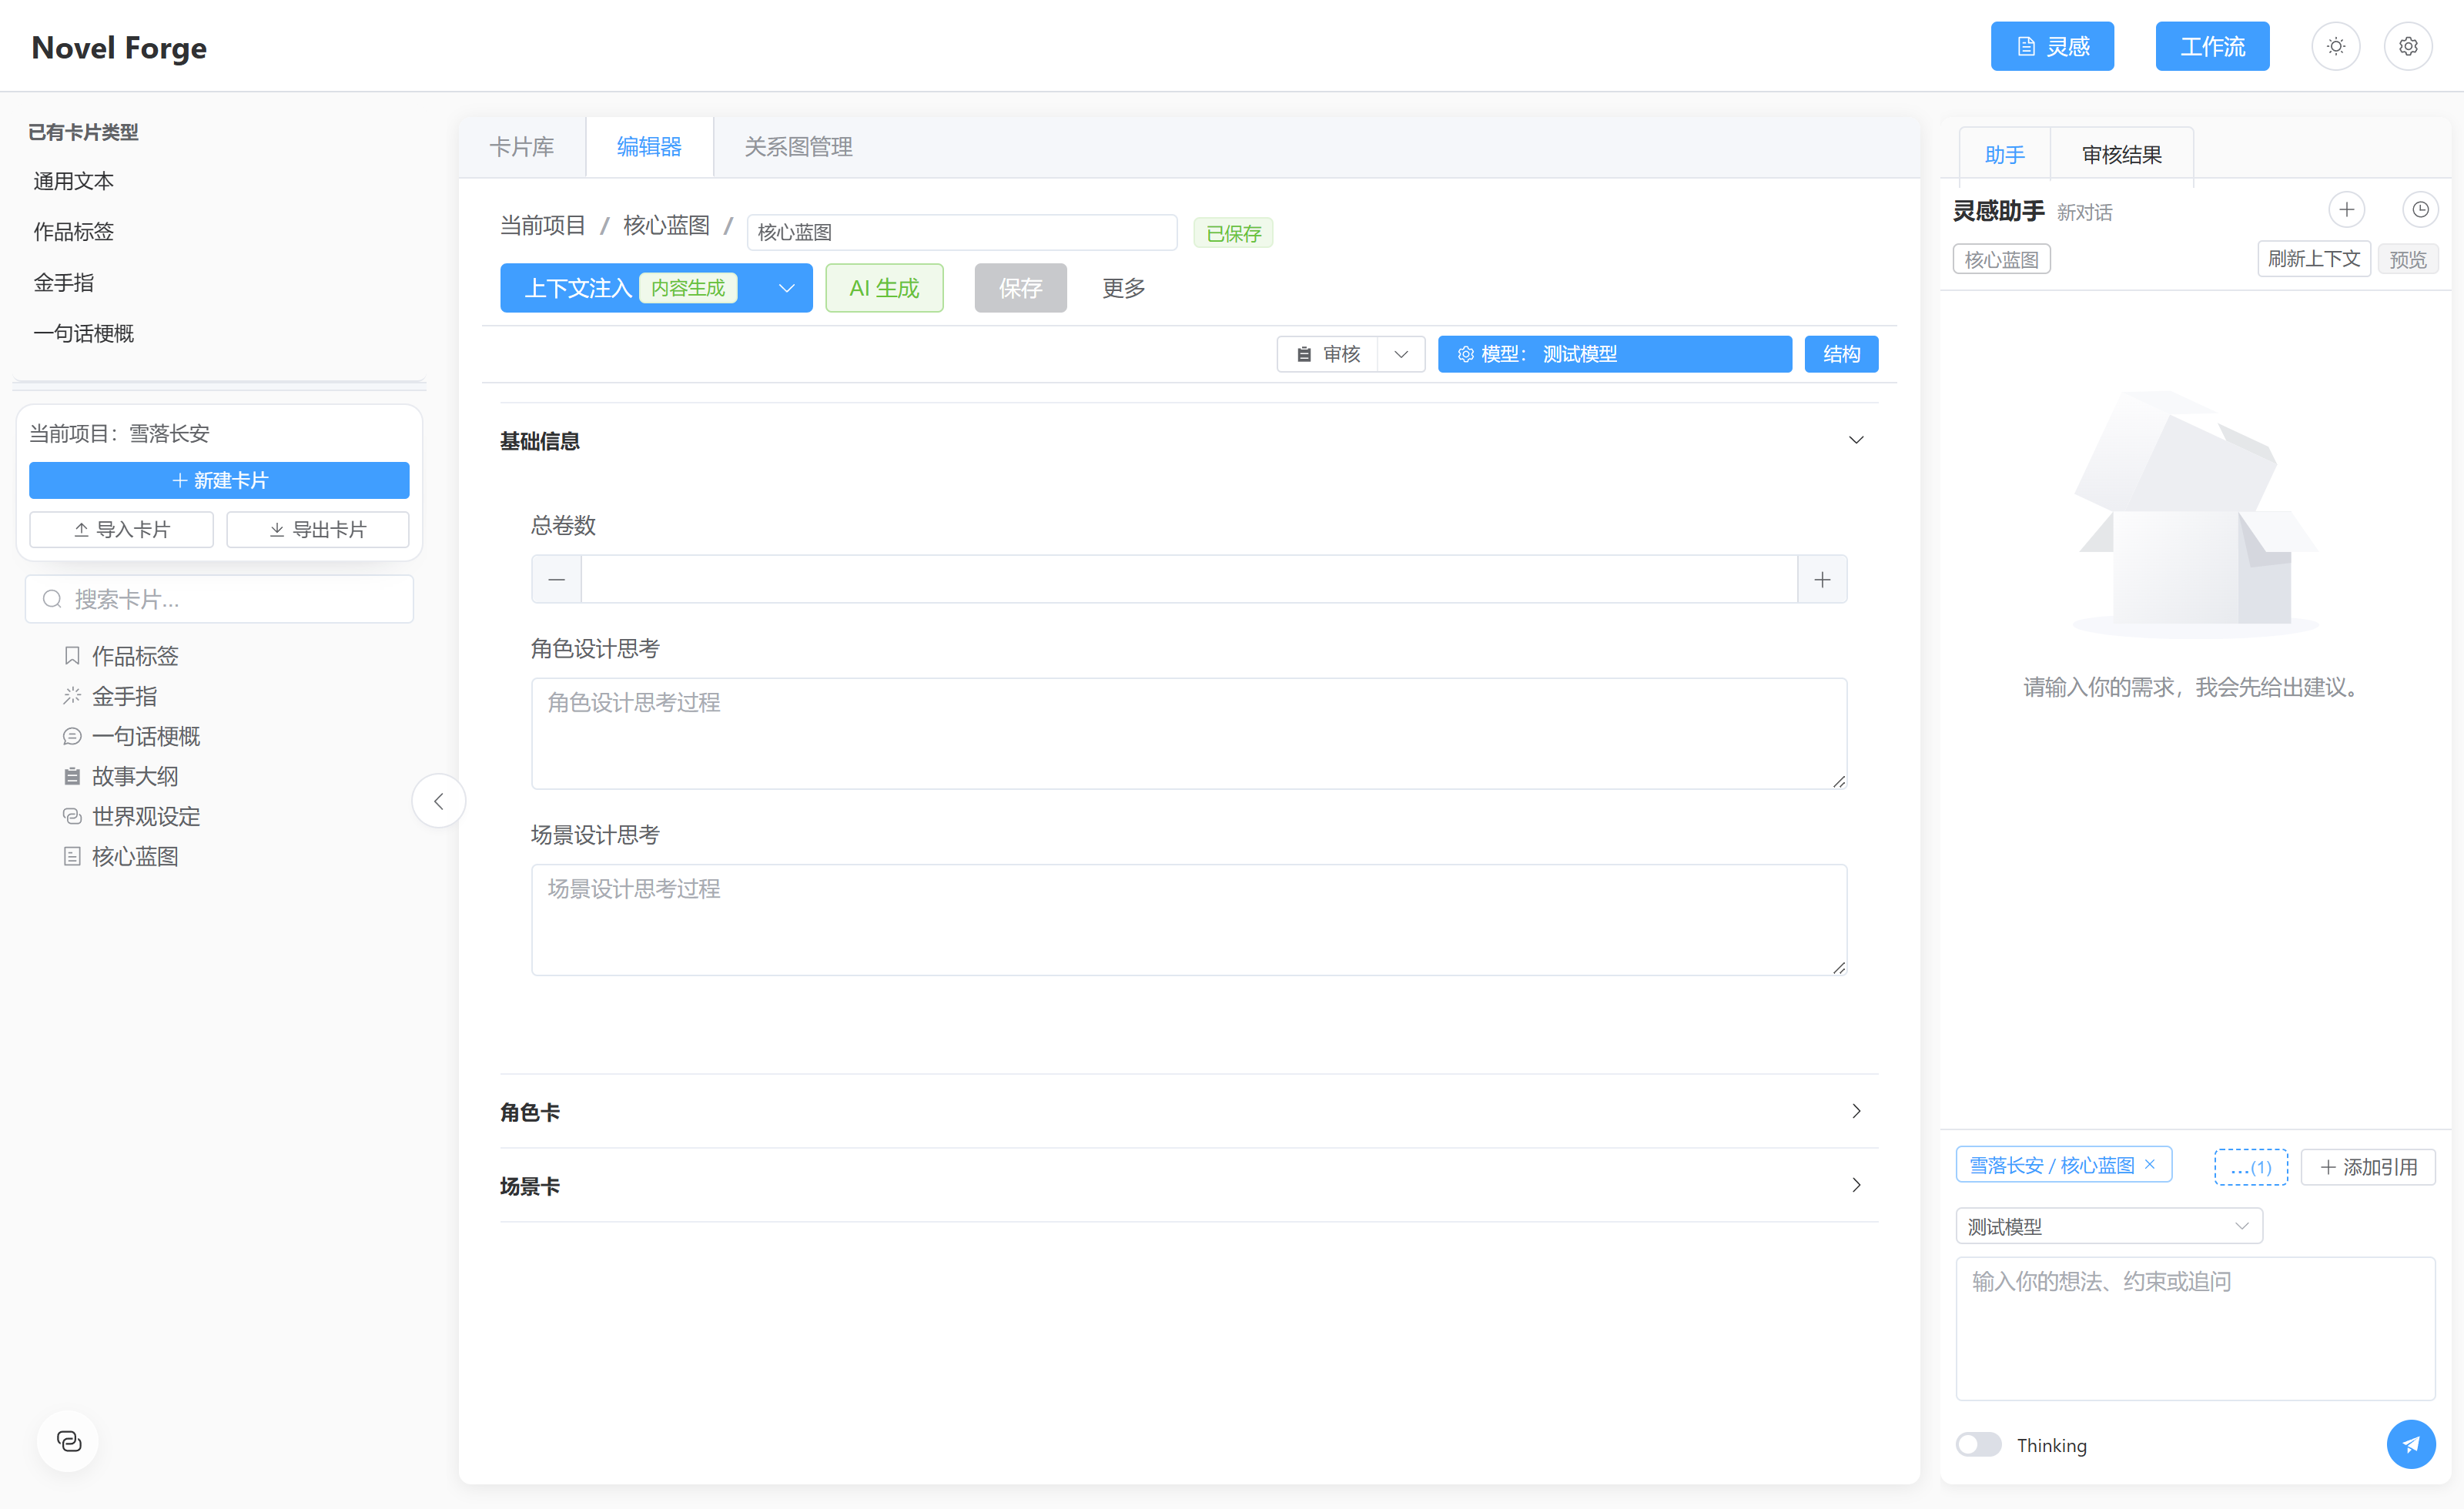
这 6 张卡是空的骨架,字段按各自 schema 渲染出来。核心蓝图的编辑器里能看到总卷数、角色设计思考、场景设计思考三组字段,角色卡和场景卡是折叠的子表。
NovelForge 校验通过的拆书工作流为什么跑不起来?
内置工作流里写死了作者自己环境的 id,只有跟着触发器走的那几个不用改。
拆书工作流        project_id=10(第 8 行)  llm_config_id=5(第 14 行)   硬编码 2 处
辩论测试          project_id=11(第 14 行)                              硬编码 1 处
世界观/分卷大纲/核心蓝图/阶段大纲/项目创建    用 trigger.project_id    硬编码 0 处
7 个文件合计                                                          硬编码 3 处
点校验代码会返回干净结果,因为校验只查节点名和语法,不查这些 id 在库里存不存在。
POST /api/workflows/3/validate
{"is_valid":true,"errors":[],"warnings":[]}
真跑起来第一步就停。
GET /api/workflows/3/execute-stream
{"type": "error", "statement": {"variable": "project",
 "code": "Logic.SelectProject(project_id=10)", "line": 8},
 "error": "项目不存在: id=10, name=None"}

GET /api/workflows/5/execute-stream
{"type": "error", "error": "项目不存在: id=11, name=None", "message": "工作流执行失败"}

SELECT id FROM project  ->  1
这次只建过 1 个项目,id 是 1,10 和 11 都查不到。拆书工作流第 14 行还有 Logic.SelectLLM(llm_config_id=5),llmconfig 表里原本是空的,配上模型之后才有 1 行,id 也是 1。
其余几个工作流的 project_id 都写成 trigger.project_id,llm_config_id 写成 settings.result.llm_config_id,跟着触发上下文走,换个项目不用改代码。
NovelForge 在什么条件下会失败?
四种情况会直接失败,都来自这次实际碰到的报错。
| 触发条件 | 现象(报错原文) | 对应步骤 |
|---|---|---|
| requirements.txt 不锁 sqlmodel 版本 | Datetime values must have timezone information | 首次启动 |
| 只改 workflow 表,没改 workflowrun | PendingRollbackError,接口返回 500 | 用 snowflake 建项目 |
| 直接跑拆书工作流 | 项目不存在: id=10, name=None | 执行工作流 |
| 直接跑辩论测试 | 项目不存在: id=11, name=None | 执行工作流 |
只在 Windows、Python 3.13.14 的 venv 里用 main.py 启动测过,没在 macOS、Linux、Docker 里复测。
- 未验证:接上模型后一张卡能生成多少字。前置卡片为空时,卡片编辑器的 AI 生成按钮是灰的,没有跑出生成结果。
- 未验证:各类卡片里的正文编辑器和审核卡片联动。只验证了建卡、schema 渲染和字段表单。
- 未验证:Electron 桌面版。只用 vite 起了浏览器版本,打包产物没测。
- 未验证:关系图谱。kgrelation 表建好了,但没往里写过数据。
如果你打算直接用发布版 exe,本文的依赖版本和 sqlmodel 相关结论不能照搬,那条路径没有测。