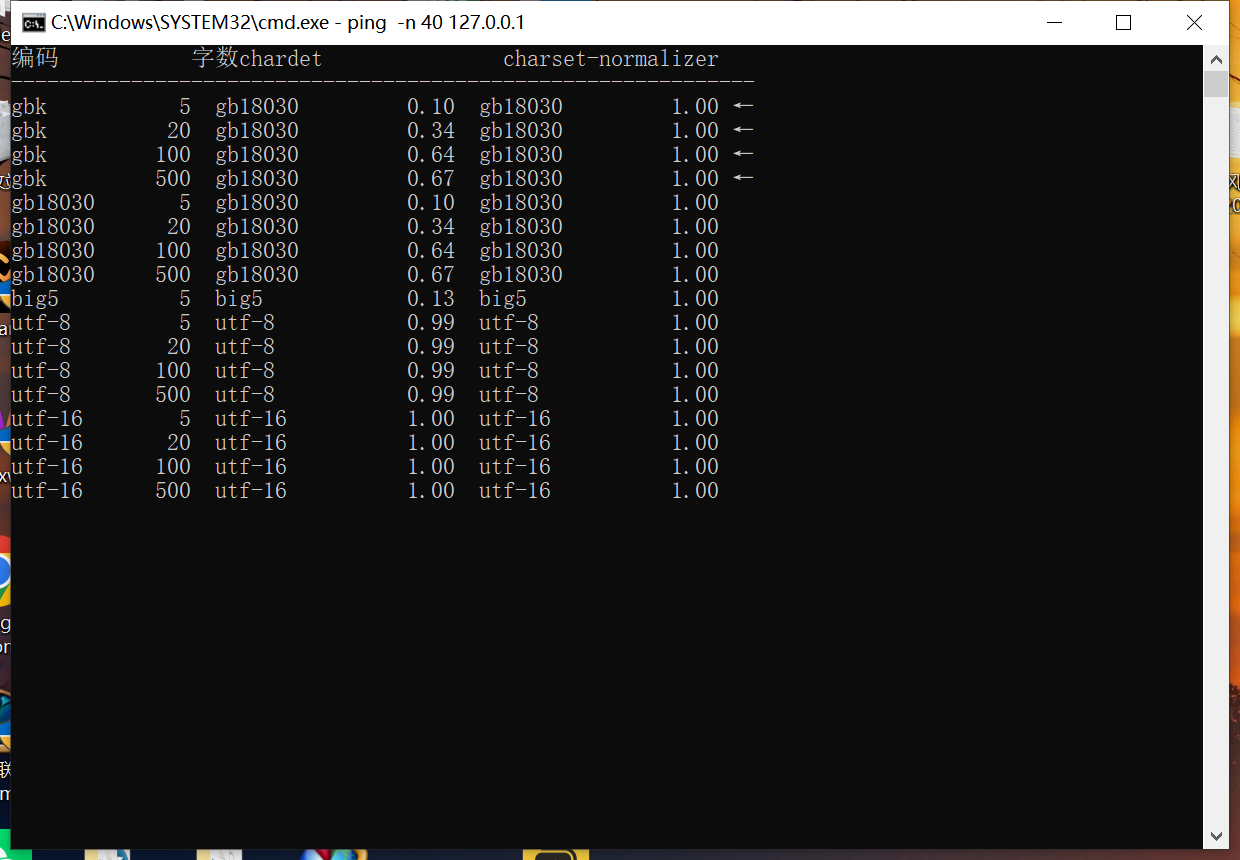
拿同一批数据喂给 chardet 7.7.0 和 charset-normalizer 3.5.2,两者给出的编码判断完全一致,但置信度的含义完全不同。
chardet 的置信度随样本变长而上升:同样是 GBK 文本,5 个字时 0.10,500 个字升到 0.67。charset-normalizer 无论给多少字,永远是 1.00。
前者的数字能用来判断「该不该信」,后者的数字不能。差别就在这里。
两边的判定结果一致吗
一致。五种编码、四种长度,两个库给出的编码名全部相同:
| 真实编码 | 字数 | chardet 判定 | 置信度 | charset-normalizer 判定 | 数值 |
|---|---|---|---|---|---|
| GBK | 5 | gb18030 | 0.10 | gb18030 | 1.00 |
| GBK | 20 | gb18030 | 0.34 | gb18030 | 1.00 |
| GBK | 100 | gb18030 | 0.64 | gb18030 | 1.00 |
| GBK | 500 | gb18030 | 0.67 | gb18030 | 1.00 |
| Big5 | 5 | big5 | 0.13 | big5 | 1.00 |
| UTF-8 | 任意 | utf-8 | 0.99 | utf-8 | 1.00 |
| UTF-16 | 任意 | utf-16 | 1.00 | utf-16 | 1.00 |
GBK 被判成 gb18030 不算错:GB18030 是 GBK 的超集,用它解码 GBK 的字节不会出问题。反过来说,如果你必须知道原始文件到底是 GBK 还是 GB18030 写的,这套检测给不出答案,只能自己按业务约定判断。
为什么要看置信度
因为编码判断本身是概率问题。同一串字节可能有好几种合法解读,库只能挑一个最像的。
chardet 把「有多像」用置信度表达出来。GBK 那四行的差别最清楚。
- 5 个字 → 0.10:置信度只有 0.10
- 20 个字 → 0.34:置信度 0.34
- 100 个字 → 0.64:可用
- 500 个字 → 0.67:稳定在这个区间,不再往上走
500 字也只有 0.67,说明 GBK 和 GB18030 在字节层面本来就难以区分,不是样本不够的问题。
反过来看 UTF-8 和 UTF-16:不管几个字,0.99 和 1.00。这两类编码的字节特征固定,几乎没有第二种解读。
1.00 这个数字可信吗
不能当可靠度用。
charset-normalizer 返回的 1.00 是「1 减去 chaos 值」算出来的。它这套指标衡量的是解码后文本的混乱程度,不是「有多少把握是这个编码」。
证据就是那行 Big5:5 个字符的样本,chardet 只给 0.13(置信度低),charset-normalizer 给 1.00。同一个样本,一个给 0.13,一个给 1.00。后者这个 1.00 不能用来判断可靠性。
要用 charset-normalizer 判断可靠性,应该看它返回的其他字段(比如 `could_be_from_charset` 里的候选列表),而不是那个 chaos 反算值。
短文本该怎么处理
基于上面的数据,短文本(100 字以下)的编码判断不可靠,尤其 GBK 系。可行的做法是:
- 先按最可能的编码解一次,检查有没有替换字符(U+FFFD)或异常控制字符
- 解出来的文本能正常显示、标点没有乱码,就接受
- 解不了再换下一个候选,别只看返回值
- GBK 系优先试 GB18030,它是超集,能覆盖 GBK 的全部字节
100 字以上、且 chardet 置信度过 0.6 的,可以直接采用。
混进乱码会怎样
我用 GBK 数据后面接了两个字节 `\xff\xfe`,结果 chardet 返回 KOI8-R(俄语编码),置信度 0.00。
文本主体明明是中文,它给的是不着边的答案。这种数据在断点续传、文件拼接出错时很常见,说明置信度 0.00 是有意义的信号:当它给 0 的时候,结果基本不用看。
装的时候要注意源
清华镜像装不了这个包,报「找不到任何版本」。查下来不是包没同步:镜像返回的索引格式是 `repository-version 1.0`,官方源是 `1.4`,老格式缺 `requires-python` 字段,pip 26 就把所有版本判成不兼容。
换官方源即可:
pip install -i https://pypi.org/simple chardet4 秒装完,版本 7.7.0。同样的问题今天在 cn2an、glances、jieba 上也遇到了,规律是同一类。