loguru 是标准库 logging 的替代品,卖点是「不用配置」:导入就有一个能直接用的 logger,彩色输出、文件轮转、异常追踪全都预置好。标准库要实现同样效果,得写二三十行 handler 和 formatter 的配置。
标准库要配置,它不用
用标准库往文件写日志,最少这几步:
logger = logging.getLogger("app")
logger.setLevel(logging.INFO)
handler = logging.FileHandler("app.log", encoding="utf-8")
handler.setFormatter(logging.Formatter("%(asctime)s | %(levelname)s | %(message)s"))
logger.addHandler(handler)
这还只是「能写文件」。要彩色控制台、要按天切分、要异常追踪带变量值,还得再叠几个 handler 和自定义 formatter。
loguru 的写法是一行:
from loguru import logger
logger.add("app.log", format="{time} | {level} | {message}")
logger.info("用户 {} 登录", uid)导入即用,什么都不配也能往控制台输出带颜色的日志。{} 占位符风格和标准库的 %s 类似,都是延迟格式化。
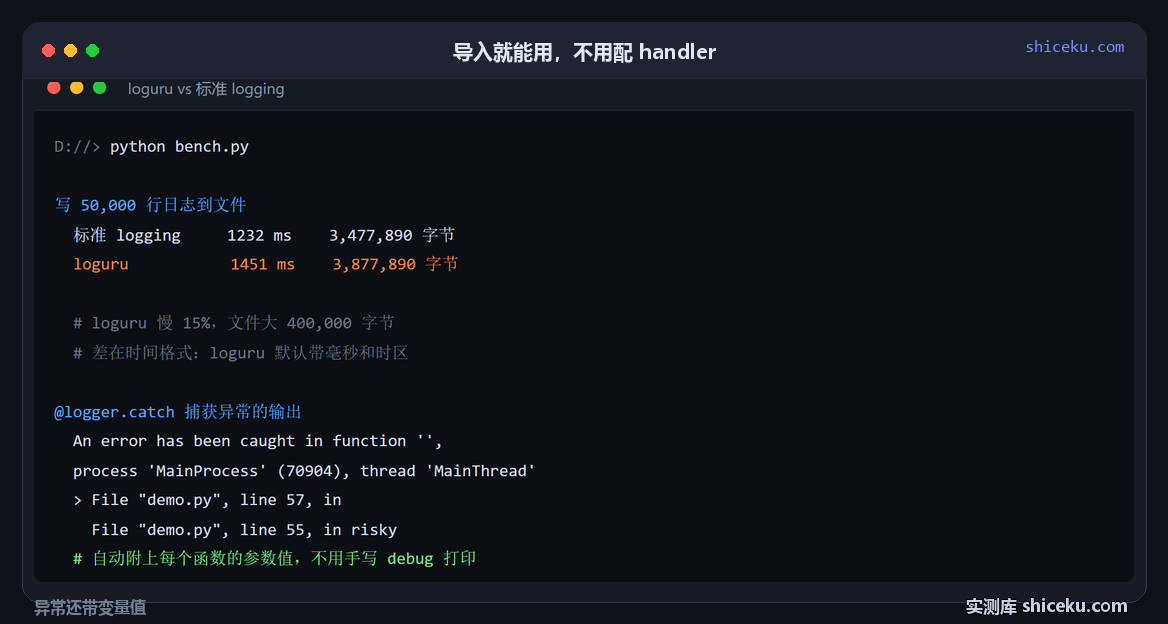
50,000 行:慢 15%,文件大 40 万字节
| 方案 | 写 5 万行耗时 | 文件大小 |
|---|---|---|
| 标准 logging | 1232 毫秒 | 3,477,890 字节 |
| loguru | 1451 毫秒 | 3,877,890 字节 |
慢 219 毫秒,约 15%。这个差距来自它的额外处理:每行都要走一遍 {} 模板解析、彩色标记处理、额外的调用栈信息收集。
文件大了 400,000 字节,平均每行多 8 字节。原因在时间格式:标准库的 %(asctime)s 输出 2026-10-22 22:05:31,123 这种,loguru 默认带时区和更完整的精度,字符数更多。这个差异会随日志量线性放大,一天百万行就是 8 MB 的差距。
值钱的是异常追踪
标准库的 traceback 只有调用栈,遇到 KeyError 你不知道是哪个键、遇到 ZeroDivisionError 你不知道除数和被除数是多少,只能回头加 print 重跑。
loguru 的 @logger.catch 装饰器在捕获异常时会附上每个栈帧里所有局部变量的值:
@logger.catch
def risky(a, b):
    return a / b

risky(10, 0)
输出里除了调用栈,还有 a = 10、b = 0 这样的变量快照。排查线上问题时这一个特性省下的时间,远超那 15% 的性能损失。
它默认还会把异常写到一个独立的地方(如果配置了 sink),不会混在普通日志里被其他输出冲掉。
轮转和保留策略是内置的
标准库要自己做日志轮转,通常得引入 logging.handlers.RotatingFileHandler 或 TimedRotatingFileHandler,配置参数、处理边界情况(比如跨天时的文件句柄切换)。
loguru 的 add() 直接接受策略参数:
logger.add("app.log", rotation="10 MB", retention="7 days", compression="zip")这一行同时管了三件事:超过 10 MB 就切新文件、只保留 7 天、旧的自动压成 zip。压缩是后台线程做的,不阻塞主流程。
什么时候别用它
已经在用标准库、配置跑得挺好的项目,别为了「少写几行」重写日志层。日志是全局性的东西,换实现意味着所有模块的 import 都要改,风险大于收益。
对日志性能极敏感的场景(比如每秒几万条的高频写入),标准库配合队列 handler 更稳。loguru 也有 enqueue=True 把写入放到后台线程,但多一层封装就多一层不可控因素。
还有一点:它的默认 sink 是 stderr,不是 stdout。有些容器环境只收集 stdout,直接用会发现日志「不见了」,要显式 logger.add(sys.stdout)。这个坑在第一次上容器时几乎必踩。
还有一个细节值得提:它的 bind() 可以给 logger 挂上下文,所有后续日志自动带上。做 Web 服务时把 request_id 绑上去,一条链路的所有日志都能串起来查:
log = logger.bind(request_id="abc123")
log.info("开始处理")   # 自动带上 request_id=abc123
标准库要实现同样效果,得用 LoggerAdapter 或者自定义 Filter 往每条记录里塞 extra 字段,还要在 formatter 里声明占位符,三步都不能少。
没测的部分列一下,3 项:enqueue 模式的实际吞吐 / 多进程写入的冲突行为 / 与 structlog 的横向对比。