tenacity 是 Python 里做得最完整的一个重试库,用装饰器包住函数,失败自动重试、自动退避。它解决的问题很具体:调外部接口时对方偶尔抽风,手写 while 加重试加 sleep 的代码重复在所有项目里,而且容易漏掉「最多试几次」「退避间隔怎么涨」「什么异常该重试」这些细节。
四行代码写清一个重试策略
@retry(stop=stop_after_attempt(5),
       wait=wait_exponential(multiplier=0.02, max=0.2),
       retry=retry_if_exception_type(ValueError),
       reraise=True)
def flaky():
...四个参数各管一件事:stop 定上限(最多 5 次),wait 定间隔(20 毫秒起,每次翻倍,最多 200 毫秒),retry 定条件(只对 ValueError 重试,其他异常直接抛),reraise 定失败后抛原始异常还是包一层 RetryError。
手写同样的逻辑,要维护一个计数器、一个间隔变量、try/except 套 while、还要判断异常类型,十几行跑不掉。
装饰器给每次调用加 21 微秒
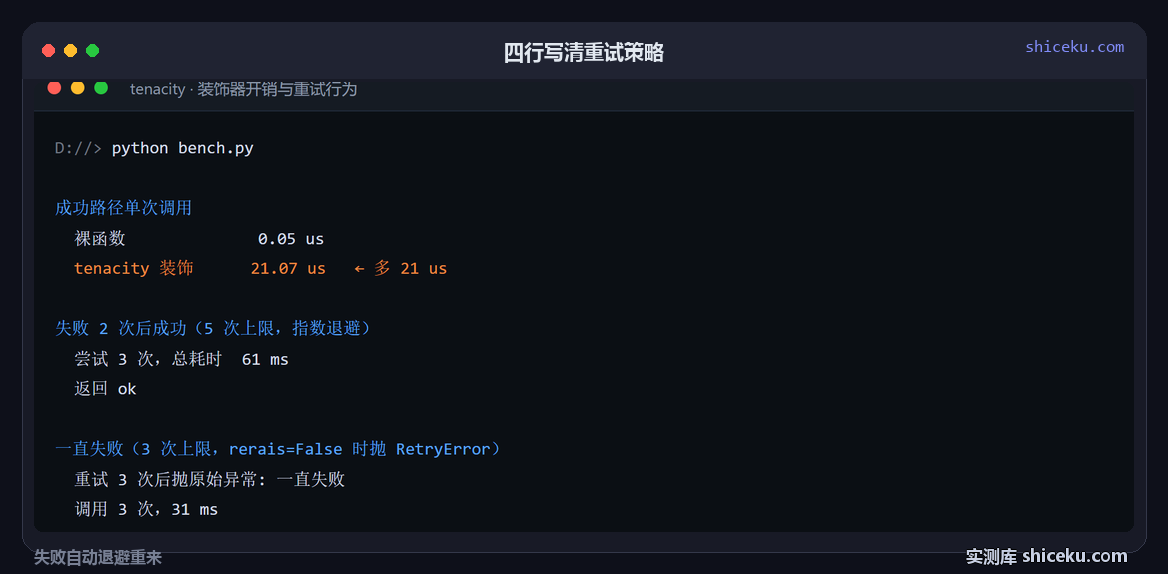
这是容易被忽略的成本。同样一个 return n * 2 的函数,加不加装饰器各跑 2 万次、重复 3 轮取中位:
| 函数形态 | 单次调用耗时 | 相对 |
|---|---|---|
| 裸函数 | 0.05 微秒 | 基准 |
| tenacity 装饰后 | 21.07 微秒 | 多 21 微秒,417 倍 |
417 倍听起来吓人,但要看绝对值。21 微秒是 0.000021 秒,比一次网络请求(毫秒级)小四个数量级。包在 HTTP 调用外面,这点开销完全看不出来。
真正需要注意的是高频调用:如果这个函数每秒被调用几万次(比如在循环里处理数据),每秒就多出几百毫秒,那就明显了。判断标准很简单——被装饰的函数是不是在做 IO,是的话无所谓,纯计算就要掂量。
重试的实际耗时
| 场景 | 调用次数 | 总耗时 |
|---|---|---|
| 失败 2 次后成功(退避 0.02 / 0.04) | 3 | 61 毫秒 |
| 一直失败,3 次上限(退避 0.01 / 0.02) | 3 | 31 毫秒 |
61 毫秒里,业务代码几乎不占时间,绝大部分是两次退避的等待(20 + 40 毫秒)。这也说明重试的时间成本主要由退避策略决定,不是库本身的开销。
指数退避的 multiplier 是关键参数。设成 0.02 时,五次的累计等待是 0.02 + 0.04 + 0.08 + 0.16 = 0.3 秒;设成 1 就是 1 + 2 + 4 + 8 = 15 秒。调这个值之前先想清楚:对方的故障一般是瞬时抖动还是持续不可用。
它比手写 while 多了什么
对数退避和随机抖动。wait_random_exponential(multiplier=1, max=60) 会加随机偏移,避免一批客户端在同一毫秒集体重试把对方打死。这个「惊群」问题手写代码基本想不到。
按返回值决定是否重试。除了异常,还能用 retry_if_result(lambda r: r is None) 处理「没报错但返回空」的场景,这类接口在爬虫和第三方 SDK 里很常见。
重试过程的钩子。before_sleep 和 after_log 能在每次重试前打印日志,排查「到底重试了几次、每次什么错」时直接有记录,不用自己加 print。
统计信息。fn.retry.statistics 里存着总调用次数、成功次数、上次耗时,做监控上报可以直接读。
什么时候别用它
只在最外层包一次,别层层都加。如果 A 调 B、B 调 C,三层都带重试,最坏情况是 5 × 5 × 5 = 125 次调用,对方的压力会放大 25 倍。重试只在最靠近外部的那一层做。
对幂等性没有保证的写操作要谨慎。支付、下单、创建资源这类接口,重试可能造成重复扣款或重复创建。要么保证接口幂等(带请求 id 去重),要么只对读操作重试。
还有一点:reraise=False(默认)时,重试耗尽后会抛 RetryError 而不是原始异常,外层如果只 catch 具体异常类型会漏掉。想让调用方拿到原始异常,记得显式写 reraise=True。
没测的部分列一下,3 项:异步版本(AsyncRetrying)的开销 / 多层嵌套重试的实际调用次数 / 与 backoff 库的横向对比。