orjson 是一个用 Rust 写的 JSON 库,接口和标准库 json 几乎一样,只是把 json.dumps 换成 orjson.dumps。它解决的是「数据大、序列化慢」这一类具体问题:接口返回几万条记录、日志每秒写几千行、缓存要反复读写 JSON。
装完是三个函数
pip install orjson

import orjson
orjson.dumps(obj)      # 返回 bytes
orjson.loads(raw)      # 接受 str 或 bytes
orjson.OPT_INDENT_2    # 格式化选项,按位或组合
就这三个入口,没有类、没有配置对象。导入方式是 import orjson,不是 from orjson import ...。
要注意它的返回类型:dumps 给的是 bytes 不是 str。写文件、发 HTTP 正好直接用,但如果你要拼字符串,得自己 .decode() 一次。这一步漏了会得到 b'...' 这样的字面量。
1 万条记录:序列化快 11.5 倍
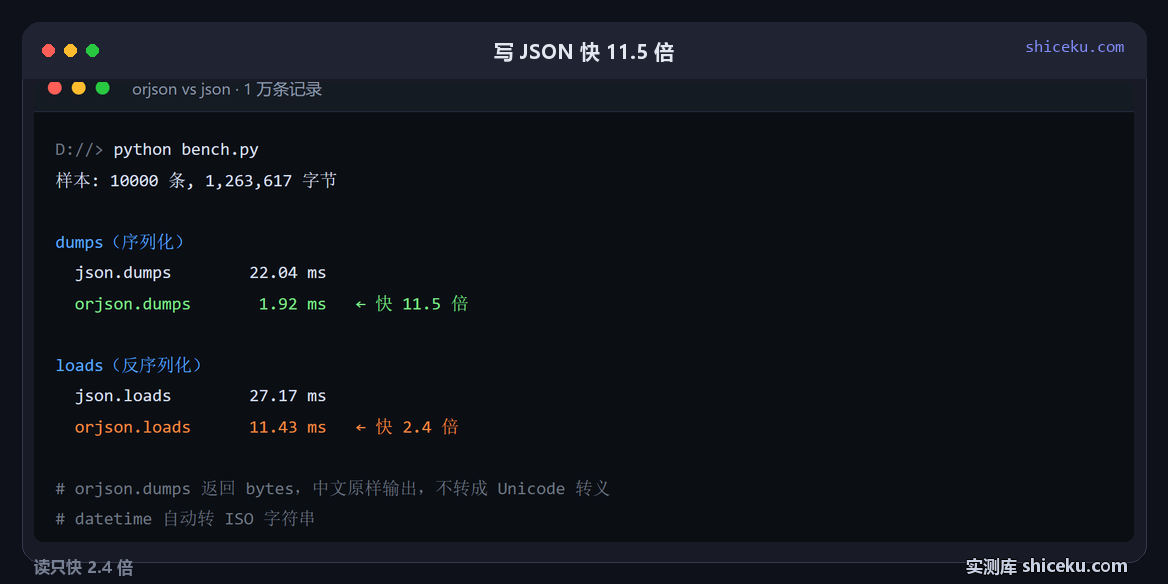
测试数据是 1 万条结构相同的记录,每条 6 个字段(整数、中文字符串、邮箱、浮点、列表、布尔),序列化后 1,263,617 字节。每种操作跑 50 次、重复 3 轮取中位:
| 操作 | json(标准库) | orjson | 倍数 |
|---|---|---|---|
| dumps 序列化 | 22.04 毫秒 | 1.92 毫秒 | 快 11.5 倍 |
| loads 反序列化 | 27.17 毫秒 | 11.43 毫秒 | 快 2.4 倍 |
两个数字差得很远,原因在实现上:序列化时标准库要逐字符判断是否需要转义、拼字符串再编码成 UTF-8,Rust 版本一次性算出长度直接写字节数组;反序列化时两边都要构建 Python 对象,这部分开销是共享的,省不掉,所以只快 2.4 倍。
结论很直接:如果你的瓶颈在「把数据写出去」,换 orjson 收益最大;如果瓶颈在「把数据读进来构建对象」,收益有限。
中文和日期不用额外处理
标准库 json.dumps 默认把中文转成 \uXXXX 转义,要保留原文得加 ensure_ascii=False。orjson 默认就是 UTF-8 原文:
orjson.dumps({"名": "测试"}).decode()
  → {"名":"测试"}
日期时间它也直接支持,不需要自定义 encoder:
orjson.dumps({"t": datetime(2026, 10, 22, 20, 0)}).decode()
  → {"t":"2026-10-22T20:00:00"}
标准库遇到 datetime 会直接抛 TypeError: Object of type datetime is not JSON serializable,必须写 default=str 或者自定义 encoder 类。这是 orjson 省事的地方之一。
体积和依赖
它是编译好的二进制轮子,装完 100 多 KB,没有额外依赖。Windows、Linux、macOS 都有预编译包,不需要本地装 Rust 工具链。如果目标平台没有对应轮子(比如某些 ARM 架构),pip 会尝试从源码编译,那时候才需要 Rust 环境。
什么时候别用它
数据量小的时候没必要。几百条记录的序列化在微秒级,换库带来的收益看不出来,反而多一个依赖要维护。
需要严格控制输出格式的场景要小心。orjson 不保证键的顺序(它按插入顺序输出,但不像标准库那样可以通过 sort_keys 排序),也不支持 default 回调之外的定制序列化器。如果你的下游系统依赖特定的键序或字段格式,得先验证。
还有一个边界:它不接受非字符串的键。{1: "a"} 在标准库里会自动转成 {"1": "a"},orjson 会抛 TypeError: Dict key must be str。老代码里如果有整数键的字典,迁移时会直接报错。
它把标准库的那些开关做成了位标志,需要时按位或上去就行:
orjson.dumps(obj, option=orjson.OPT_INDENT_2)              # 缩进 2 格
orjson.dumps(obj, option=orjson.OPT_SORT_KEYS)            # 键排序
orjson.dumps(obj, option=orjson.OPT_NON_STR_KEYS)         # 允许非字符串键
orjson.dumps(obj, option=orjson.OPT_APPEND_NEWLINE)       # 末尾加换行
OPT_NON_STR_KEYS 正好能解掉前面提到的整数键报错,同时用 OPT_SORT_KEYS 也能补上「不支持排序」这个短板。两个标志一起开,行为就接近标准库的默认写法了,只是速度会略降,因为多了排序这一步。
写日志的场景建议开 OPT_APPEND_NEWLINE,配合文件按行读的消费方(比如 tail 或者 journald)会更顺,省得自己在写完之后补换行符。
没测的部分列一下,3 项:浮点精度在极端值上的表现 / 与 ujson、simdjson 的横向对比 / 流式解析大文件的内存占用。