pypdf 是纯 Python 的 PDF 处理库,不依赖外部命令行工具,装完就能读、拆、合、加密。它处理的是 PDF 的结构层:页面对象、书签、表单域、元数据,不负责渲染和排版。日常需要「把几十页里的一页抽出来」「两份合同合成一份」「给文件加密码」,用它几行代码就够了。
核心是读写两个对象
from pypdf import PdfReader, PdfWriter

r = PdfReader("in.pdf")      # 读:len(r.pages) 拿页数
w = PdfWriter()              # 写:add_page 累积页面
w.write("out.pdf")读出来的是页面对象集合,写进去的是同样的对象。PdfWriter 本身是内存里的一个缓冲区,最后 write 才落盘,所以中间可以任意增删页面。
200 页文档的各类操作耗时
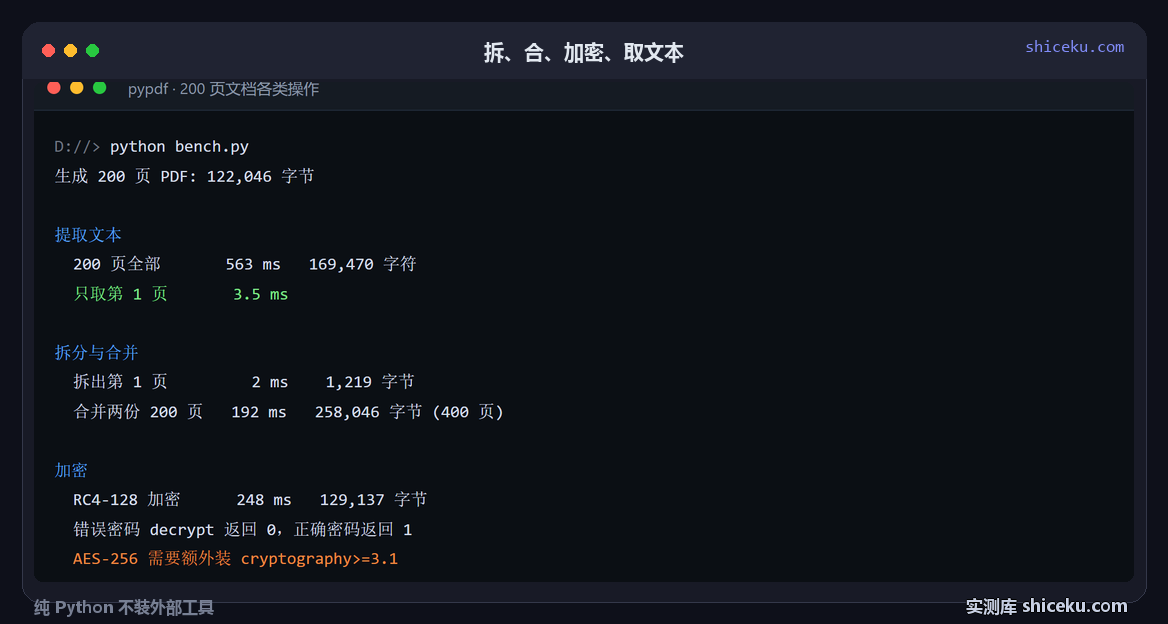
测试文档是代码生成的 200 页纯文本 PDF,122,046 字节,每页约 40 行文字:
| 操作 | 耗时 | 产出 |
|---|---|---|
| 提取全部 200 页文本 | 563 毫秒 | 169,470 字符 |
| 只取第 1 页文本 | 3.5 毫秒 | 约 847 字符 |
| 拆出第 1 页另存 | 2 毫秒 | 1,219 字节 |
| 合并两份 200 页 | 192 毫秒 | 258,046 字节,400 页 |
| RC4-128 加密 | 248 毫秒 | 129,137 字节 |
文本提取平均每页 2.8 毫秒,这个速度对大多数场景够用。要注意「提取文本」和「只取一页」差了 160 倍,说明成本主要在逐页遍历上,不在单个页面的解析上。所以批量处理时别在循环里反复重新打开文件。
合并 400 页花 192 毫秒,比提取文本还快,因为它只是搬对象引用、改交叉引用表,不解码内容流。
加密分两种,依赖不一样
PdfWriter.encrypt() 支持几种算法,差别在于要不要额外的加密库:
w.encrypt("user123", owner_password="owner456", algorithm="RC4-128")   # 纯 Python 可用
w.encrypt("user123", owner_password="owner456", algorithm="AES-256")   # 需要 cryptography
实测 RC4-128 加密 200 页花 248 毫秒,文件从 122,046 字节涨到 129,137 字节。用 AES-256 时如果没装 cryptography>=3.1,会直接报 DependencyError: cryptography>=3.1 is required for AES algorithm,不是静默降级。
解密的行为要留意:decrypt() 返回整数,1 表示成功、0 表示失败,它不抛异常。密码错了你不检查返回值,后面 len(r.pages) 会返回 0,看起来像「文件被读空了」,其实是没解开。
书签和元数据
除了页面,它还能读 PDF 的目录结构(outline)和元数据(作者、标题、创建时间)。扫描版 PDF 的书签常常是唯一可用的结构信息,做文档归档时可以从这里入手分类。
写入时也能设置元数据,w.add_metadata({"/Title": "..."}) 直接改。批量处理扫描件时,把「扫描件_001.pdf」这类文件名写进 Title 字段,后面按内容检索会方便很多。
处理不了的情况
纯图片的扫描件提不出文字。它做的是解析 PDF 的文字对象,页面本身是图片时没有文字对象可解析,extract_text() 返回空字符串。这种要上 OCR,得配 Tesseract 或者调视觉模型。
排版复杂的 PDF 提取顺序会乱。多栏排版、表格、图文混排的文档,提取出来的文字是按内部对象顺序拼的,不一定符合阅读顺序。要保留结构得用 pdfplumber 这类能识别位置的库,pypdf 只管取文字。
加密的 PDF 不能直接改。带打开密码的文件要先 decrypt() 才能操作页面,否则拿到的页面对象是空的,写出去会得到一个无内容的文件。
没测的部分列一下,3 项:大文件(500 页以上)的内存占用 / 表单域读写 / 与 pdfplumber 的提取质量对比。