pydantic 是 Python 里最常用的数据校验库,FastAPI 的请求体校验、LangChain 的结构化输出、大量配置管理工具都建在它上面。v2 版本把核心逻辑用 Rust 重写,性能比 v1 提升了一截。这篇量的是它在真实数据量下的表现,以及和手写校验的差距。
一个模型定义七个字段
被测模型是一个用户记录,7 个字段,带范围约束:
class User(BaseModel):
    id: int = Field(ge=1)
    name: str = Field(min_length=1, max_length=50)
    email: str
    age: int = Field(ge=0, le=150)
    score: float = Field(ge=0, le=100)
    tags: List[str]
    active: bool
Field(ge=1) 这类约束是声明式的,不需要写 if 判断。类型不对、范围越界,它在赋值的时候就拦住。
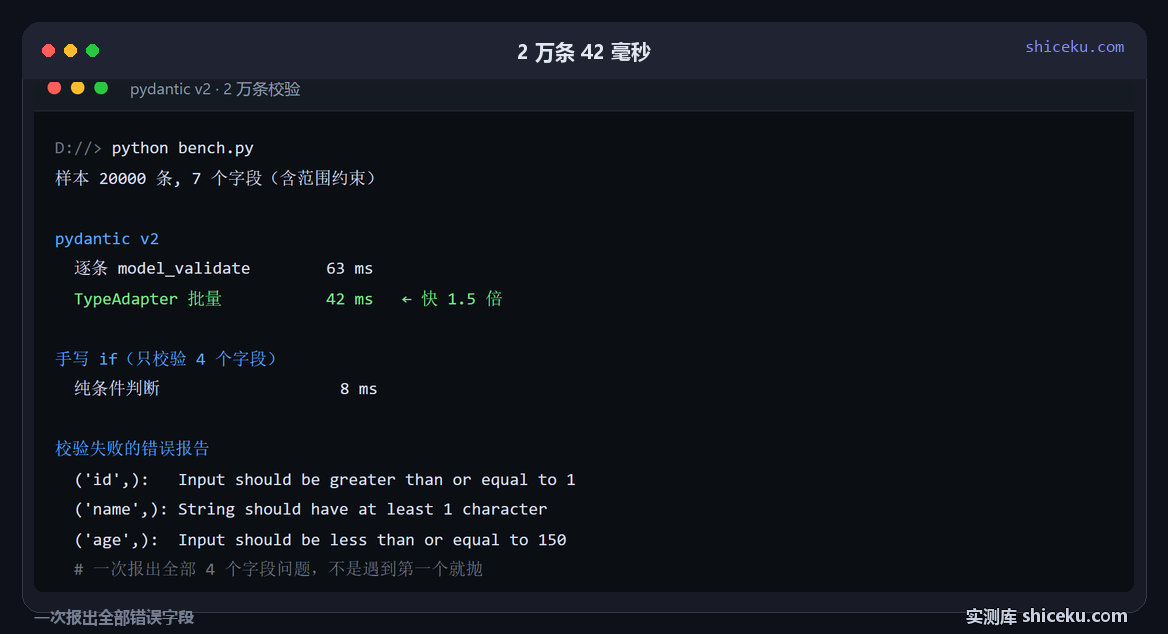
2 万条数据:逐条 63 毫秒,批量 42 毫秒
| 方式 | 2 万条耗时 | 说明 |
|---|---|---|
| 逐条 model_validate | 63 毫秒 | 循环里一条一条校验 |
| TypeAdapter 批量 | 42 毫秒 | 一次传整个 list |
| 手写 if 判断(只校验 4 个字段) | 8 毫秒 | 纯条件检查,不做类型转换 |
三个数字要连起来看。
批量比逐条快 1.5 倍。用 TypeAdapter(List[User]) 一次校验整个列表,省掉了每条进出 Python 层调用的开销。这个写法值得记:
from pydantic import TypeAdapter
ta = TypeAdapter(List[User])
users = ta.validate_python(raw_list)
手写 if 比 pydantic 快 5 到 8 倍,但两者做的事不一样:手写只检查了 4 个字段的条件、不做类型转换、出错就抛第一个异常;pydantic 校验全部 7 个字段、把 "123" 转成 123、把 "true" 转成 True、并且收集所有错误。
它真正值钱的是错误报告
传一条全都错的数据进去,它一次报出全部问题,而不是遇到第一个就中断:
校验失败一次报出 4 个字段问题:
  ('id',):   Input should be greater than or equal to 1
  ('name',): String should have at least 1 character
  ('age',):  Input should be less than or equal to 150
  ('score',): Input should be less than or equal to 100
手写校验要做到这个效果,得自己设计错误收集结构、把每条错误带上字段路径、最后组装成可读的报告。这部分工作量比校验本身大得多。
它的错误对象还带结构化字段:loc 是字段路径(嵌套模型会是 ('address', 'city') 这样的元组),type 是错误类型代码,input 是原始输入。前端要按字段显示错误提示,直接遍历 e.errors() 就行,不用解析字符串。
类型转换是另一层价值
HTTP 请求、环境变量、CSV 读出来的值几乎都是字符串。age: int 声明的字段收到 "25" 会自动转成 25,收到 "abc" 才报错。手写校验要自己写 int(x) 加 try/except,每个字段来一遍。
嵌套结构同理。tags: List[str] 收到 "a,b" 这样的字符串,v2 默认不会自动按逗号切分(要自定义 validator),但收到 ["a", "b"] 会逐个校验元素类型。层级越深,手写成本越高。
模型定义本身有成本
定义模型时它要做元类处理、生成校验器。实测动态创建 100 个 4 字段的模型花 41 毫秒,平均每个 0.4 毫秒。静态定义的模型在 import 时一次建好,运行期不再有这部分开销,所以正常使用感知不到。
但如果你的代码在请求处理过程中动态生成模型(比如按用户配置拼 schema),这 0.4 毫秒会累加。这种场景建议把模型缓存起来,按配置的哈希做键,避免重复构建。
什么时候别用它
数据结构固定、字段少、只在内网流转的场景,手写几个 if 就够了,不必引入一个带编译核心的依赖。上面 8 毫秒对 63 毫秒的差距在你只处理几百条数据时看不出来,但依赖体积和心智负担是实打实的。
反过来,只要涉及外部输入(HTTP 请求体、上传的 CSV、第三方 API 返回),pydantic 的边界校验和错误报告值得那个性能代价。这类场景最怕的是「脏数据悄悄流进业务逻辑」,等出问题时排查成本远高于校验开销。
还有一点:v1 到 v2 有不兼容改动(validator 换成 field_validator、Config 换成 model_config 等)。老项目升级时要么改代码,要么装 pydantic.v1 兼容层,不能直接换版本号。
没测的部分列一下,3 项:嵌套模型的校验开销 / JSON 直接解析校验(model_validate_json)的速度 / 与 attrs、marshmallow 的横向对比。