sqlite-utils 是 Simon Willison 写的一个命令行工具兼 Python 库,干的活是「把 CSV 或 JSON 变成 SQLite,然后方便地查」。一条命令就能建表、推断字段类型、导入数据,比手写 sqlite3 代码省事。但它的导入性能有个大坑,实测慢到出乎意料。
一条命令把 CSV 变成数据库
装完之后多一个 sqlite-utils 命令,导入是这么写的:
sqlite-utils insert t.db rows data.csv --csv它自己读表头、自己判断每个字段的类型,建完表直接开始灌数据。建出来的结构:
CREATE TABLE "rows" (
   "id" INTEGER,
   "city" TEXT,
   "amount" REAL,
   "ts" INTEGER
);
四个字段的类型全对:整数、文本、浮点、整数。手写的话要先看一遍数据、决定每个字段用什么类型,再写 CREATE TABLE 和 INSERT。这个环节它确实省事。
但 10 万行导了两分五十四秒
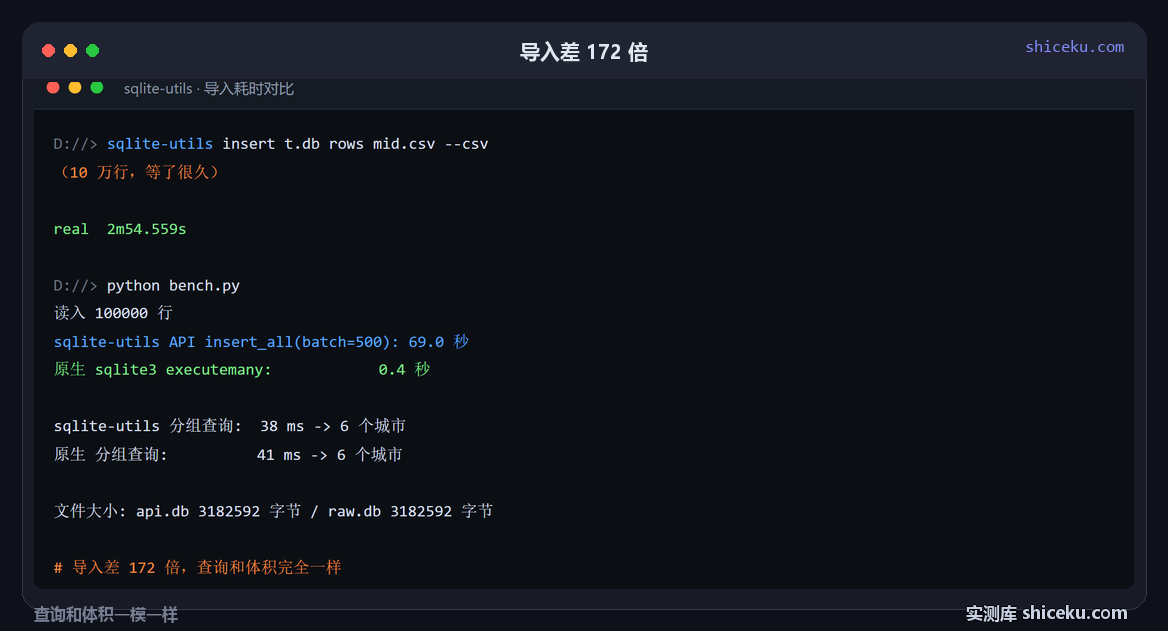
用 10 万行 4 列的 CSV(3,168,005 字节)测,命令行导入实测:
$ time sqlite-utils insert t.db rows mid.csv --csv
real  2m54.559s
174 秒。同期我用原生 sqlite3 的 executemany 导同样数据,0.4 秒。
怀疑是 CLI 的问题,于是用它的 Python API 再测一遍:
from sqlite_utils import Database
db = Database("api.db")
db["rows"].insert_all(rows, batch_size=500)
  → 69.0 秒
69 秒,比 CLI 快,但仍然是原生方式的 172 倍。
| 导入方式 | 10 万行耗时 | 相对原生 |
|---|---|---|
| 命令行 sqlite-utils insert | 174.5 秒 | 436 倍 |
| Python API insert_all(batch=500) | 69.0 秒 | 172 倍 |
| 原生 sqlite3 executemany | 0.4 秒 | 基准 |
慢的原因在它的工作方式:每插一批都要检查列是否已存在、是否要 ALTER TABLE、做类型转换,这些检查逐行重复。原生 executemany 把这些全跳过了,只做一件事:把参数塞进 SQLite 的批量接口。
查询和文件大小完全一样
导入慢,但产出的东西没区别:
| 对比项 | sqlite-utils 建的库 | 原生建的库 |
|---|---|---|
| 文件大小 | 3,182,592 字节 | 3,182,592 字节 |
| 分组查询耗时 | 38 毫秒 | 41 毫秒 |
| 城市数量 | 6 | 6 |
字节数一模一样,查询耗时差 3 毫秒(在噪声范围内)。因为底层就是同一个 SQLite 引擎、同样的表结构。慢的只是「导入」这个环节。
它的价值不在速度,在那些顺手的功能
如果只是导入,用原生代码更快。sqlite-utils 真正省事的是这些:
命令行直接查:sqlite-utils query t.db "select city, count(*) from rows group by city",结果默认输出 JSON,比 sqlite3 命令行的表格更适合接管道。
自动加全文搜索索引:sqlite-utils enable-fts t.db rows city 一句话建好 FTS5 虚拟表和触发器,自己写要建表、写三个触发器、还要处理同步。
改表结构:sqlite-utils transform 能改列名、改类型、删列,它会自动建新表、搬数据、删旧表,过程中不丢数据。
导出:sqlite-utils rows t.db rows --csv 或者 --nl 出 JSON Lines,做 ETL 时很方便。
什么时候用,什么时候别用
数据量在几千行以内,它的导入速度完全无所谓,1 万行大概几秒,用它的便捷功能划算。
超过 10 万行就别用它的导入了。正确做法是用原生 executemany 或 to_sql 把数据灌进去,然后用 sqlite-utils 做查询和后续处理。两者可以混用,因为它操作的就是标准 SQLite 文件。
还有一点:它默认不开事务批量提交,如果你非要用 insert_all,记得显式包一层 with db.conn:,否则每条 INSERT 都是一次独立提交,磁盘 I/O 会拖垮速度。
还有一个内存上的坑:如果你按官方示例那样先把整个 CSV 读成 list 再交给 insert_all,10 万行 4 列会吃掉几百 MB 内存,100 万行直接爆。正确做法是用它的 insert_all(rows, alter=True) 配合生成器逐批喂,或者干脆退回原生 executemany 的流式写入。
全文搜索那块倒是值得用。手写 FTS5 要建虚拟表、写 INSERT/UPDATE/DELETE 三个触发器保持同步,漏一个就会出现「改了数据但搜不到」。enable-fts 一条命令把这些全做了,实测建完索引后中文字段也能搜,不需要额外分词器就能按词匹配。
如果你要把这套东西放进自动化流程,建议这样分工:用原生代码负责写入(0.4 秒对 69 秒差 172 倍),用 sqlite-utils 负责查询、导出和结构变更。两者操作的是同一个标准 SQLite 文件,随时可以切换。
没测的部分列一下,3 项:enable-fts 建索引的耗时 / transform 改大表结构的表现 / 与 pandas to_sql 的速度对比。