duckdb 是嵌入式分析数据库,一个 pip 包装完就能用,不需要起服务。它和 sqlite 长得很像,但解决的是另一类问题:sqlite 擅长一条一条地读写,duckdb 擅长一次扫过百万行做统计。
先分清它和 sqlite 的定位
两者都是嵌在进程里的数据库,都没有独立服务进程,都用单个文件存数据。区别在存储方式:sqlite 按行存,读一行的所有字段很快;duckdb 按列存,只读你 SELECT 的那几列,所以对「扫一大片做聚合」特别快。
结果就是:给应用做增删改查用 sqlite,做日志分析、报表统计、CSV 探索用 duckdb。拿 duckdb 当业务库会很难受,它的写入是批量的,单条 insert 不划算。
最实用的一点:直接查 CSV,不用导入
这是它和传统数据库最大的体验差异。把 CSV 路径当表名写进 FROM 就行:
import duckdb
con = duckdb.connect()
con.execute("SELECT count(*) FROM 'big.csv'").fetchone()
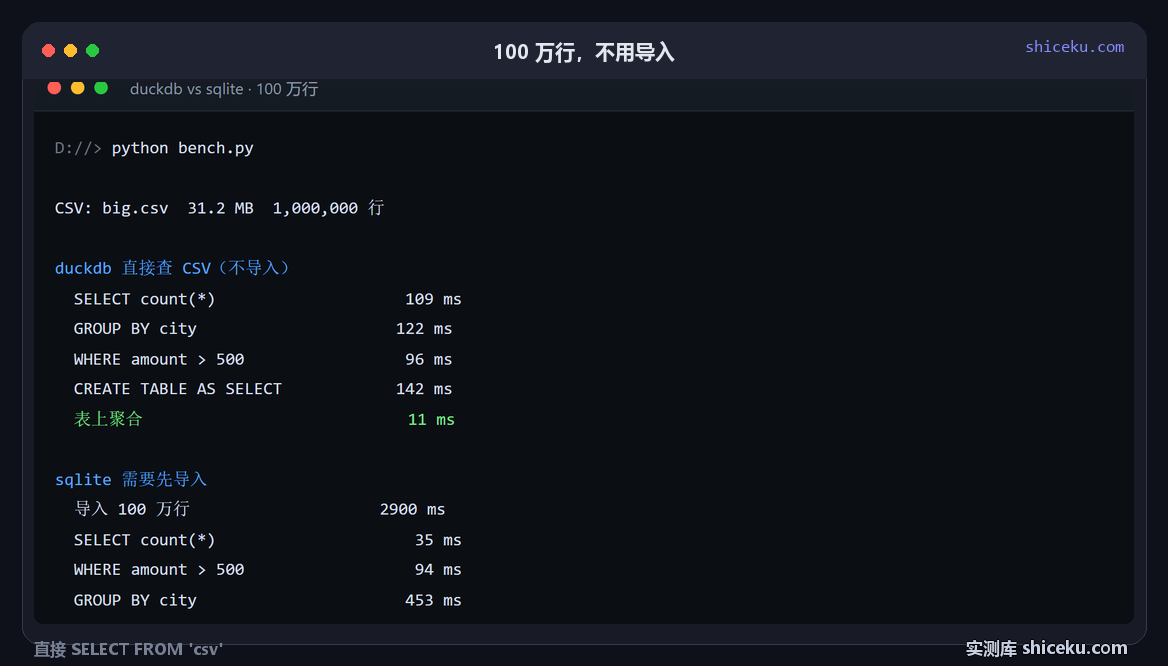
不需要先建表、不需要声明字段类型、不需要写导入脚本。它会自己推断表头和类型,扫完直接出结果。同样的数据要用 sqlite 查,得先写导入逻辑,100 万行花 2.9 秒才进得去。
Parquet 也一样,而且 Parquet 是列式压缩格式,读起来比 CSV 快得多。
100 万行,31.2 MB,各组操作耗时
测试数据自己造的:100 万行 4 列(id / city / amount / ts),6 个城市循环,amount 是 0 到 1000 的随机数,CSV 文件 31,279,291 字节。
| 操作 | duckdb | sqlite | 说明 |
|---|---|---|---|
| 计数 count(*) | 109 毫秒 | 35 毫秒 | sqlite 走元数据,更快 |
| 条件过滤 amount > 500 | 96 毫秒 | 94 毫秒 | 基本持平 |
| 分组聚合 GROUP BY city | 122 毫秒 | 453 毫秒 | duckdb 快 3.7 倍 |
| 建表 CTAS | 142 毫秒 | — | duckdb 一条语句完成 |
| 建表后聚合 | 11 毫秒 | — | 列式 + 已加载 |
| 导入 100 万行 | 不需要 | 2900 毫秒 | 这是最大差别 |
有两个数字值得注意。
一是 count(\*) 反而慢了 3 倍(109 对 35 毫秒)。因为 duckdb 读 CSV 要真的把文件扫一遍,而 sqlite 的 count 走的是表元数据,不碰数据页。这个差距说明 duckdb 的优势不在「轻量查询」,在「扫描量大的聚合」。
二是建表之后聚合从 122 毫秒掉到 11 毫秒。同一个查询,差别在于数据从 CSV 变成了 duckdb 自己的列式格式。这也是它的正确用法:一次性把 CSV 转成表,后面反复查。
装进来就是一个 pip 包
pip install duckdb
python -c "import duckdb; print(duckdb.__version__)"
今天是 2.0.0 版。它同时提供 Python 模块和命令行工具,命令行可以直接交互式查询:
duckdb -c "SELECT city, count(*) FROM 'big.csv' GROUP BY city"它还支持从 pandas、polars、Arrow 的 DataFrame 零拷贝读数据,这一点在 Python 数据流程里很省事:不用落盘,直接查内存里的表。
什么时候别用它
如果你的场景是「用户点一下、读一条记录、改一条记录」,duckdb 不合适。它的写入按批处理,单条 insert 要等事务提交,比 sqlite 慢得多,而且并发写入能力很弱,同一时刻只允许一个写者。
数据量小的时候也没必要。几万行的 CSV,pandas 读进来再算完全够,多装一个数据库只会让依赖变复杂。它的优势要到几十万行以上、且反复查询同一批数据时才明显。
还有一个限制要提前知道:它不支持像 sqlite 那样被多个进程同时读写同一份文件。做服务端并发访问得走它自己的 server 模式,那就不是「嵌入式」了。
没测的部分列一下,3 项:Parquet 格式的读速对比 / 与 pandas 的内存占用对比 / 并发写入的实际报错行为。