pyinstrument 是 Python 的采样式性能分析器,特点是输出一棵按耗时排序的调用树,而不是一张函数耗时平铺表。它的宣传点是「开销低」,这篇就是去量这个开销到底有多低,以及低在什么条件下。
两行接入
from pyinstrument import Profiler

p = Profiler(interval=0.001)
p.start()
your_code()
p.stop()
print(p.output_text())也可以用命令行直接包一层:pyinstrument -m your_module,不用改代码。interval 是采样间隔,默认 1 毫秒。
同一个任务,装与不装
任务是三段计算(字符串解析、数字转换、排序)循环 50 轮,各跑 5 次取中位:
| 方式 | 耗时 | 倍数 |
|---|---|---|
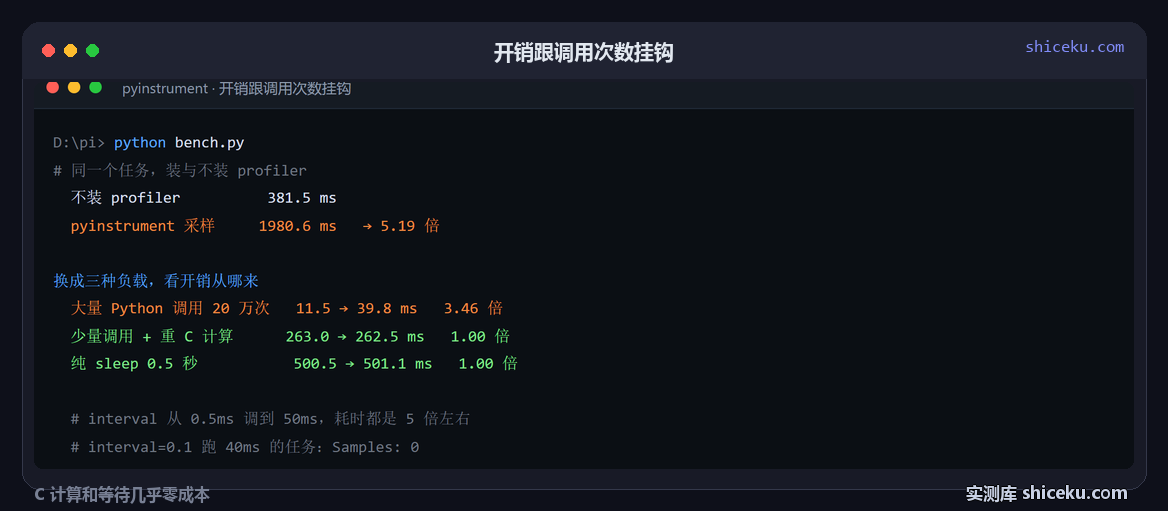
| 不装 profiler | 381.5 毫秒 | 基准 |
| pyinstrument 采样 | 1980.6 毫秒 | 5.19 倍 |
慢了 5 倍,这跟「采样分析器几乎无开销」的常见说法差得远。继续查才发现,开销不跟耗时挂钩,跟 Python 调用的次数挂钩。
开销跟着调用次数走
换成三种完全不同的负载,同样测装与不装:
| 负载类型 | 不装 | 装了 | 倍数 |
|---|---|---|---|
| 大量 Python 调用(20 万次) | 11.5 毫秒 | 39.8 毫秒 | 3.46 倍 |
| 少量调用 + 重 C 计算 | 263.0 毫秒 | 262.5 毫秒 | 1.00 倍 |
| 纯 sleep 0.5 秒 | 500.5 毫秒 | 501.1 毫秒 | 1.00 倍 |
后两行几乎没有额外开销。重 C 计算那 263 毫秒全在 sum(range(30000000)) 里,Python 层只调了一次;sleep 更是完全不占 CPU。
第一行 20 万次 Python 调用,多花了 28 毫秒,折算下来每次调用多 0.14 微秒。前面那个 5.19 倍的例子,50 轮里跑了几百万次生成器迭代,按这个单价累加出来就是 1.6 秒。
结论很明确:Python 代码越密集,它越贵;瓶颈在 C 扩展或者 IO 等待上,它几乎免费。
interval 调大也没变快
interval=0.0005   1991.4 ms   5.22 倍
interval=0.001    1971.8 ms   5.17 倍
interval=0.005    1940.7 ms   5.09 倍
interval=0.01     1958.3 ms   5.13 倍
interval=0.05     1946.0 ms   5.10 倍
从 0.5 毫秒调到 50 毫秒,耗时纹丝不动。真正的采样分析器应该靠降低采样频率来减少开销,这里没有,说明这份开销花在每个函数调用的钩子上,而不是花在采样动作本身。
所以别指望把 interval 调大来降低开销,它买到的只是更粗的采样粒度。
采样太少会得到空报告
>>> p = Profiler(interval=0.5)
>>> p.start(); sum(range(100000)); p.stop()
>>> print(p.output_text())
...  Samples:  0
...  Duration: 0.001
任务只跑了 1 毫秒,采样间隔 0.5 秒,一帧都没采到,报告是空的。它不会提示「样本不足」,只给你一张没有内容的树。
所以分析短函数必须把工作量放大,或者把 interval 调小。反过来,跑一个几十毫秒就结束的脚本然后抱怨「看不出来热点」,多半就是这个原因。
报告怎么读
输出的是一棵树,每行左边的数字是这一层花掉的时间,[self] 表示时间花在函数自己身上、没有再往下调:
1.946 task
└─ 1.946 aggregate
   ├─ 1.343 parse
   │  ├─ 1.009 <genexpr>
   │  │  ├─ 0.702 [self]
   │  │  └─ 0.307 ord
   │  └─ 0.329 [self]
   ├─ 0.356 <genexpr>
   └─ 0.187 [self]
从这张图能直接读出两件事:1.343 秒在 parse 里,占总量七成;parse 内部又有一半在 ord 这个内置函数上。要优化就改这里,别的地方加起来不到三分之一。
什么时候用它
怀疑某段代码慢,但不知道慢在哪一层。调用树能直接指出是哪一层的哪个函数吃掉了时间,比自己插 time.perf_counter() 猜位置快得多。
服务已经跑起来了要抓现场。它支持挂到运行中的进程上采样,不用重启,也不用改代码。
纯计算密集、调用层级深的代码,别用它。5 倍的开销会把本来就慢的地方放得更大,测出来的绝对耗时没有参考价值。这种场景用 cProfile 或者直接打点更合适。
没测的部分列一下,3 项:挂到运行中进程的实际成功率 / 输出 HTML 报告的体积 / 与 cProfile 在同一段代码上的结果差异。