mypy 是 Python 的静态类型检查器,读代码不运行,靠类型标注推断每个变量和返回值该是什么类型。它和 ruff 常被放在一起提,但两者查的不是一回事:ruff 看写法和常见错误,mypy 看类型对不对。
这篇用同一批 50 个文件把两者放在一起跑,看耗时差多少,以及 mypy 到底能拦住什么。
装完就是一条命令
pip install mypy

mypy .                 # 检查当前目录
mypy app/models.py     # 只查一个文件
mypy --strict .        # 打开全部严格检查
不需要配置就能跑,默认按函数签名推断。想强制每个函数都写注解,加 --strict 或者写进 pyproject.toml 的 strict 选项。
同一批文件,两者差了 28 倍
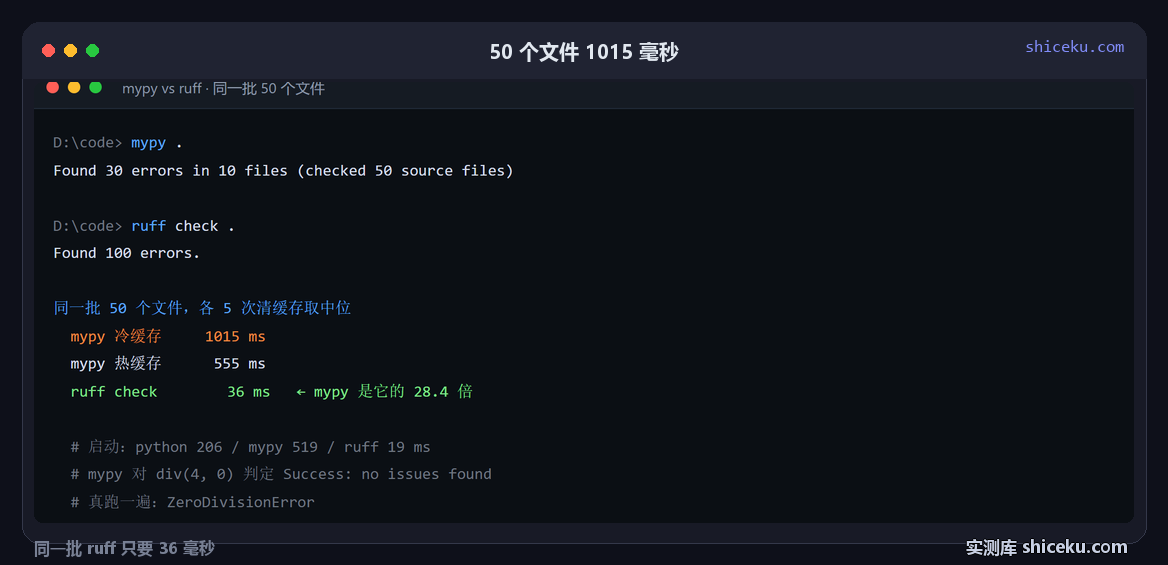
样本是 50 个文件,共 19,780 字节。其中 40 个类型正确,10 个各含 3 处类型错误。每组跑 5 次,每次前清掉 .mypy_cache:
| 命令 | 耗时 | 报出 |
|---|---|---|
| mypy 冷缓存 | 1015 毫秒 | 30 条错误 |
| mypy 热缓存 | 555 毫秒 | 30 条错误 |
| ruff check | 36 毫秒 | 100 条 |
mypy 是 ruff 的 28.4 倍。报错条数反倒是 ruff 多,因为它把风格问题也算进去,mypy 只报类型。
冷缓存与热缓存差一半
mypy 冷缓存    1015 ms
mypy 热缓存     555 ms
差的这 460 毫秒在建缓存。mypy 第一次跑会把标准库的类型定义、依赖包的类型存进 .mypy_cache,第二次直接读,省掉解析。所以 CI 里如果缓存目录能持久化,第二次之后的检查会快接近一半。
启动成本也值得看一眼:mypy --version 519 毫秒,ruff --version 19 毫秒。mypy 是纯 Python 程序,光导入就要半秒,这部分和文件数量无关。
它报出的 30 条错误长什么样
| 写法 | mypy 的判断 |
|---|---|
| add(1, "two") | Argument 2 has incompatible type "str"; expected "int" |
| r2: int = greet("a") | Incompatible types in assignment |
| greet(123) | Argument 1 has incompatible type "int"; expected "str" |
每条都带文件、行号、错误码,例如 [arg-type]。错误码可以单独关掉,写 # type: ignore[arg-type] 就只忽略这一类。
30 条正好是 10 个文件乘 3 处,说明它把同一文件的问题一次列全,不会遇到第一个错误就停。末尾那行 checked 50 source files 也值得看一眼:它把所有被检查的文件数报出来,而不是只报有问题的那 10 个,所以数字对不上时能立刻发现某个模块根本没被扫到。
这类错误在运行时不一定炸。Python 不做参数类型检查,add(1, "two") 会走到函数体里再抛 TypeError,而且可能部署到线上才被发现。这是加 mypy 的主要理由。
它查不出的东西
mypy 只看类型,不看值。同一个除零写法,它的判定是通过:
$ mypy runtime.py
Success: no issues found in 1 source file

$ python runtime.py
ZeroDivisionError: integer division or modulo by zero
类型上 a: int 和 b: int 相除完全合法,能不能除得动要运行时才知道。类似的还有列表越界、字典取不存在的键、文件不存在,这些都不在静态检查的范围里。
什么时候值得加这一层
多人协作、接口边界多。一个函数被十个地方调用,改参数顺序时没有类型检查就只能靠搜索。mypy 会在调用点直接报出来。
项目已经写了类型标注。标注写了不检查等于白写,mypy 是让标注产生收益的那一步。
纯脚本、几十行的小工具不要加。1015 毫秒的检查时间比脚本本身运行还长,改动频率又高,收益为负。
还有一点:mypy 的 --strict 在老项目上会一次报出几百条,和 ruff 一样建议分批打开,先在 CI 里对新代码生效。
没测的部分列一下,3 项:strict 模式下的报错量 / 与 pyright 的检查速度差异 / 大型项目的增量检查表现。