Pygments 是 Python 的语法着色库,常见编程语言和文本格式都有对应的 lexer,覆盖面比大多数编辑器内置的高亮还全。它不是给别人用的软件,而是被别的工具调用:Sphinx 的文档高亮、Jupyter 的代码块、各种静态站点生成器,底层基本都是它。
这篇测两件事:给一个 6000 行的文件着色要多久,以及「让库自己猜语言」这个常见写法值不值。
三行代码上色
from pygments import highlight
from pygments.lexers import PythonLexer
from pygments.formatters import Terminal256Formatter

print(highlight(code, PythonLexer(), Terminal256Formatter()))三个参数分别是源码、词法分析器和输出格式。输出格式决定产物:Terminal256Formatter 给终端,HtmlFormatter 给网页,还有 LaTeX、RTF、SVG 这些。
6000 行的着色耗时
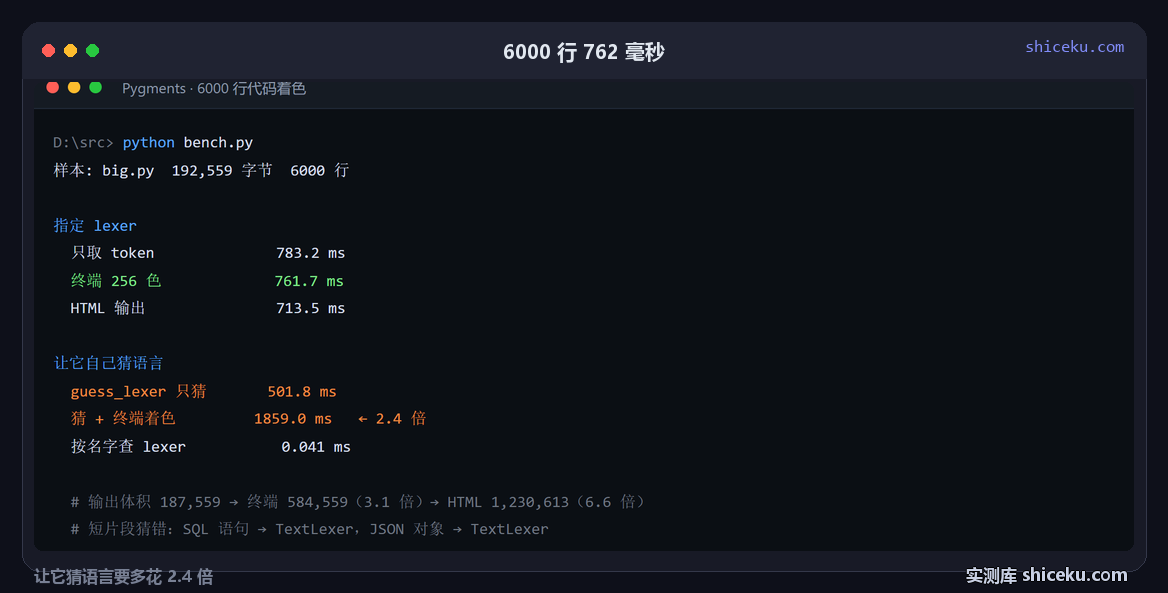
样本是一个 192,559 字节的 Python 文件,6000 行,内容是一批结构重复的类。每组跑 5 次取中位:
| 做法 | 耗时 | 说明 |
|---|---|---|
| 指定 lexer,只取 token | 783.2 毫秒 | 只做词法分析,不生成字符串 |
| 指定 lexer,终端 256 色 | 761.7 毫秒 | 带 ANSI 转义 |
| 指定 lexer,HTML 输出 | 713.5 毫秒 | 带 span 和 class |
| guess_lexer 只猜语言 | 501.8 毫秒 | 光猜就花掉一半 |
| guess_lexer + 终端着色 | 1859.0 毫秒 | 是直接指定的 2.4 倍 |
| 按名字查 lexer | 0.041 毫秒 | 字典查找,可以忽略 |
有个反直觉的地方:只取 token 反而比直接着色慢(783 对 762 毫秒)。因为 get_tokens 返回的是生成器,测试里用 list() 把它全部展开,多了一次构建列表的开销。
猜语言是最大的浪费
很多人图省事写成 highlight(code, guess_lexer(code), fmt),效果是多花一倍时间,还可能猜错:
guess_lexer 只猜            501.8 ms
guess_lexer + 终端着色     1859.0 ms
直接指定 lexer + 着色       761.7 ms
501.8 毫秒的猜语言阶段是纯额外成本。它的做法是把文本喂给每个候选 lexer,各自算一个匹配分,取最高分的那个。文件越大、候选越多,这段越慢。
更麻烦的是猜错。拿两段没有文件名的片段测试:
SELECT id, name FROM users WHERE age > 18 ORDER BY id DESC;
  → TextLexer(不着色)

{"name": "实测库", "version": 1, "ok": true}
  → TextLexer(不着色)
两条都返回 TextLexer,意思是没有识别出来,原样输出。SQL 语句明明有 SELECT 和 FROM 这种强特征,JSON 有完整的花括号结构,短文本下它还是放弃了。
结论很简单:只要知道语言,就显式传 lexer。查表本身只要 0.041 毫秒,按扩展名建一个映射表就够,别把 501.8 毫秒花在猜上。
输出体积会膨胀
着色不是免费的,产物比原文大得多:
| 形式 | 体积 | 倍数 |
|---|---|---|
| 原始代码 | 187,559 字符 | 1.0 |
| 终端 256 色 | 584,559 字符 | 3.1 倍 |
| HTML | 1,230,613 字符 | 6.6 倍 |
终端版本每段带一组 ANSI 转义序列,HTML 版本每段包一个 span 加 class 名。做网页代码展示时这个 6.6 倍要算进传输量,187,559 字符的源文件着色后是 1,230,613 字符。
线上更常见的做法是服务端只输出纯文本,交给前端的高亮库在浏览器里着色,或者把 HTML 版本压进构建产物里,别每次请求现渲染。
什么情况别用它
只是想给终端输出加点颜色。打印表格、进度条、日志着色用 rich 更合适,它内置的样式系统不需要走词法分析,几百行代码的开销在毫秒级。
要处理几万行的文件。按 6000 行 761.7 毫秒线性推算,五万行是分钟级,而且中间产物全在内存里。这种场景要么分段着色,要么只在展示时对可见区域着色。
只需要加几种固定颜色。整段文本按正则替换成带 ANSI 的字符串,几十微秒就能完成,引一个词法分析框架进来属于杀鸡用牛刀。
传错 formatter 不会报错,问题留到下游才显形。把 Terminal256Formatter 的输出塞进 HTML 页面,看到的是一堆 \x1b[38;5 开头的乱码;反过来把 HTML 输出打到终端,屏幕上就是密密麻麻的 span 标签和 class 名。两种错都发生在下游,着色这一步不会报错,排查时容易怀疑到别处。
没测的部分列一下,3 项:并行着色多个文件的可行性 / 自定义 lexer 的编写成本 / 与 tree-sitter 的解析速度对比。