pytest 是 Python 里用得最多的测试框架,几乎每个库的 CI 里都有它。它的价值在于断言直接写 assert、失败时能看到两边的具体值、fixture 能把准备和清理拆开。
这篇不聊怎么写测试,只算一笔账:跑几百个用例时,时间到底花在哪。因为测试一旦写多了,每次改一行就跑一遍,等的那几秒会直接影响节奏。
三百个用例的时间去向
样本是 50 个测试文件,每个 6 个用例,共 300 个,全部通过,每个用例只做一次简单断言。跑 3 次取中位,每次前清空 .pytest_cache:
| 命令 | 墙钟耗时 | 它自己报的时间 |
|---|---|---|
| pytest --collect-only | 2700 毫秒 | 收集 300 个用例 0.36 秒 |
| pytest -q | 4070 毫秒 | 300 passed in 1.72 秒 |
| 只跑 1 个用例 | 2234 毫秒 | 1 passed |
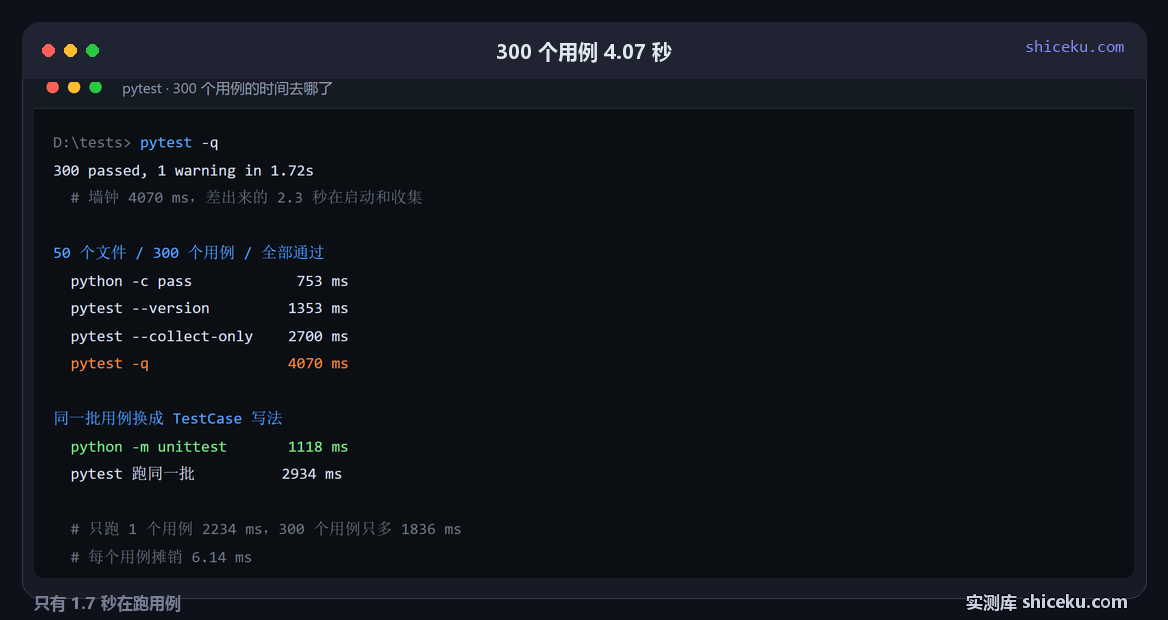
第三行最能说明问题。只跑一个用例要 2234 毫秒,300 个用例总共 4070 毫秒,也就是说 300 个用例的执行只多花了 1836 毫秒,每个平均 6.14 毫秒。剩下那 2.2 秒是启动加导入加收集的固定成本。
固定开销从哪来
把链条拆开逐个量,每一段都能对上:
python -c pass        753 ms    # 解释器本身
pytest --version     1353 ms    # 加上 pytest 的导入
pytest --collect-only 2700 ms    # 再加上扫描文件和构建用例树
pytest -q            4070 ms    # 最后才是执行
解释器 753 毫秒是 Windows 上的底噪,换 Linux 会低不少。pytest 自己的导入再加 600 毫秒,因为要把断言重写、fixture 管理、插件系统全部装进来。收集阶段又加 1347 毫秒,这一段的成本跟文件数量正相关,跟用例里写了什么无关。
和 unittest 比
同一批 300 个用例改成 TestCase 写法(50 个类,每类 6 个方法),两边各跑 3 次:
| 运行方式 | 耗时 | 备注 |
|---|---|---|
| python -m unittest | 1118 毫秒 | 标准库,没有额外导入 |
| pytest 跑同一批 | 2934 毫秒 | 多 1816 毫秒 |
差距基本就是 pytest 的导入和收集成本。反过来说,如果项目只有几十个用例、跑一次只花零点几秒,那这 1.8 秒就是纯开销。
一个容易踩的坑:unittest 跑不了裸函数
直接用 python -m unittest discover -s tests 去跑那批 pytest 风格的函数式用例,输出是这一行:
NO TESTS RAN它不报错,退出码是 0,只是什么都没跑。原因是 unittest 的发现机制只认 TestCase 子类里的方法,顶层 def test_xxx() 完全不认。
这条在迁移时特别容易出问题:把测试从 unittest 改成 pytest 很简单,反过来改回去,用例会静默消失。CI 里如果只判断退出码,等于这批测试从来没跑过。
还有一种不报错的情况:用例函数名不以 test_ 开头时,pytest 不会报错,直接输出 no tests ran in 0.01s,退出码 5。这个 5 在 pytest 里的意思是「一个用例都没收集到」,不是测试失败,和断言挂掉的退出码 1 不是一回事。
什么时候 pytest 不划算
用例总数很少。十来个用例的项目,固定开销 2.2 秒,实际执行不到 0.1 秒,比例太悬殊。这种项目用 unittest 或者干脆写成脚本跑 assert 更直接。
需要把测试打进极小镜像。pytest 依赖十几个包,容器层会明显变厚。标准库的 unittest 是零依赖。
只想快速验证一个函数。改一行跑一遍的场景,用 python -c 直接调比走测试框架快得多。
反过来,用例超过一两百个、需要 fixture 管数据库连接、需要参数化跑几十组数据时,pytest 省下的组织成本远超那 2 秒。
没测的部分列一下,3 项:pytest-xdist 并行跑的实际加速比 / 大型 conftest.py 对收集时间的影响 / 覆盖率插件 coverage 的额外开销。