ruff 是 Rust 写的 Python 检查器和格式化工具,一个可执行文件同时顶掉 flake8 / isort / pyupgrade 和 black 的活。它不依赖 Python 环境,也不用装一堆插件,装完就是 ruff check 和 ruff format 两个命令。
装完只有两个命令
pip install ruff

ruff check .            # 检查
ruff check . --fix      # 能自动修的当场修掉
ruff format .           # 格式化
ruff format --check .   # 只报告,不改文件
check 走的是 lint 规则集,format 走的是格式化器,两者互相独立,可以只启用其中一个。老的 flake8 配置它能直接读,写进 pyproject.toml 更省事。
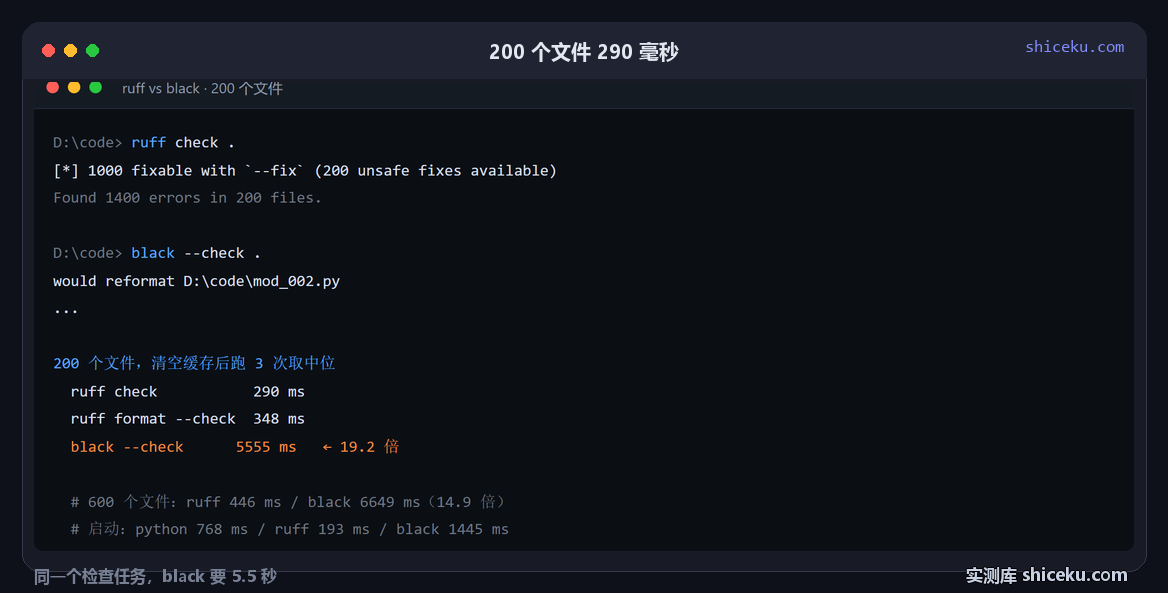
200 个文件的速度差
样本是 200 个 .py 文件,每个 17 行,共 56,290 字节,里面塞了未用 import、和 None 比较、裸 except 这类常见问题。每组跑 3 次取中位,跑之前清空 .ruff_cache,避免缓存混进结果:
| 命令 | 200 个文件 | 600 个文件 |
|---|---|---|
| ruff check | 290 毫秒 | 446 毫秒 |
| ruff format --check | 348 毫秒 | 未测 |
| black --check | 5555 毫秒 | 6649 毫秒 |
| 倍数 | 19.2 倍 | 14.9 倍 |
600 个文件那一档倍数降到 14.9,因为两边都有固定开销,规模越大,差距越接近纯处理能力的比值。这也说明单看 200 个文件的 19 倍会略微高估。
差的那 5 秒是启动,不是算得慢
python -c pass        768 ms
ruff --version        193 ms
black --version      1445 ms
三个数字摆在一起就能看出来源。black 本身是 Python 程序,光导入模块就要 1445 毫秒,其中 768 毫秒是解释器启动,剩下的是 click 和 pathspec 这些依赖。ruff 是编译好的二进制,193 毫秒比 Python 解释器本身还快。
只检查一个文件时更明显:ruff 205 毫秒,black 1366 毫秒。文件再少,black 也躲不掉这笔固定开销。
它到底查出什么
那 200 个文件一共报了 1400 条,按规则分:
| 规则 | 数量 | 能否自动修 |
|---|---|---|
| F401 导入但未使用 | 600 | 能 |
| I001 导入顺序不对 | 200 | 能 |
| PIE808 range 多余的起始值 | 200 | 能 |
| E722 裸 except | 200 | 不能 |
| F841 赋值后没用到的变量 | 200 | 不能 |
其中 1000 条带 [*] 标记,可以 --fix 自动改掉。剩下 400 条它特意不自动修:删掉一行 except 或者删掉一个变量都可能改变程序行为,交给人判断更安全。
报错末尾还会写 200 unsafe fixes available,指的是那 200 条要加 --unsafe-fixes 才动。默认不加,等于默认保守。
格式化产物和 black 一致
这一点比速度更值得说。同一批 200 个文件,分别用 ruff format 和 black 格式化,然后逐字节比对:
一致 200 个文件,不一致 0 个它不只是快,产物跟 black 完全对齐(至少在这批样本上)。原来跑 black 的仓库切过来,不需要重新排版整个代码库,改一条命令就行。想先验证一遍的项目可以两个都装着,用 ruff format --diff 对比差异再切换。
什么情况别换
规则集对不上时会一次炸出几百条。ruff 默认开的规则比 flake8 多,老项目第一次跑经常报几百上千条。正确做法是在 pyproject.toml 里先选规则集,或者分批打开,不要直接 --fix 全修。
它不做类型检查。变量到底是什么类型它不管,那是 mypy 和 pyright 的活。两者互补,不冲突,CI 里通常都跑。
批量 --fix 要过一遍 diff。F401 删 import 时,如果那个 import 有副作用(常见于注册插件或者打补丁),删掉程序就坏。这类文件在 per-file-ignores 里排除,别图省事全自动。
没测的部分列一下,3 项:上万文件的 monorepo 耗时 / 与 pylint 的规则覆盖差异 / CI 容器里的冷启动。