Faker 是生成假数据的库,七十多种 locale,能造姓名、地址、手机号、公司、邮箱、身份证、银行卡这些字段。写演示页面、造测试库、给截图打码都靠它。
它的接口很好用,但有两个数字值得先知道:造一万条要多久,以及造出来的数据到底有多不重复。
三行生成一条记录
from faker import Faker

fz = Faker("zh_CN")
print(fz.name(), fz.address(), fz.phone_number(), fz.company())
输出像这样,字段之间没有关联,每次调用各自独立随机:
李敏 | 山东省建平县上街嘉禾路j座 651161 | 18159407816 | 精芯信息有限公司
梁波 | 江西省浩市东丽孙路x座 934192 | 18632764835 | 时刻科技有限公司
赵鑫 | 广西壮族自治区汕尾县静安李路L座 253287 | 13301226916 | 商软冠联传媒有限公司
注意地址里的门牌是字母加数字,电话是符合国内号段的格式。它按 locale 内的模板拼,不是随机字符串。
一万条记录的速度
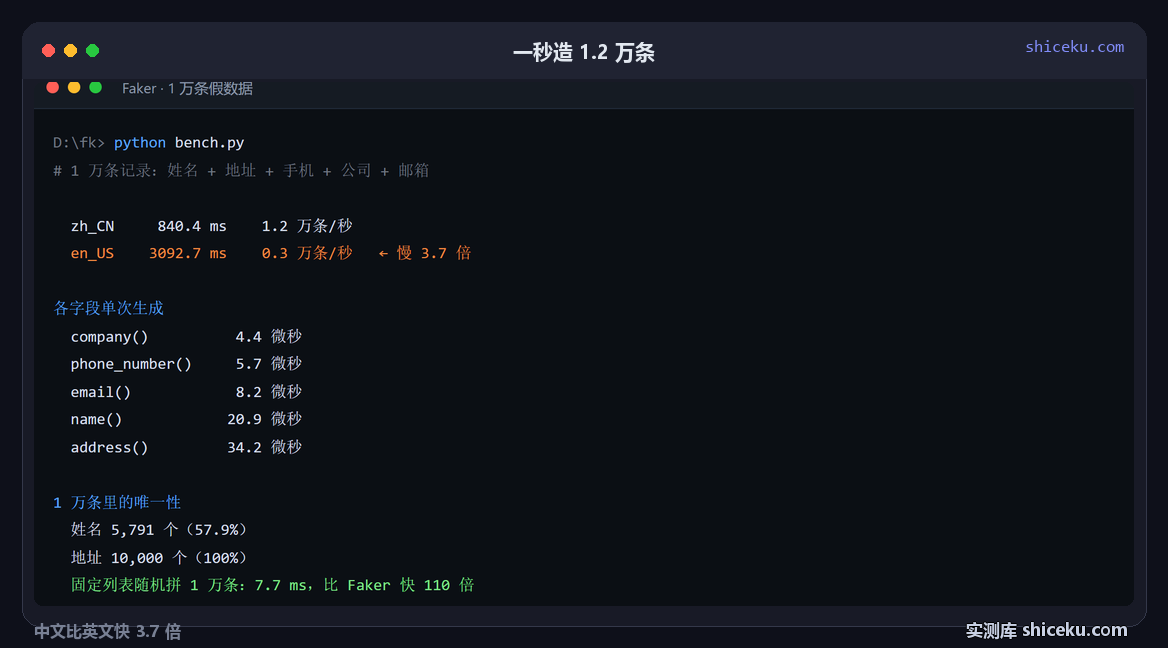
每条五个字段(姓名、地址、手机、公司、邮箱),各跑 3 次取中位:
| locale | 一万条耗时 | 速率 |
|---|---|---|
| zh_CN | 840.4 毫秒 | 1.2 万条/秒 |
| en_US | 3092.7 毫秒 | 0.3 万条/秒 |
中文比英文快 3.7 倍。差别在数据源:中文的姓名是姓表加名字表两段拼,英文要从更大的词库里选,地址模板的层级也更多。
各字段的成本不一样
| 字段 | 单次耗时 |
|---|---|
| company() | 4.4 微秒 |
| phone_number() | 5.7 微秒 |
| email() | 8.2 微秒 |
| name() | 20.9 微秒 |
| address() | 34.2 微秒 |
| text(50) | 21.4 微秒 |
address() 是最贵的,一次 34.2 微秒,因为它要拼省、市、区、路名、门牌五段。造十万条带地址的记录,光这一列就要 3.4 秒。
唯一性别指望
一万条记录里,各字段不重复的比例:
| 字段 | 唯一数量 | 唯一率 |
|---|---|---|
| 姓名 | 5,791 | 57.9% |
| 地址 | 10,000 | 100% |
| 手机号 | 10,000 | 100% |
姓名只有一半多不重复,因为中文姓名是「姓表 × 名字表」组合出来的,常用组合撞车很正常。想拿姓名当唯一键会踩坑。
需要唯一值有两个办法:给姓名后加序号,或者用 fz.unique.name()。后者内部维护一个已用集合,撞了就重试,数据量接近词库上限时会越来越慢,甚至抛 UniquenessException。
和固定列表手工拼比
Faker 造 1 万条:       840.4 ms
固定列表随机拼 1 万条:    7.7 ms    → 快 110 倍
手工版本就是 random.choice 从几个汉字表里取,两条数据 7.7 毫秒。差两个数量级,因为 Faker 每次调用都要走 provider 分发、查模板、格式化,保证字段看起来像真的。
所以选型看目的:只需要「一堆不重复的字符串」,手工拼足够;需要「看起来像真实的身份证号、地址、公司名」,Faker 省下的真实性设计远超这点性能差。
locale 写错会直接报错
>>> Faker("xx_XX")
AttributeError: Invalid configuration for faker locale `xx_XX`
它不静默回退到默认语言,写错就是异常。从配置文件里读 locale 的场景要做兜底。Faker(["zh_CN", "en_US"]) 可以一次给多个,每次随机选一个,适合造多语言混合数据。
需要结果可复现时用 Faker.seed(42),同一个种子两次跑出来的前几条完全一致,实测两次都是「梁鑫、李欣、蔡利」。CI 里造固定测试数据靠这个。
什么时候别用它
造百万级数据。按 1.2 万条/秒算,一百万条要 80 秒以上,还得算落库时间。造大库建议先生成模板再批量替换,或者直接用数据库的随机函数。
需要字段之间有关联。Faker 的姓名、地址、公司互相独立,造出来的「地址在山东、公司在北京、手机是广东号段」这种组合很常见。要合理的关联数据得自己按 locale 分组造。
填充真实业务表。它的数据格式对,但业务语义不对,用久了会污染测试断言。测试断言应该基于自己造的最小样本。
没测的部分列一下,3 项:unique 模式在上万条时的实际耗时 / 各 locale 的唯一率对比 / 与 mimesis 的速度差异。