tantivy 是 Rust 写的全文搜索引擎,tantivy-py 是它的 Python 绑定。它不像 meilisearch 那样起一个服务,索引就跑在你的进程里,一个 pip 包装完就能用。
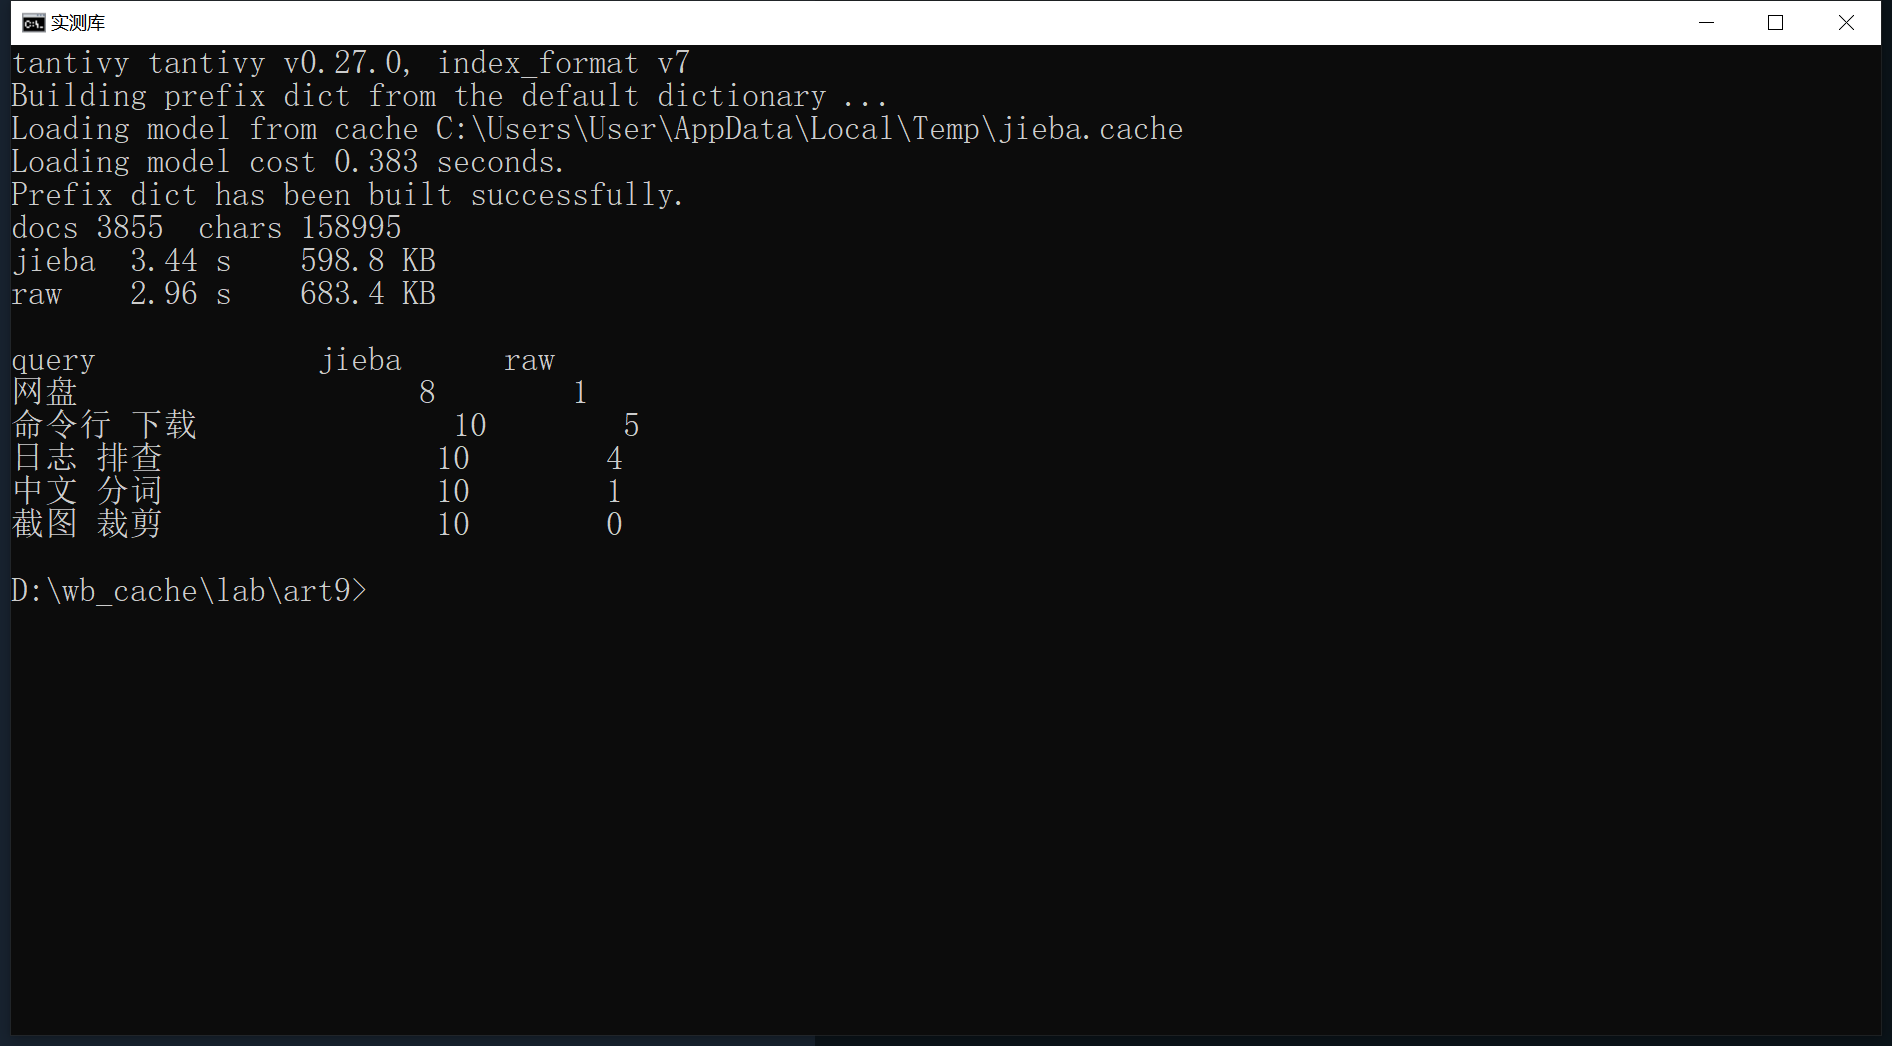
拿站内 77 篇文章的 158995 字正文做实测:3855 条文档建索引 3.44 秒,索引文件 598.8 KB,单词查询 0.01 毫秒。中文这块有个必须自己处理的坑,下面单独说。
装完就是一个 import
pip install tantivy
python -c "import tantivy; print(tantivy.__version__)"
tantivy v0.27.0, index_format v7
版本号里那个 index_format 是索引格式版本。它决定了磁盘上的索引能不能被别的版本读:换大版本时旧索引读不了,得重建。这一点在升级前要看一眼。
整个包只有 Rust 编译的扩展,没有服务、没有端口、没有配置文件。进程退出索引还在磁盘上,下次打开接着用。
3855 条文档,3 秒建完
先把语料按句切成 3855 条,每条 20 到 300 字,加起来 158995 字。两种建法对比:
| 建法 | 耗时 | 索引体积 | 说明 |
|---|---|---|---|
| jieba 分词后写入 | 3.44 秒 | 598.8 KB | 词条按空格切开 |
| 原样写入 | 2.96 秒 | 683.4 KB | 整句当一个大词 |
| 文档数 | 3855 条 | 158995 字 | 平均 41 字一条 |
| jieba 词典加载 | 0.38 秒 | — | 首次 import 时一次性 |
分词多花 0.48 秒(3.44 对 2.96,慢 16%),换来索引小 12.4%(598.8 KB 对 683.4 KB)。慢的部分全在 jieba 切词,索引变小是因为不分词时每条整句都被当成一个超长词条,词典里存的是重复的长字符串;分词后同一个词只存一份,倒排表压得更狠。
3.44 秒里有 0.38 秒是加载 jieba 词典,0.48 秒是切词,剩下的在写倒排表和刷盘。这批文档平均 41 字一条,分词开销比长文场景要高一些。
中文不分词,等于没建索引
这是用之前必须先搞清楚的事。tantivy 默认按空白和非字母字符切词,中文整句会被当成一个词。同样的五个查询,两种索引的命中数:
| 查询 | jieba 分词命中 | 原样写入命中 | 差距 |
|---|---|---|---|
| 网盘 | 8 条 | 1 条 | 8 倍 |
| 命令行 下载 | 10 条 | 5 条 | 2 倍 |
| 日志 排查 | 10 条 | 4 条 | 2.5 倍 |
| 中文 分词 | 10 条 | 1 条 | 10 倍 |
| 截图 裁剪 | 10 条 | 0 条 | 完全搜不到 |
「截图 裁剪」在没分词的索引里命中 0 条,因为文档里存的是「把截图裁成 1200 宽」这种整句,查询词一个都匹配不上。这不是参数没调好,是索引里根本没有「截图」这个词条。
解决办法只有两个:写入前用 jieba 切好,或者在 tantivy 里注册一个中文 tokenizer。前者简单,改一行 " ".join(jieba.cut(text)) 就够。
查询快到没有测量意义
建好索引后 reload 一次,之后每次查询都是内存里的倒排表查找:
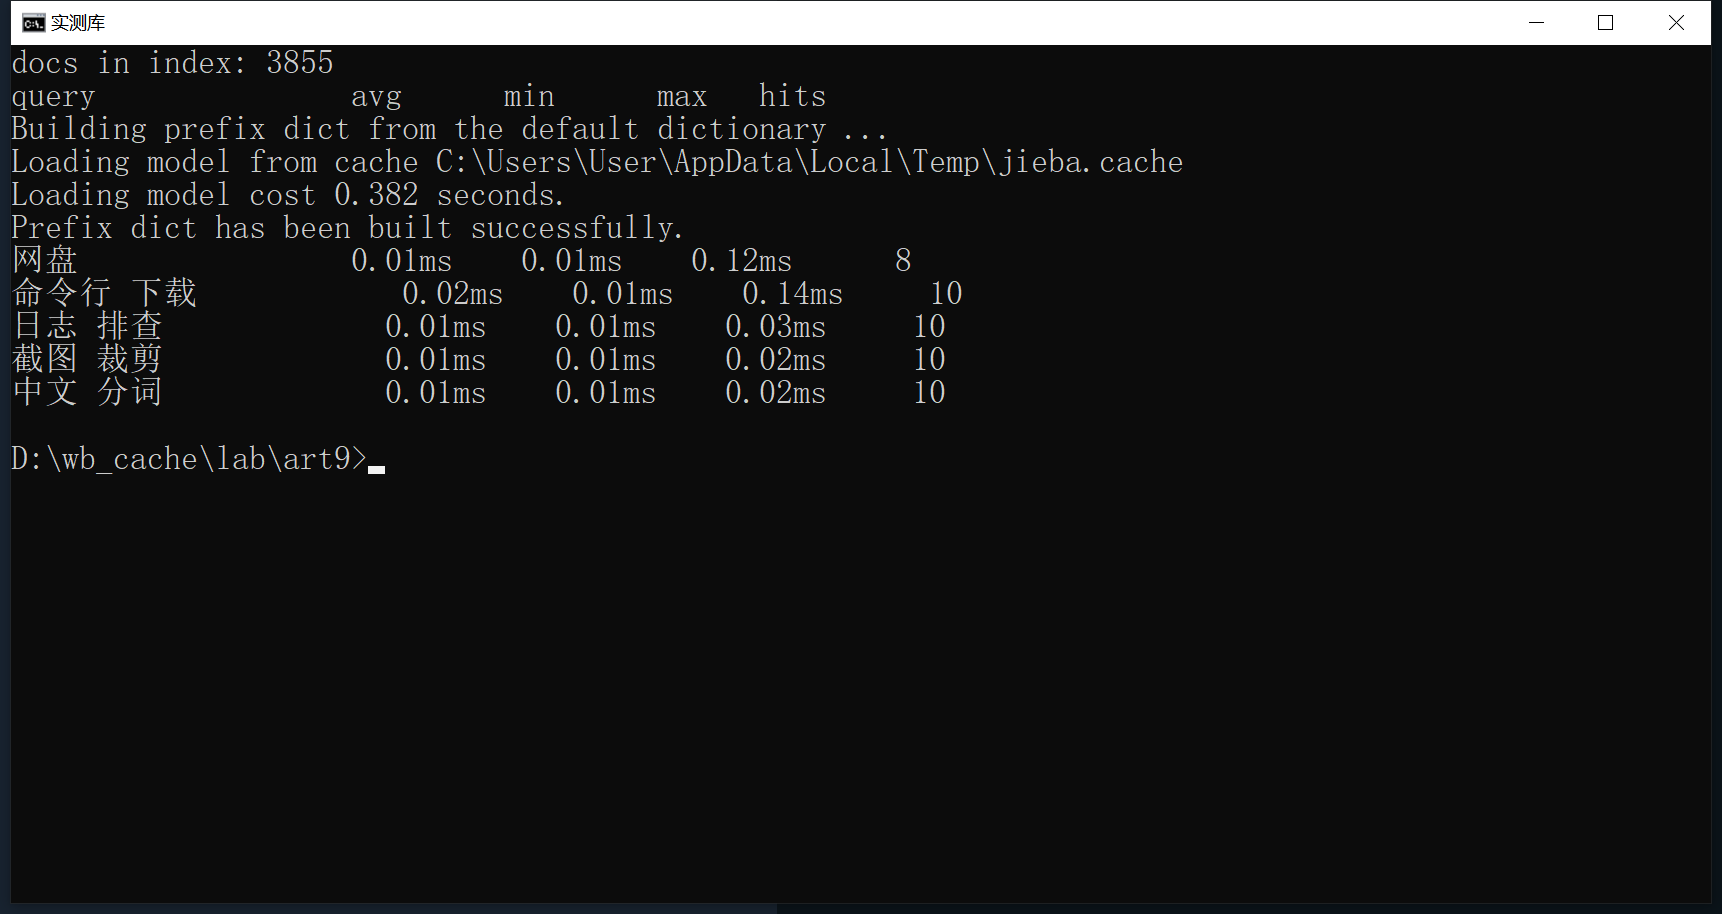
单词查询 20 次:平均 0.01 毫秒(0.01 - 0.02)
网盘        0.01 毫秒   命中 8 条
命令行 下载  0.02 毫秒   命中 10 条
截图 裁剪 0.01 毫秒 命中 10 条| 指标 | 数值 |
|---|---|
| 单词查询均值 | 0.01 毫秒 |
| 单词查询最快 | 0.01 毫秒 |
| 单词查询最慢 | 0.02 毫秒 |
| 多词查询均值 | 0.01 到 0.02 毫秒 |
| 索引体积 | 598.8 KB |
0.01 毫秒这个数字已经接近 Python 函数调用的开销本身,再往下测就是噪声。真正花时间的地方在读盘和第一次 reload,查询本身可以忽略。
这也是「嵌进进程」的好处:不用走 HTTP、不用序列化请求,查一次就是一次函数调用。搜索框做即时联想(每敲一个字查一次)完全撑得住。
索引比原文小一半
158995 字的语料,UTF-8 存下来大约 470 KB。建完的索引 598.8 KB,比原文大一点,这是倒排表加上词频位置的正常开销。
但对比另外两种做法就有区别了:meilisearch 那类服务端方案,索引之外还要常驻一个进程和一块内存;纯 SQL 的 LIKE 查询不需要索引,可 3855 条文档扫一遍要几十毫秒,而且不支持相关度排序。598.8 KB 换来 0.01 毫秒和按 BM25 排好的结果,这个交换在本地知识库场景里很划算。
三件会踩的事
第一件是 schema 定了就不能改。字段类型、分词方式写在 schema 里,改完必须重建索引,旧数据读不出来。要加字段就准备好重跑一遍建索引的脚本。
第二件是 index.reload() 的时机。写入方 commit 之后,读的一方不 reload 就看不到新数据,而且不会报错,只是查出来是旧结果。
第三件是并发。同一个索引目录只能有一个 writer,多进程同时写会报锁冲突。多进程只读没问题,写入要收口到一个进程里排队。