syft 是 Anchore 出的 SBOM 生成器,把一个目录或者容器镜像里装了哪些软件、什么版本,全列出来。它不需要 Docker daemon,扫描对象可以就是磁盘上的一个文件夹。
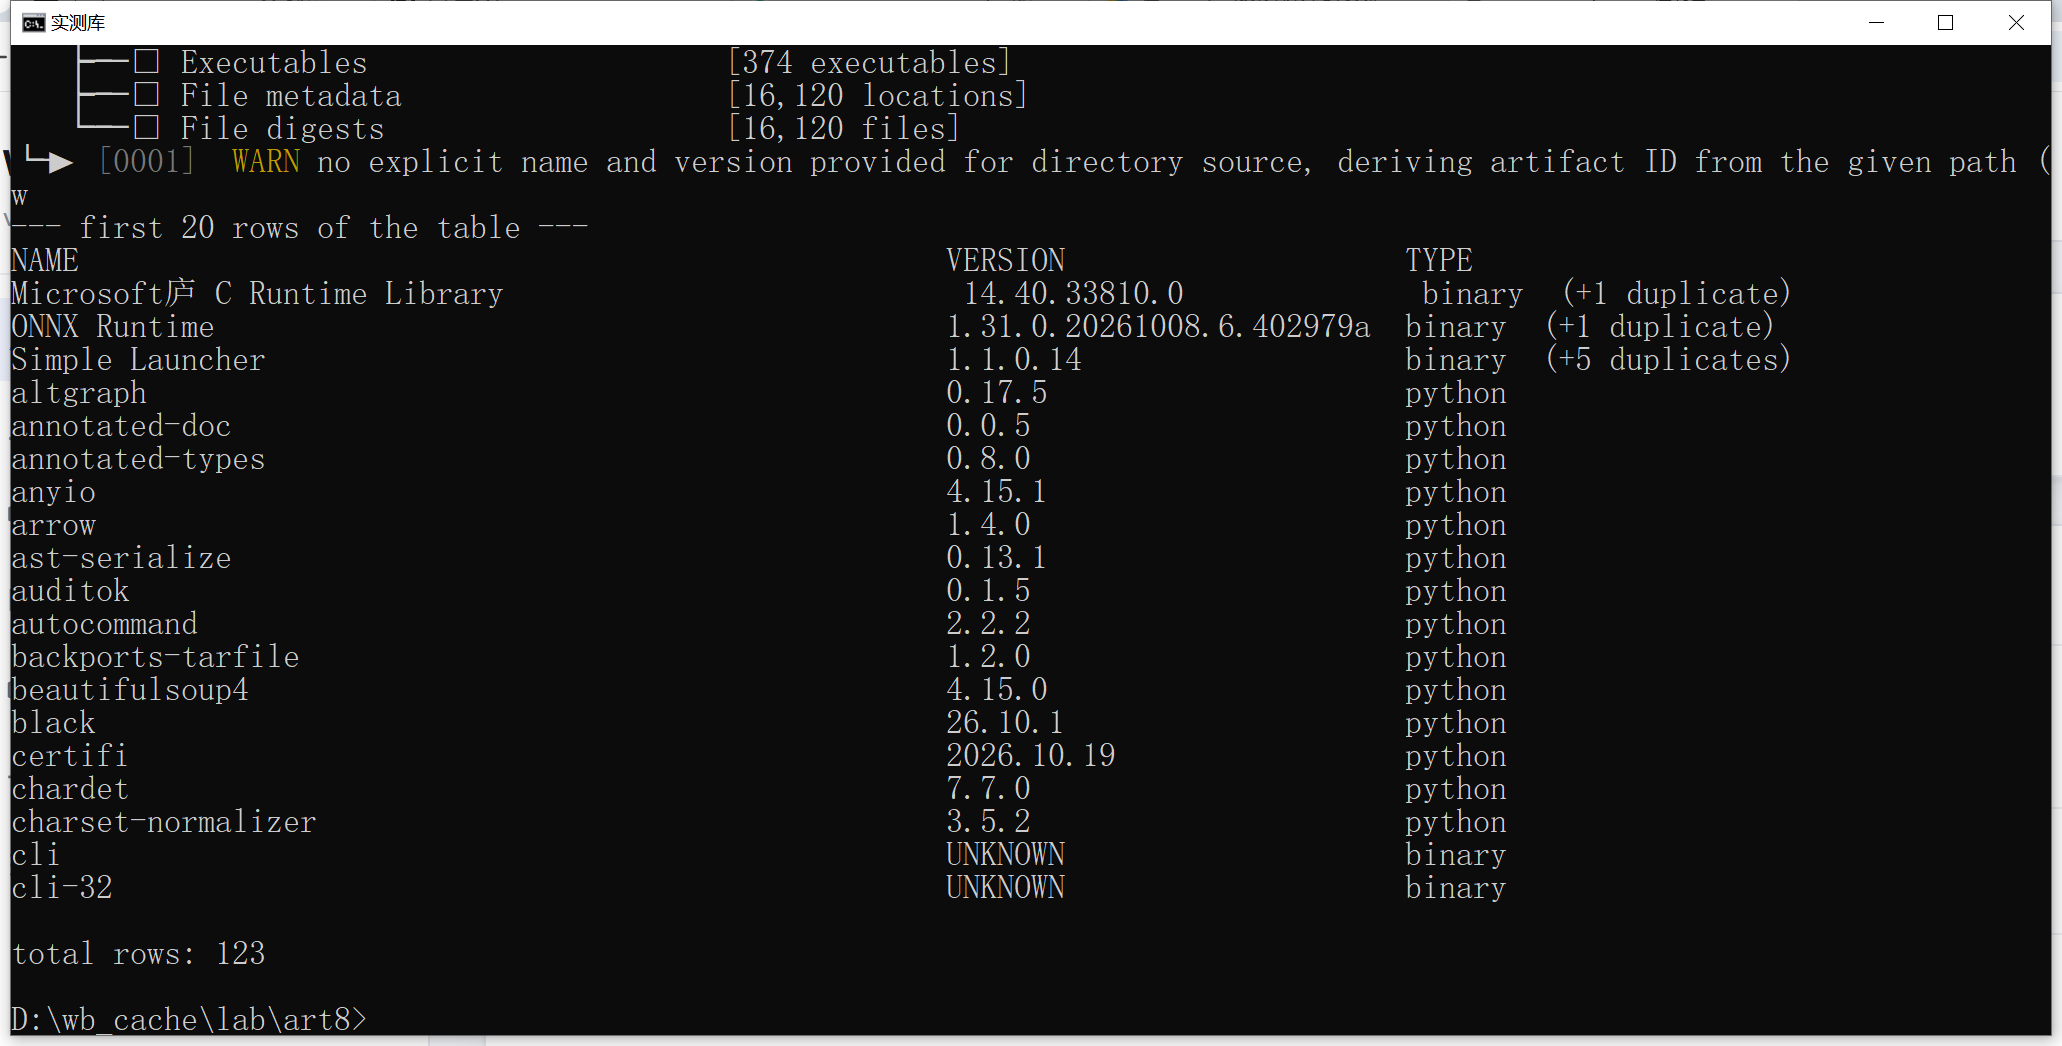
拿一个 400 MB、16120 个文件的 Python 环境做实测:13.80 秒扫出 130 个条目,去掉重复后 122 个包。产出的 JSON 是 10023874 字节,平均每个包占 77 KB。
85 MB 的 exe,不需要 daemon
syft version
Application:   syft
Version:       1.55.0
BuildDate:     2026-10-19T18:54:46Z

syft scan dir:D:\lab\venv\Lib\site-packages -o table
可执行文件 89968640 字节,Go 静态编译,不依赖外部工具。扫描目标用前缀区分:dir: 是目录,image: 是容器镜像,file: 是单个文件。
用 dir: 的好处是不用装 Docker。这次实测全程没有 Docker daemon 参与,扫的就是磁盘上一个 Python 虚拟环境的包目录。
400 MB 环境,13.80 秒出 122 个包
| 指标 | Python 包目录 | 单个工具目录 |
|---|---|---|
| 目标体积 | 400 MB | 60 MB |
| 文件数 | 16120 个 | — |
| 扫描耗时 | 13.80 秒 | 2.25 秒 |
| 命中条目 | 130 个 | 2 个 |
| 去重后的包 | 122 个 | 2 个 |
| 表格输出行数 | 123 行 | 3 行 |
| binary 类型 | 23 个 | 2 个 |
| python 类型 | 107 个 | 0 个 |
| syft exe 体积 | 89968640 字节 | — |
| 每 GB 扫描耗时 | 34.5 秒 | 37.5 秒 |
| 重复条目 | 8 个 | 0 个 |
130 个条目里 8 个是重复的,去重后 122 个。重复来自同一个包在多个位置出现,比如包的元数据目录和实际代码目录各被认了一次。
耗时和体积大致成比例:400 MB 用 13.80 秒,60 MB 用 2.25 秒,折算下来每 GB 都在 34.5 秒到 37.5 秒之间。瓶颈在读文件和解析元数据,不在匹配规则。
表格看结果,JSON 给机器
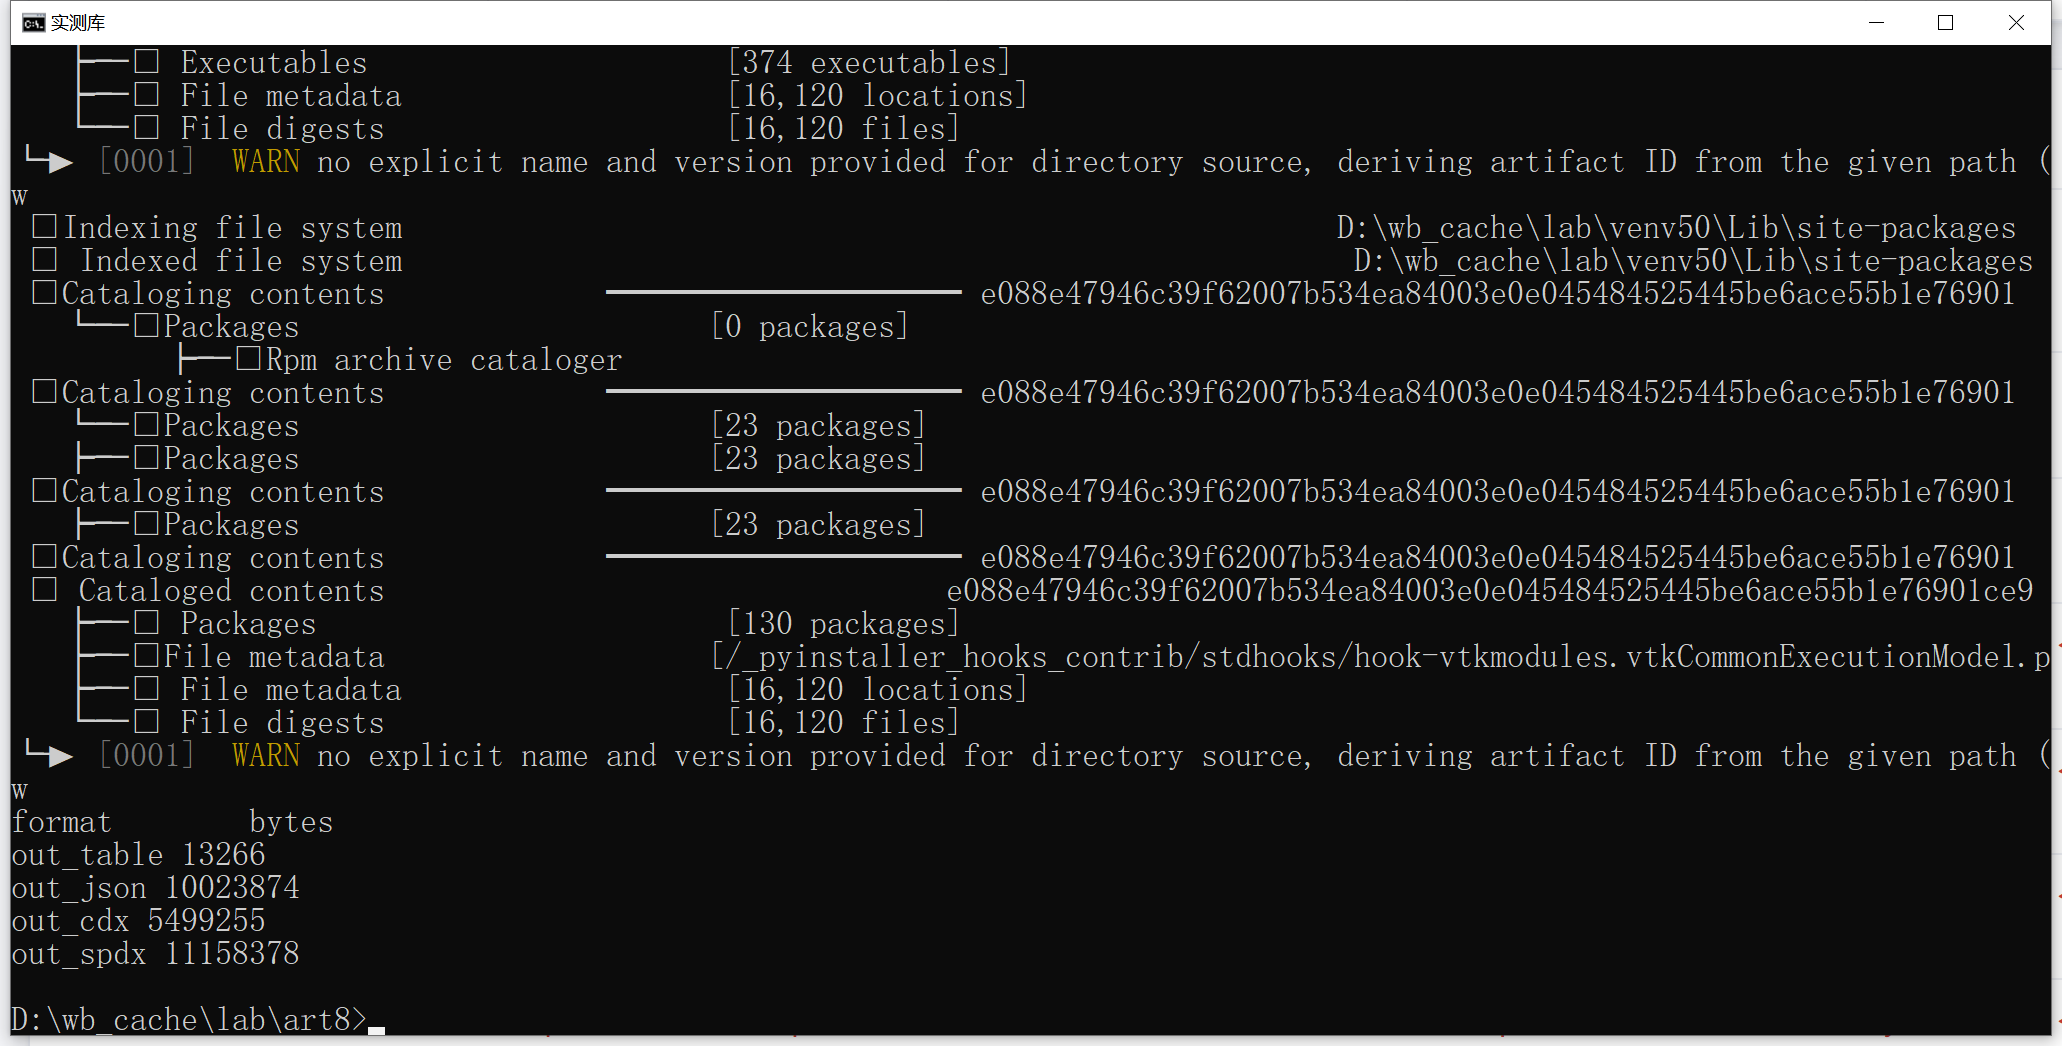
同一份扫描结果,四种输出格式的体积差得很远:
| 格式 | 耗时 | 体积 | 平均每包 | 用途 |
|---|---|---|---|---|
| table | 12.00 秒 | 13266 字节 | 123 行 | 人看 |
| json | 10.94 秒 | 10023874 字节 | 75.3 KB | 进流水线 |
| cyclonedx-json | 10.93 秒 | 5499250 字节 | 41.3 KB | 交给下游工具 |
| spdx-json | 11.17 秒 | 11158358 字节 | 83.8 KB | 合规归档 |
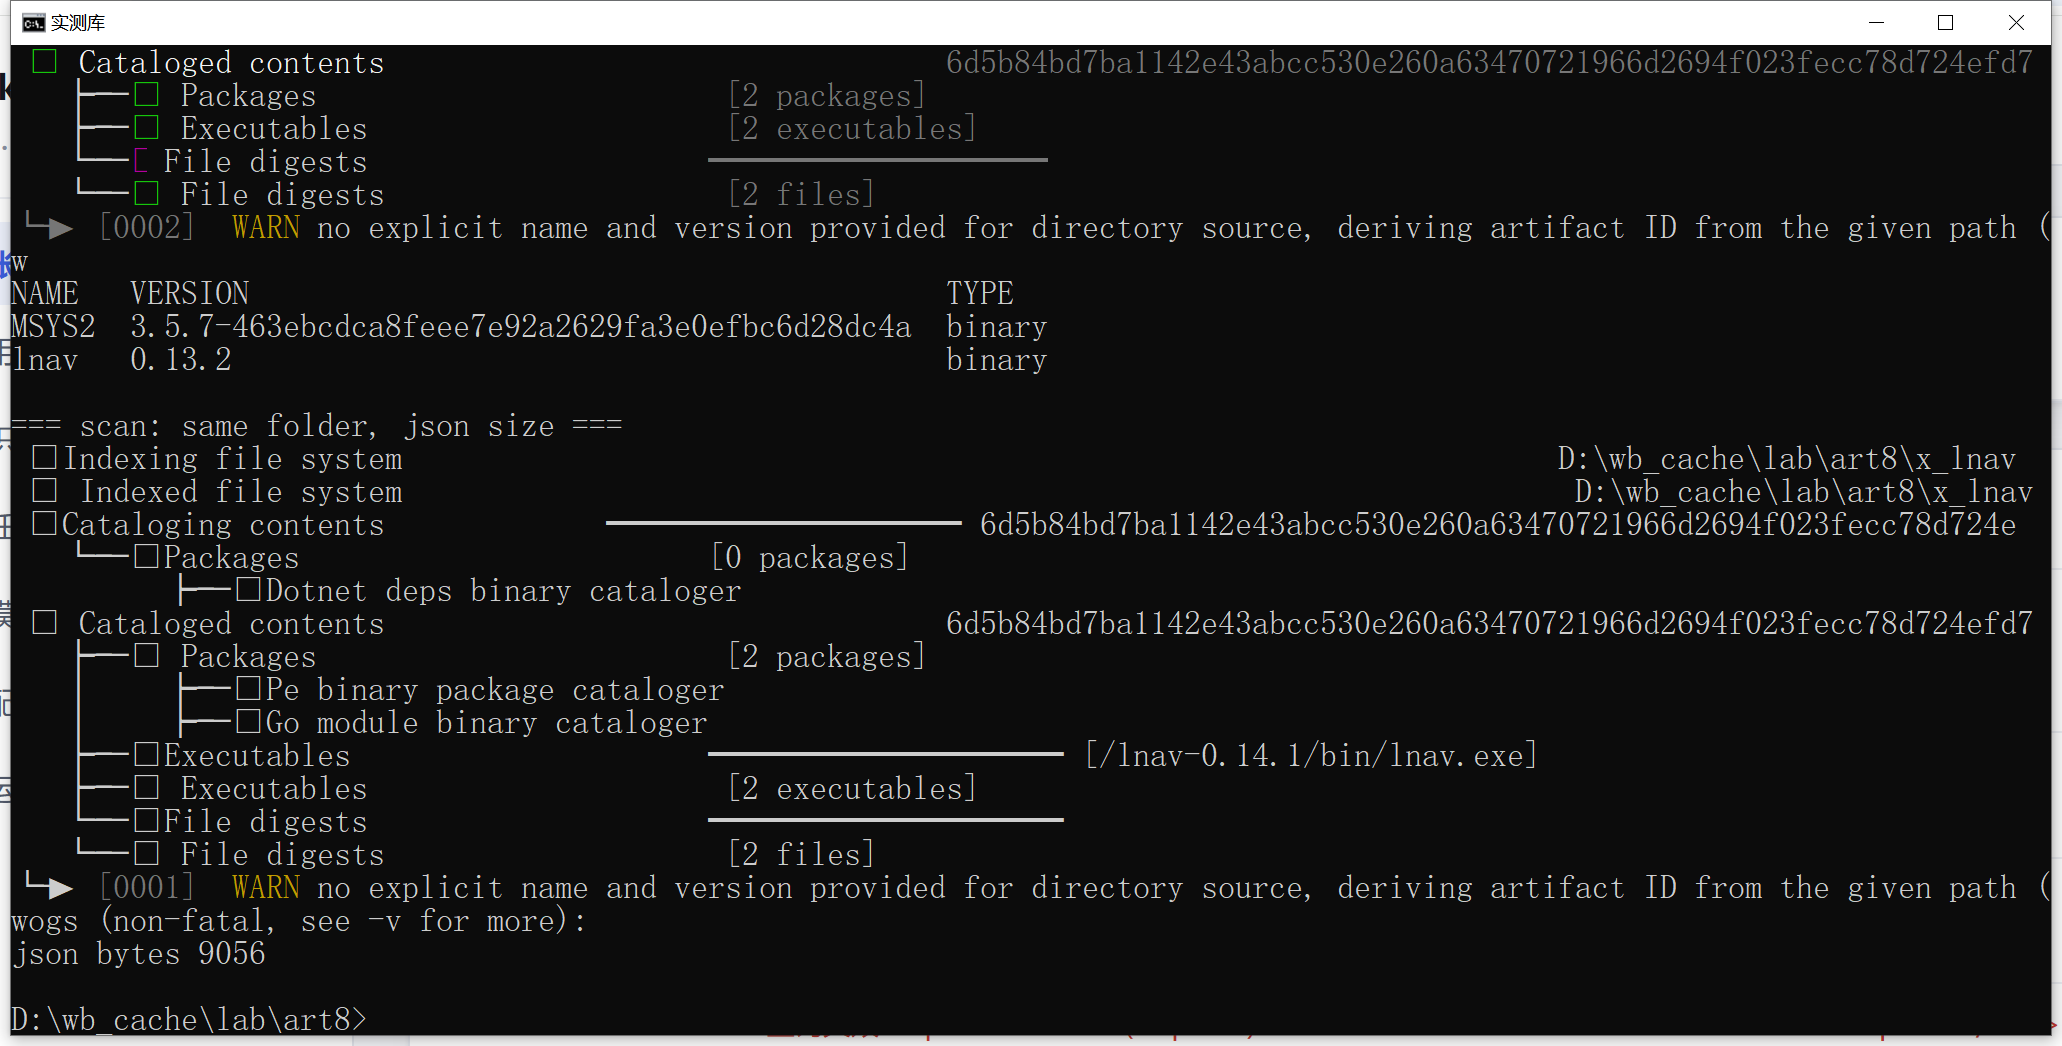
| 单工具目录 json | 2.25 秒 | 9048 字节 | 4.5 KB | 2 个 binary |
| cyclonedx 相对 json | — | 0.55 倍 | — | — |
| cyclonedx 比 json 小 | — | 45% | — | — |
cyclonedx-json 比默认 json 小 45%,扫描耗时基本一样(10.93 秒对 10.94 秒)。差别在内容取舍:syft 自己的 json 带了很多扫描器元信息,CycloneDX 只留标准字段。
如果下游只是要「包名 + 版本 + 许可证」,没理由存 10 MB 那一份。这个选择能直接把存储成本砍掉一半,而且不影响任何检测逻辑。
体量上的现实是:SBOM 不适合放进代码仓库。一个 Python 环境就能产出 10 MB,跑十几次就是上百 MB 的历史记录,放在制品库或者对象存储里更合适。
只认它认识的包管理器
syft 的识别靠的是包管理器的元数据文件:Python 看 *.dist-info 和 *.egg-info,Node 看 package.json,Go 看编译进二进制的模块信息,系统包看 dpkg / rpm 数据库。
如果目录里没有包管理器的元数据文件,syft 会漏掉里面的 dll,一个 python 包都扫不到。实测那个 60 MB 的工具目录只认出 2 个 binary,剩下的 dll 和配置文件全都在结果之外。
这是设计上的取舍:SBOM 要的是「装了什么软件」,不是「有哪些文件」。想要完整的文件清单,配 --scope all-layers 加上文件清单输出,体积会比这 10023874 字节再翻几倍。
还有一个更细的偏差:版本号读的是二进制里的字符串,跟程序自己报的可能不一致。实测那个目录里的 lnav,运行 lnav -V 报 0.14.1-dirty,syft 认成 0.13.2。拿 SBOM 对漏洞通告时,这种偏差会让匹配漏掉。
什么时候值得跑
持续集成里给每个构建产物生成一份 SBOM,是现在供应链安全的基本动作。漏掉一个依赖的漏洞通告,靠人工翻 lock 文件很难查全,而 122 行的 SBOM 里一条 SQL 就能对上。
13.80 秒扫 400 MB 这个速度,放在构建流水线里不算负担。真正需要提前想清楚的是产出的存放位置和保留周期:10023874 字节一份、每次构建一份,一年下来就是几十 GB。