Ollama 是本地跑大模型的运行时,装完起 2 个进程:桌面版界面和一个监听 11434 的服务,模型按需拉。桌面版还带一个聊天界面,能直接对着本地模型提问。这篇在 Windows 上用它跑了一个 14B 的 qwen2.5,把加载耗时、生成速度和显存占用,还有 OpenAI 兼容接口都实测了一遍。
装完只有一个端口,模型自己拉
客户端版本   0.40.0
服务端口     127.0.0.1:11434
模型目录     D:\wegale\模型
已装模型     qwen2.5:14b  8,988,124,069 字节
量化格式 Q4_K_M,参数量 14.8B,上下文 32768服务跟客户端分开跑:ollama app.exe 起界面和服务,ollama.exe 是命令行。模型目录在设置页里能改,实测这台机器放在 D 盘,C 盘用户目录下的 models 是空的。装完没有任何向导,第一步就是拉模型。
拉一个 0.5B 试水,379 MB 用了 263 秒
ollama pull qwen2.5:0.5b
体积        379 MB
耗时        263 秒
平均速度    约 1.4 MB/s
拉取走的是 HTTP 流式接口,进度按百分之一报,每一块都有 sha256 校验,最后一步是 writing manifest。速度取决于到 registry 的线路,跟模型大小无关。拉完在 /api/tags 里却没有它,只有原来那个 14B,原因见最后一节。
14B 第一次出字,62 秒全在加载
POST /api/generate   num_predict=160
total_duration        64.13 秒
其中 load_duration    62.12 秒
prompt 48 tokens      0.11 秒(426.9 tok/s)
生成 58 tokens        1.88 秒(30.88 tok/s)
第一次请求把 8.99 GB 的权重从磁盘读进显存,62.12 秒全花在这一步。模型常驻之后,同样的提问几秒就能出完,加载是一次性成本。想省掉这段等待,可以在服务启动后先发一条空请求预热。
出字 30.88 tok/s,提示词处理快 13 倍
| 指标 | 数值 | 说明 |
|---|---|---|
| 生成速度 | 30.88 tok/s | 58 个 token 用 1.88 秒 |
| 提示词处理 | 426.9 tok/s | 48 个 token 用 0.11 秒 |
| 显存占用 | 9,470,098,799 字节 | size 与 size_vram 相等,全部在显存 |
| 运行时上下文 | 4096 | 模型本身支持 32768,默认只开 4096 |
| 推理后端 | llamacpp | /api/ps 里读到的 runner 字段 |
30.88 tok/s 意味着每秒 30 来个字,读起来跟人打字差不多快,长回答会明显感到等待。提示词处理比生成快一个数量级,所以喂长文档不贵,贵的是让它从头写。
OpenAI 那套接口照抄就能用
POST http://127.0.0.1:11434/v1/chat/completions
请求 {"model":"qwen2.5:14b","messages":[{"role":"user","content":"把「今天下雨了」翻译成英文,只给译文。"}]}
耗时 0.34 秒
返回 It rained today.
usage {"prompt_tokens":44,"cached_tokens":24,"completion_tokens":6}
模型常驻之后这条请求 0.34 秒就回来了,其中 24 个提示词命中了缓存。原来调 OpenAI 的代码只改三处:base_url 换成这个地址,key 随便填一个非空字符串,模型名换成 tags 里的名字。/v1/embeddings 也在同一套路径下,做检索类应用不用再找别的服务。
桌面 App 把云端和本地混在一列
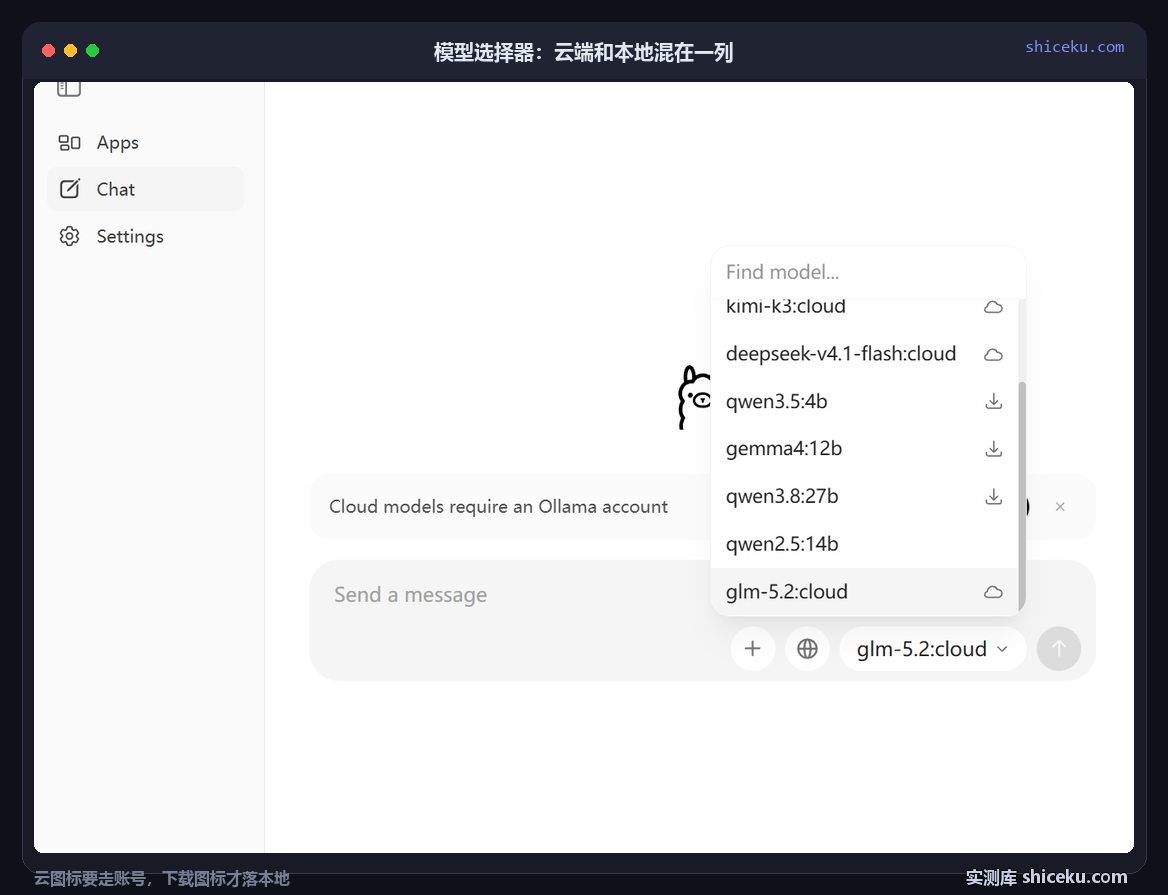
界面分 3 页:Apps / Chat / Settings。Chat 页的模型选择器里,带云图标的条目要走 Ollama 账号,带下载图标的才是本地模型。这台机器上只装了 qwen2.5:14b 一个,其余 qwen3.5:4b、gemma4:12b 都是没下载的目录项,点一下才开始拉。
| 界面元素 | 实测状态 |
|---|---|
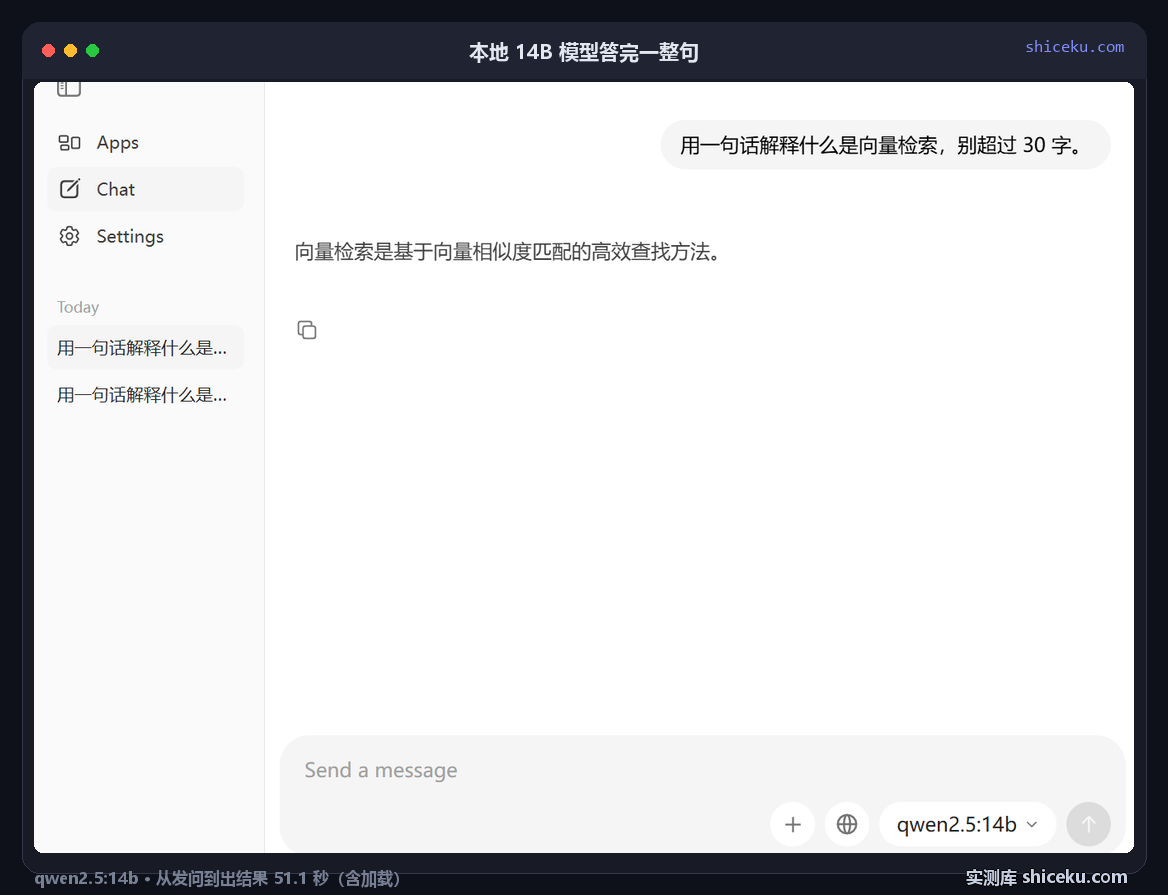
| Chat 页提问到出结果 | 51.1 秒(含 62 秒加载被摊薄后的首轮) |
| 回答内容 | 向量检索是基于向量相似度匹配的高效查找方法。 |
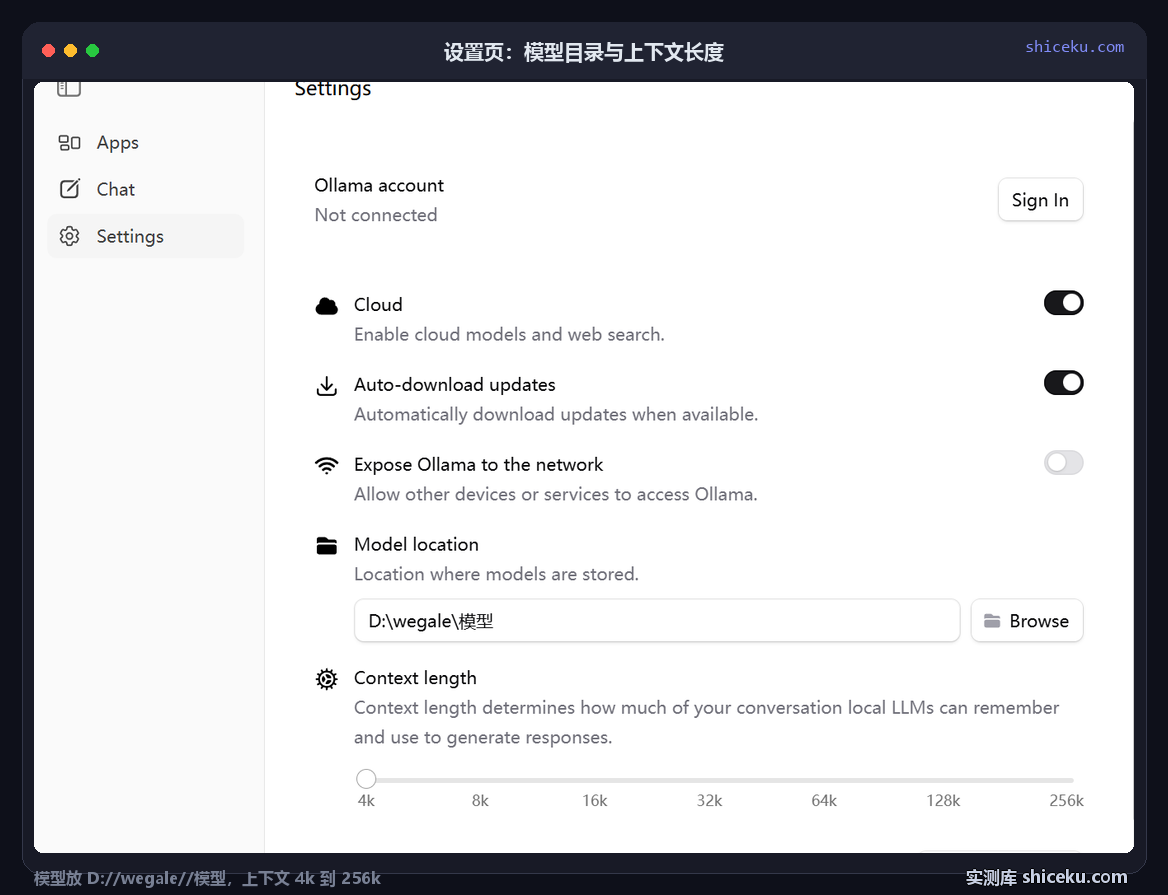
| 模型目录 | D:\wegale\模型,可点 Browse 改 |
| 上下文长度 | 滑块 4k 到 256k,默认停在 4k |
| Expose Ollama to the network | 默认关闭,局域网访问要先打开 |
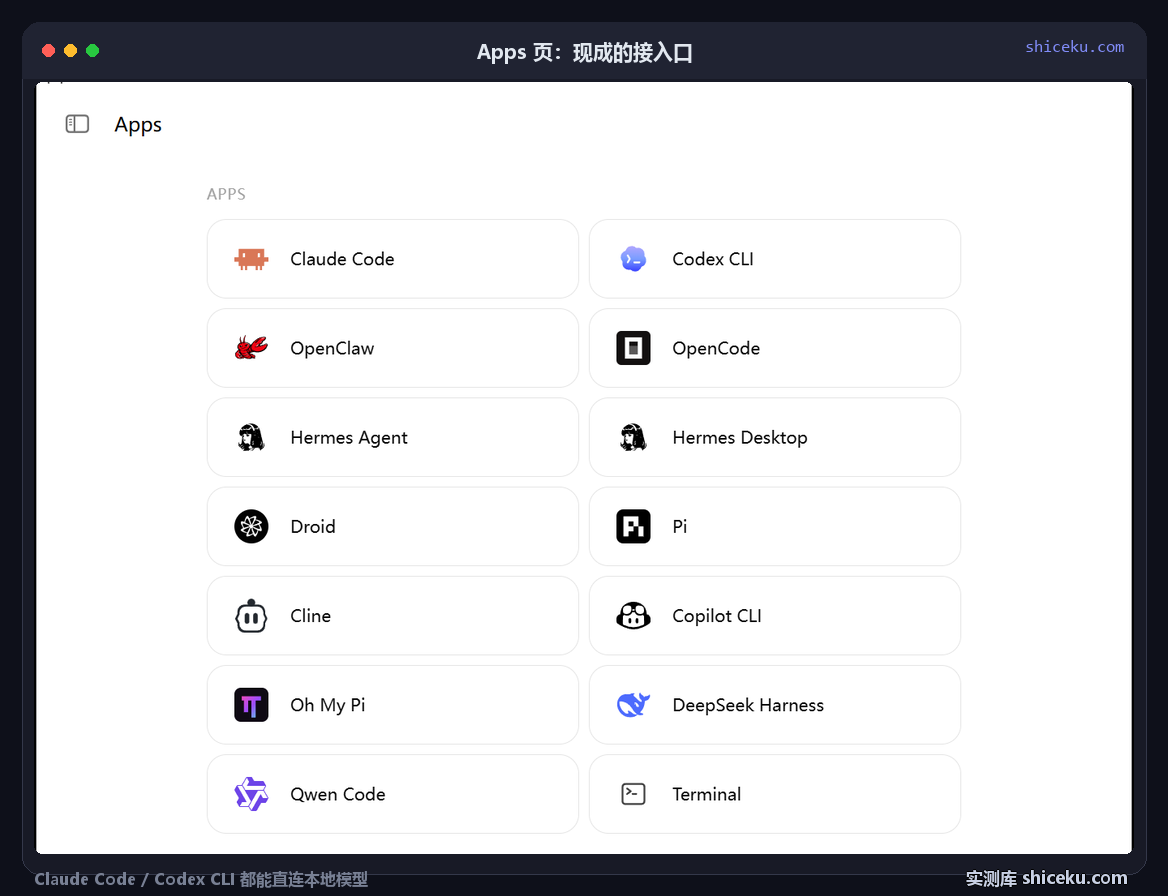
Apps 页一屏 14 个卡片,列的都是接入口,Claude Code / Codex CLI / OpenCode / Cline 这些工具都能一键接上本地模型,每个卡片右边有个复制按钮,把命令行参数复制出来贴到终端里就行。这一页的价值在于省掉配环境变量。
9.47 GB 全进显存,3060 刚好压住
显卡        NVIDIA GeForce RTX 3060,12288 MiB
驱动        576.88
模型文件    8.99 GB(磁盘)
运行时占用  9.47 GB(显存)
差出来的部分  上下文缓存与计算缓冲
12 GB 显存刚好放下这个 14B 的 Q4 模型,余量不到 3 GB。换成 27B 那一档就会溢出到内存,速度掉到个位数。判断能不能跑,先看模型体积加两三个 G 的余量够不够,别只看参数量。
那一坨没进列表的模型
实测踩到一个坑:拉完 qwen2.5:0.5b,/api/tags 里依然只有 qwen2.5:14b。原因是服务从环境变量 OLLAMA_MODELS 读目录,桌面版和命令行各自启动的服务会用不同的目录,拉下来的模型落在另一个位置,列表自然看不到。只要拉完列表里没出现,先核对这个变量,别急着重装。
实测范围:Windows 10 22H2(10.0.19045.6466) / Ollama 0.40.0 / qwen2.5:14b Q4_K_M / RTX 3060 12 GB / 2026-10-21。多模型并发 / 视觉模型 / 工具调用 / 局域网共享都没有验证,不作结论。