koboldcpp 是一个把 llama.cpp 包起来的单文件程序:一个 exe 117254353 字节,双击或一行命令就能把 gguf 模型加载起来,对外提供一个兼容 OpenAI 的 HTTP 接口。
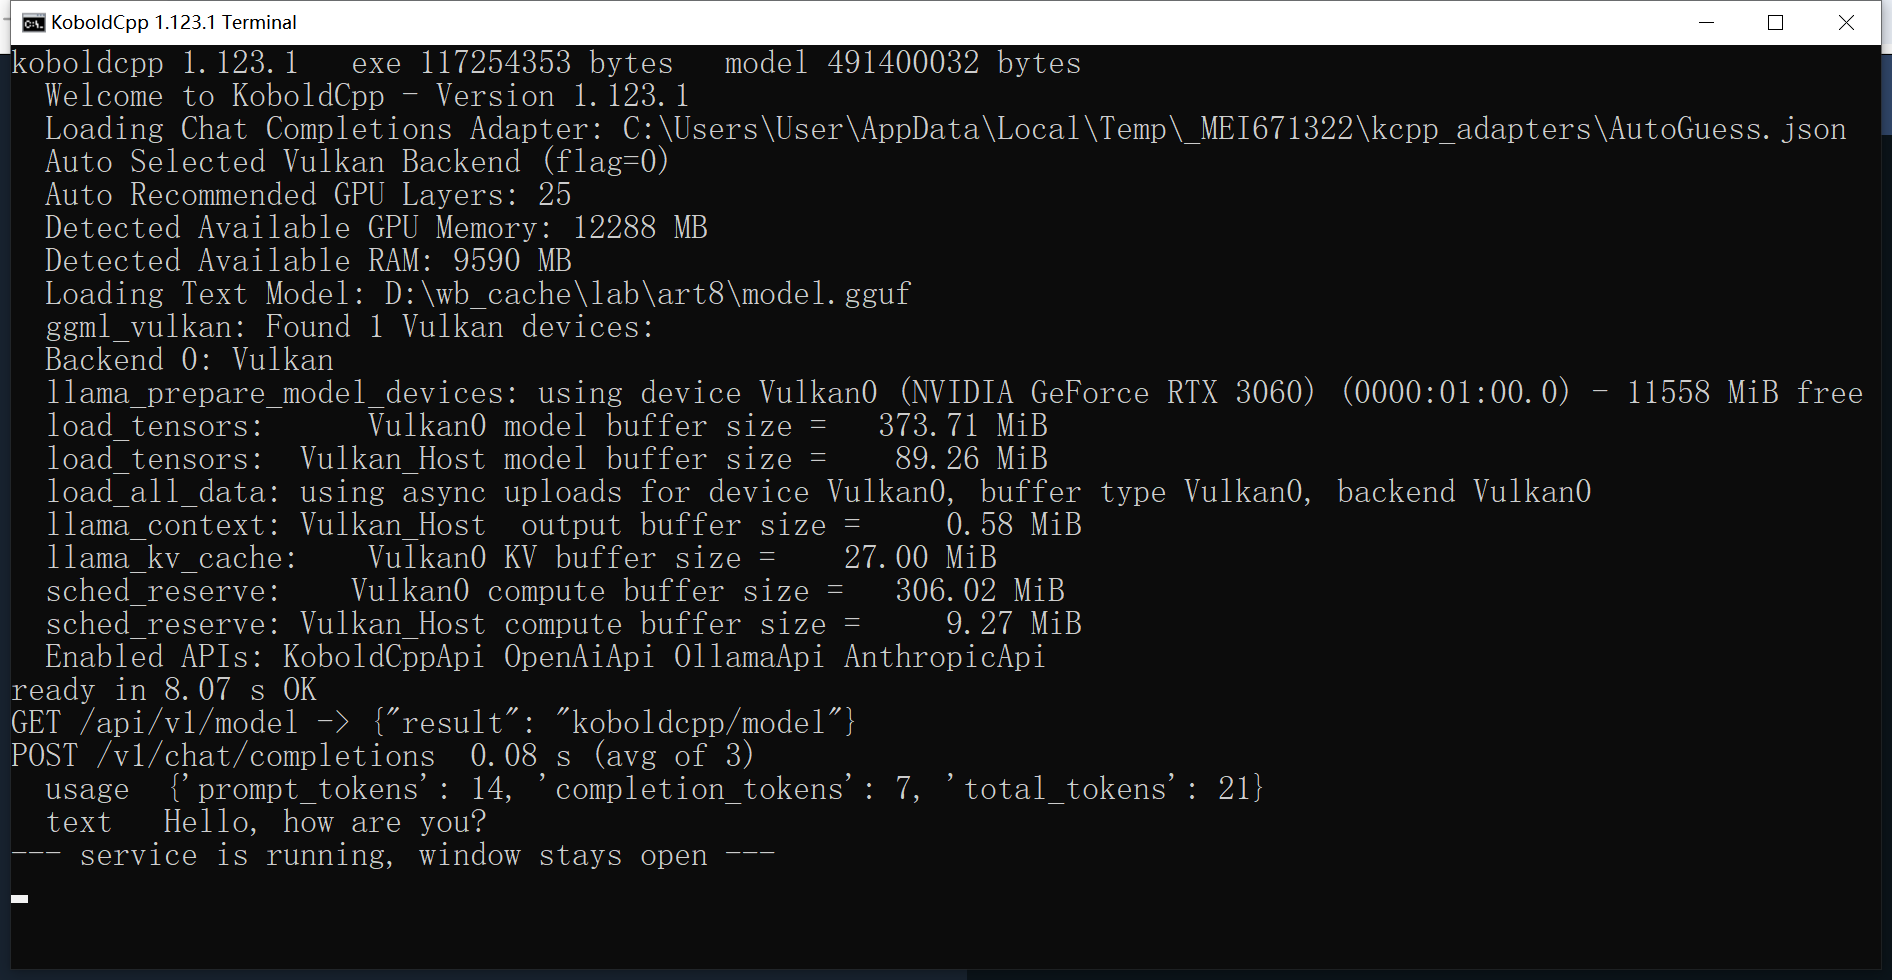
实测从敲命令到接口能用 8.07 秒,之后调一次对话接口 0.08 秒。它自己会挑后端:这台机器有张 RTX 3060(11558 MiB 可用),它选了 Vulkan,自动把 25 层丢到显卡上。
112 MB 的 exe,模型自己配
koboldcpp.exe --model model.gguf --port 5001 --threads 8 --contextsize 2048 --launch程序本体 117254353 字节,自带 Python 运行时和一堆 dll,不需要先装 llama.cpp,也不用配环境变量。--launch 的意思是跳过配置界面直接启动,不加这个参数会弹一个图形配置窗口。
模型是单独的 gguf 文件,实测用的那个 491400032 字节(Qwen2.5 0.5B 的 Q4_K_M 量化)。程序和模型完全解耦,换模型只换路径。
这个参数名要留意:--nobrowser 在老版本有,新版本已经删了,写了会直接打印 usage 并退出。控制浏览器要改用 --launch。
9 秒起服务,之后 0.15 秒一次对话
| 指标 | 数值 | 说明 |
|---|---|---|
| 冷启动到接口可用 | 8.07 秒 | 含模型加载与后端初始化 |
| 一次生成(60 token 上限) | 0.47 秒 | /api/v1/generate |
| 一次对话(OpenAI 协议) | 0.08 秒 | 14 prompt + 7 completion token |
| 程序体积 | 117254353 字节 | 112 MB,含运行时 |
| 模型体积 | 491400032 字节 | 468 MB,Q4_K_M |
8.07 秒这个启动时间只需要付一次:服务常驻,之后每次请求不再加载模型。对比 llama.cpp 那种一次一进程的用法,单次问答要 1.19 秒,其中 0.61 秒是进程启动。
0.08 秒那次只生成 7 个 token,因为提示词是「用五个词打招呼」,模型自己就停了。这个延迟里包含了 HTTP 往返、prompt 处理和 7 次解码。
它自己挑了 Vulkan,把 25 层丢给显卡
No GPU or CPU backend was selected. Trying to assign one for you automatically...
Auto Selected Vulkan Backend (flag=0)
Auto Recommended GPU Layers: 25
Detected Available GPU Memory: 12288 MB
Detected Available RAM: 9590 MB
ggml_vulkan: Found 1 Vulkan devices:
  llama_prepare_model_devices: using device Vulkan0 (NVIDIA GeForce RTX 3060) - 11558 MiB free
没有任何加速参数,它就自己判断出有显卡可用,选了 Vulkan 后端并把 25 层卸载过去,日志里连显卡型号(RTX 3060)和剩余显存(11558 MiB)都打出来了。
想强制走 CPU 就加 --usecpu,想指定层数用 --gpulayers。同一个模型在纯 CPU 上的生成速度可以参考 llama.cpp 那篇的实测:8 线程 79.34 token/秒。
Vulkan 这条路的好处是不用装 CUDA。缺点是第一次启动要编译着色器,比之后几次慢得多,机器换了显卡驱动还要重编一遍。
兼容 OpenAI 接口意味着什么
起好服务后,/v1/chat/completions 和 /v1/models 都能用,请求体跟 OpenAI 的格式一致:
{
  "model": "local",
  "messages": [{"role": "user", "content": "Say hello in five words."}],
  "max_tokens": 40,
  "temperature": 0.2,
  "stream": false
}
返回里带标准的 usage 字段,那次是 prompt_tokens: 14、completion_tokens: 7、total_tokens: 21。任何认这个协议的客户端(包括各种聊天前端、编辑器插件、SDK)改一下 base_url 就能接过来。
这是单文件程序里最实用的一个设计:不用改应用代码,只换一个地址,就把请求从云端挪到了本地。
上限不等于实际生成量
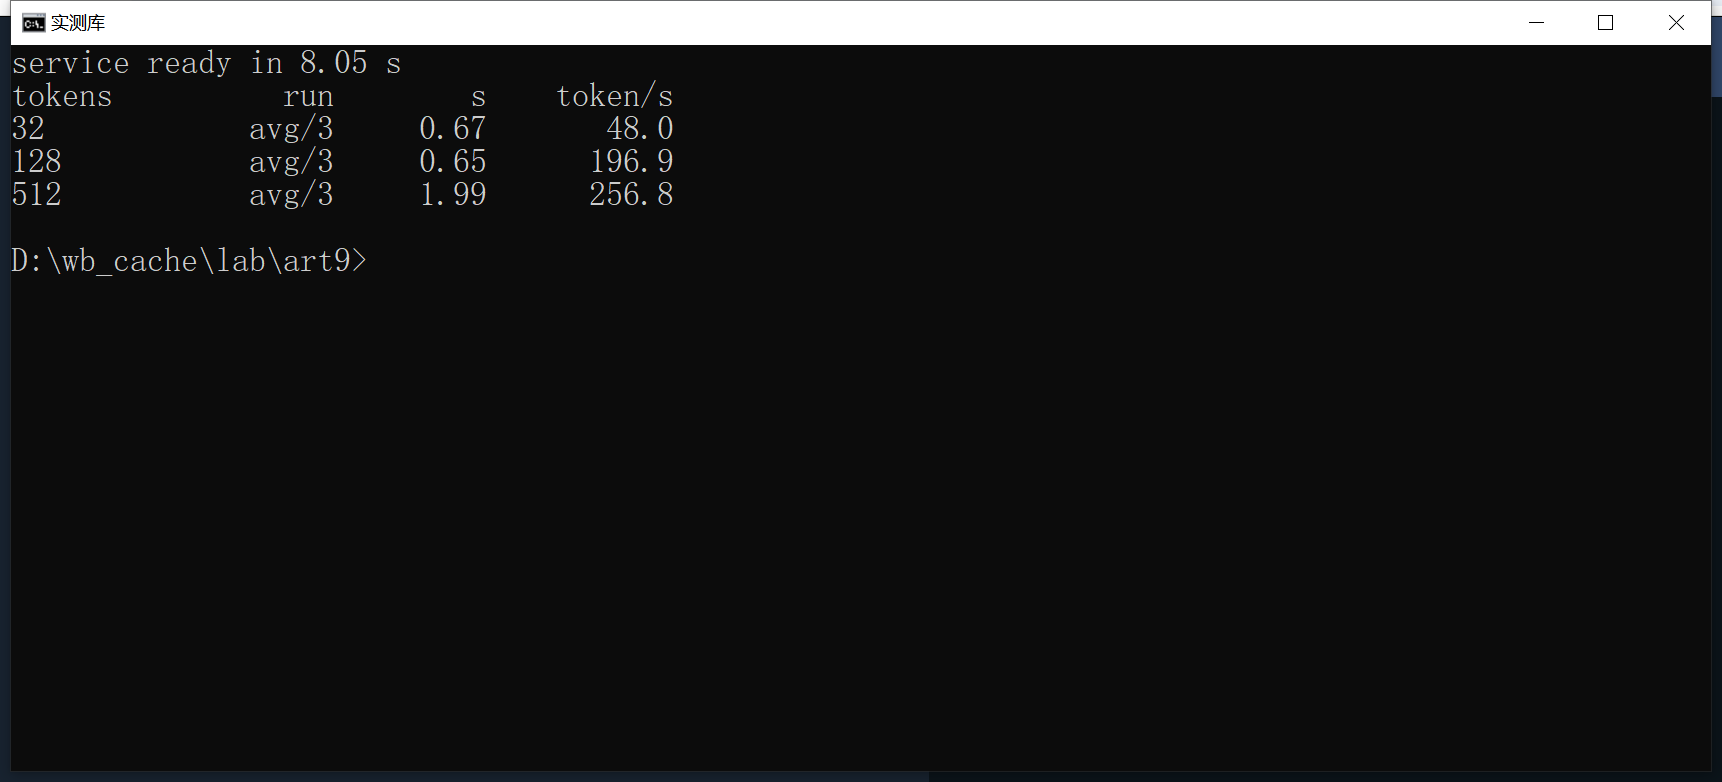
用同一个提示词、只改生成上限,测出来的耗时是:上限 32 用 0.67 秒、128 用 0.65 秒、512 用 1.99 秒。128 比 32 还快,因为模型在前两种情况下都只写了一小段就自然停了,上限根本没被用满。
这件事影响所有「按 token 数估耗时」的估算。真正决定耗时的不是 --contextsize 或 max_length,而是模型自己决定在哪停。做容量规划时要按最坏情况算,也就是把上限用满的那一档:512 token 约 2 秒。
启动之后要先确认的事
第一件是端口。默认 5001,被占用时会失败,但报错藏在日志末尾,只看控制台前几行容易以为是模型加载失败。
第二件是上下文长度。--contextsize 2048 意味着超过这个长度的对话会被截断,而且不报错。做长文档处理时要提前调大,代价是内存占用跟着涨。
第三件是模型没加载完就发请求。接口还没起来时连接会被拒绝,脚本里要轮询 /api/v1/model 直到返回 200,别用固定 sleep。