whisper.cpp 把 OpenAI 的语音识别模型用 C++ 重写了一遍,跑在 CPU 上,不依赖 Python、不需要显卡。程序本身 8.9 MB,模型文件另算。
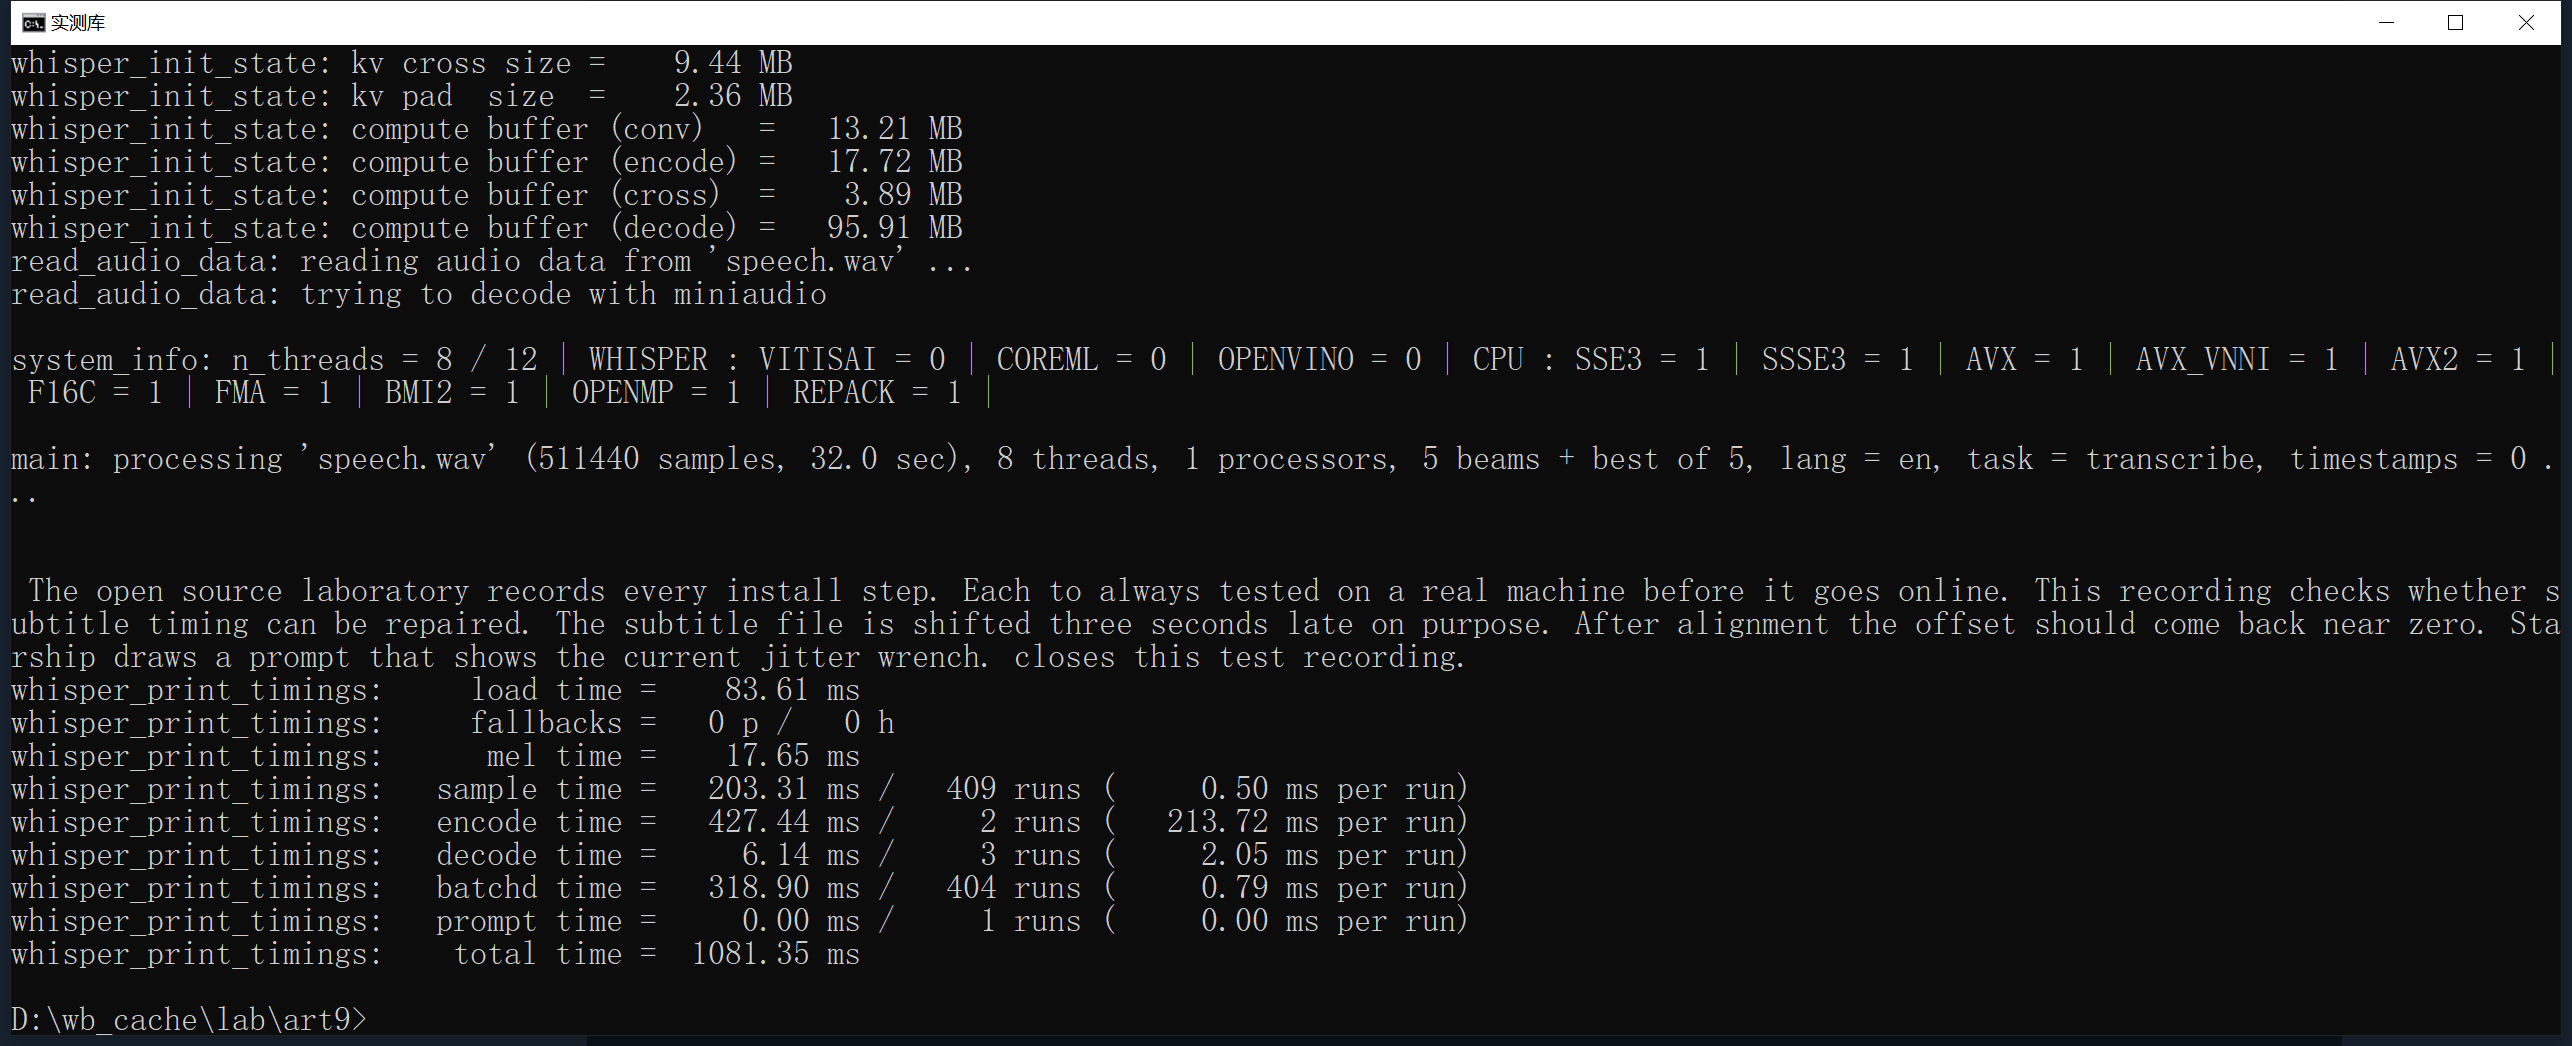
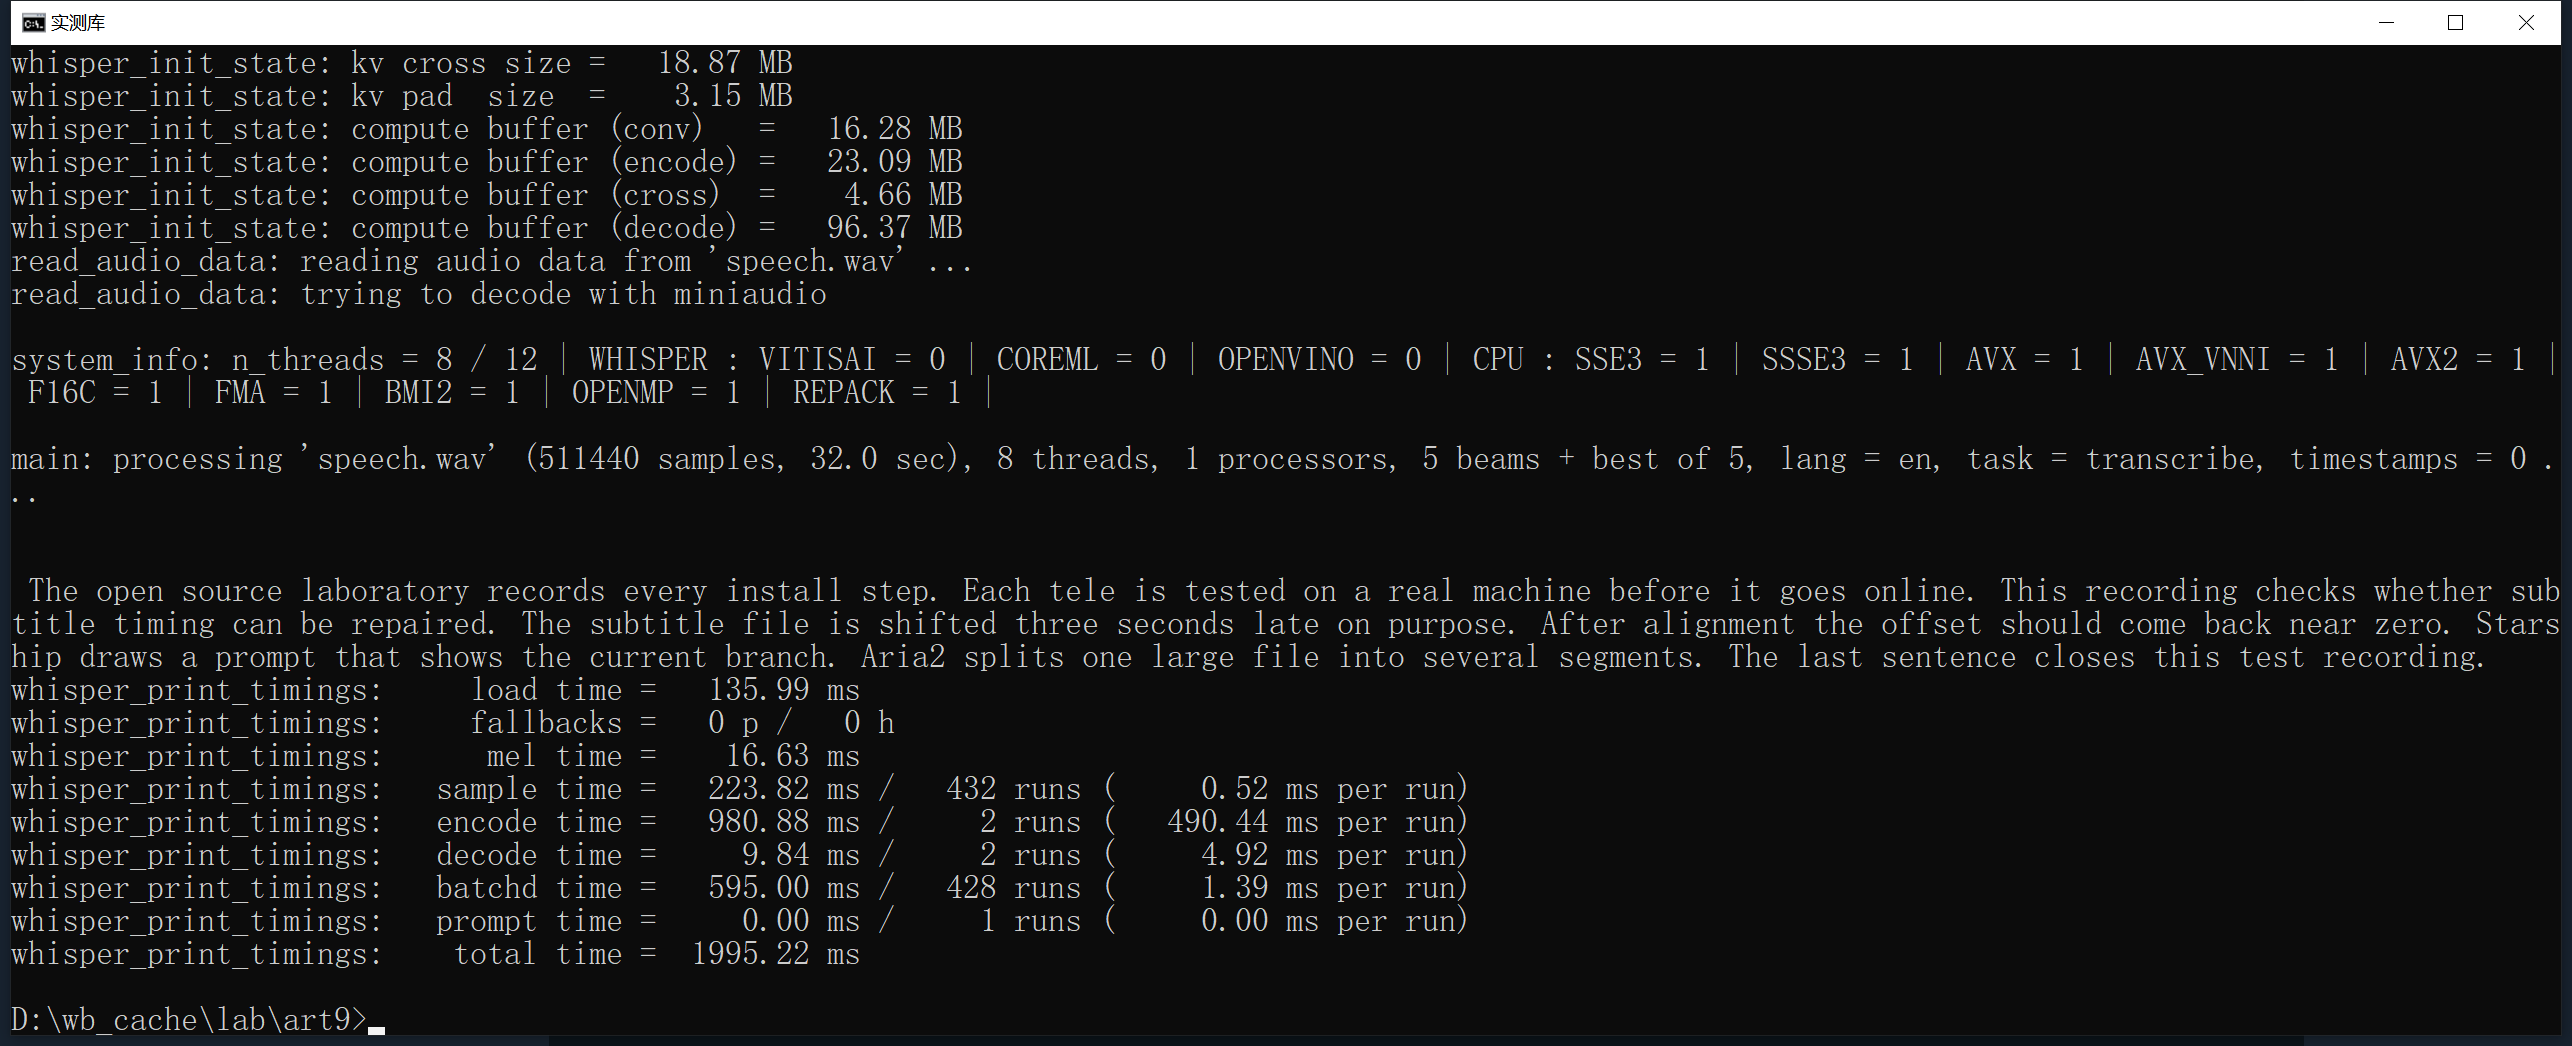
拿一段 32 秒的英文录音做实测:tiny 模型 8 线程 1081 毫秒转完,实时率 0.034;换成 base 模型要 1995 毫秒,但词错率从 38.4% 降到 23.3%。速度和准确率之间的取舍,比想象中更陡。
8.9 MB 的程序,加一个模型文件
whisper-cli.exe -m ggml-tiny.bin -f speech.wav -l en -nt
system_info: n_threads = 4 / 12 | AVX = 1 | AVX2 = 1 | F16C = 1 | FMA = 1 | OPENMP = 1
main: processing 'speech.wav' (511440 samples, 32.0 sec), 4 threads, lang = en
压缩包 8928640 字节,解开是一堆 exe:whisper-cli.exe 是主力,还有 stream.exe(边录边转)和 bench.exe(跑基准)。模型单独下,tiny 是 77691713 字节,base 是 147951465 字节。
注意 main.exe 已经废弃了,跑起来只打印一句 deprecated 就退出。现在要用 whisper-cli.exe,网上不少教程还写的是 main。
32 秒音频,1.31 秒转完
| 模型 | 线程 | 内部计时 | 实时率 | 词错率 |
|---|---|---|---|---|
| tiny | 8 | 1081 毫秒 | 0.034 | 38.4% |
| base | 8 | 1995 毫秒 | 0.062 | 23.3% |
| tiny | 4 | 1470 毫秒 | 0.046 | 38.4% |
| base | 4 | 2840 毫秒 | 0.089 | 23.3% |
| tiny 模型文件 | — | 77691713 字节 | — | — |
| base 模型文件 | — | 147951465 字节 | — | — |
实时率 0.034 的意思是:32 秒的音频用 1.08 秒处理完,速度是播放速度的 29.6 倍。一小时录音按这个比例大约 2 分钟转完,这是纯 CPU 的成绩。
8 线程比 4 线程快 26%(tiny,1470 到 1081 毫秒)和 30%(base,2840 到 1995 毫秒)。语音识别在这一段吃得动多线程,不像大模型生成阶段那样卡在内存带宽上。
tiny 和 base 差 15 个百分点
词错率是按标准 WER 算的:把转写结果和原文都切成单词,算编辑距离再除以原文词数。同一个音频、同样的参数,两个模型的表现:
| 指标 | tiny | base | 差距 |
|---|---|---|---|
| 词错率 | 38.4% | 23.3% | 低 15.1 个百分点 |
| 内部计时(8 线程) | 1081 毫秒 | 1995 毫秒 | 慢 1.85 倍 |
| 模型体积 | 77691713 字节 | 147951465 字节 | 大 1.90 倍 |
| 实时率 | 0.034 | 0.062 | — |
体积翻一倍、速度慢一半,换来错词率降 15 个点。这个交换在语音转文字上通常是值得的:38.4% 的错词率意味着每三个词就有一个不准,整理起来比重录一遍还费时间。
错在什么地方
两个模型在原句「Starship draws a prompt that shows the git branch」上都栽了:
原文  Starship draws a prompt that shows the git branch
tiny  Starship draws a prompt that shows the current jitter wrench
base  Starship draws a prompt that shows the current branch
两个模型都把「git branch」念歪了:tiny 听成 jitter wrench,base 听成 current branch,共同点是都丢了 git。这类专有名词是语音识别最难的部分,训练数据里这个搭配出现得少,模型只能按音近去猜。
更大的差别在别处。tiny 把「Aria two splits a large file into several segments」整句丢了,还把「Each tool is tested」听成「Each to always tested」;base 这两个地方分别是「Aria2 splits one large file」和「Each tele is tested」,只错了一个词。丢句子比错词麻烦得多,不看原文根本发现不了少了一段。
这两处错误的共同点是:测试音频是 TTS 合成的,语调比真人平,模型更容易在连读的地方出错。真人录音的错词率会低一些,但专有名词的问题一样存在。
实时率与线程数的关系
内部计时拆开看,base 8 线程那次的分项是这样的:
load time   =   135.99 ms
mel time    =    16.63 ms
sample time =   223.82 ms / 432 runs
encode time =   980.88 ms /   2 runs  (490.44 ms per run)
decode time =     9.84 ms /   2 runs
batchd time =   595.00 ms / 428 runs
total time  =  1995.22 ms
编码(encode)只跑了 2 次,占了 981 毫秒,是最大头:它把音频切成 30 秒窗口做特征提取。批处理(batchd)跑了 428 次,每次 1.39 毫秒。解码只花 9.84 毫秒,几乎可以忽略。
这个分布说明一件事:想再快,靠加工线程作用有限,编码那 981 毫秒是固定成本。换更小的模型、或者只转需要的那一段,比加线程更有效。
两个必须给的参数
-l 指定语言,-m 指定模型。不指定语言时会走自动检测,多花一次前向计算,而且在短音频上容易判断错。
-nt 关掉时间戳输出。要生成字幕就别加这个参数,默认会带上每段的时间区间,直接能拼成 SRT。
还有一个容易忽略的:路径里有中文时,Windows 版要先把代码页切到 65001,否则读不到文件。这不是程序的问题,是命令行参数编码的事。