ffsubsync 解决一个很具体的问题:字幕和视频差了几秒。它不是靠人工拖动时间轴,而是从音频里提取语音活动,再跟字幕的时间轴做互相关,算出一个整体偏移量后平移整份字幕。
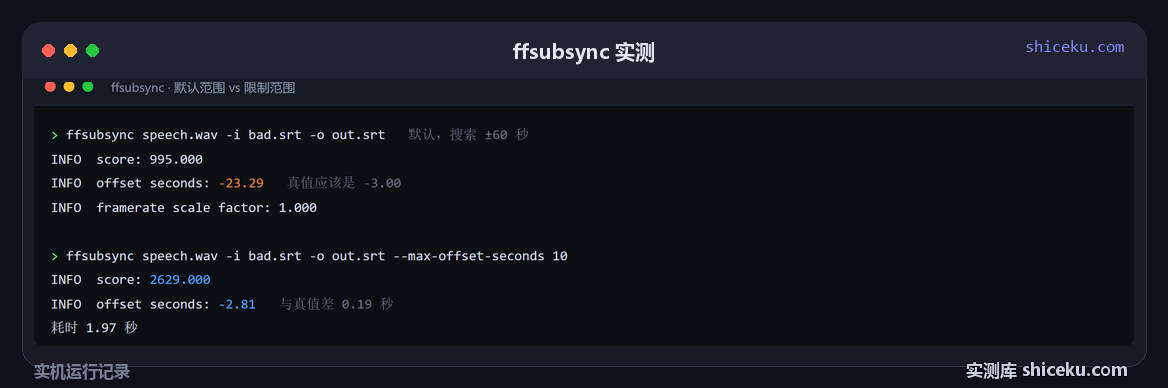
32 秒的音频跑一次不到 2 秒。但它有一个默认参数会在短音频上直接跑偏:同一份错位 3 秒的字幕,默认参数算出 -23.29 秒,把偏移范围限制到 10 秒以内才算对。
装完之后是一条命令
ffsubsync --version
ffsubsync 0.5.1

ffsubsync speech.wav -i bad.srt -o synced.srt --max-offset-seconds 10第一个参数是音频或视频,-i 是待对齐的字幕,-o 是输出。它内部用 ffmpeg 抽音轨、用 webrtcvad 判断哪一段有人说话,再拿这个语音时间轴跟字幕时间轴对相关。
装上会带 numpy、scipy、webrtcvad 几个依赖,pip 一次装完。运行时不需要 GPU,也不需要联网。
造一份能复现的测试
手边没有现成的错位字幕,就自己造一份。用 ffmpeg 自带的 flite 合成 8 句英文语音,句子之间插 0.6 秒静音,拼成一段 31.96 秒的音频;再按真实的语音起止时间写一份正确字幕,然后把整份字幕整体后移 3 秒当成待修复的样本:
ffmpeg -f lavfi -i "flite=text='...':voice=slt" -ar 16000 -ac 1 l01.wav
ffmpeg -f concat -safe 0 -i list.txt -c copy speech.wav

合成音频 31.96 秒,1022958 字节
正确字幕最后一句结束于 31.96 秒,错位版整体 +3 秒
这样「正确答案」是已知的:理想情况下应该算出 -3.00 秒,把错位版平移回去。有了参照,后面的数字才有意义。
默认参数在这段音频上跑偏了
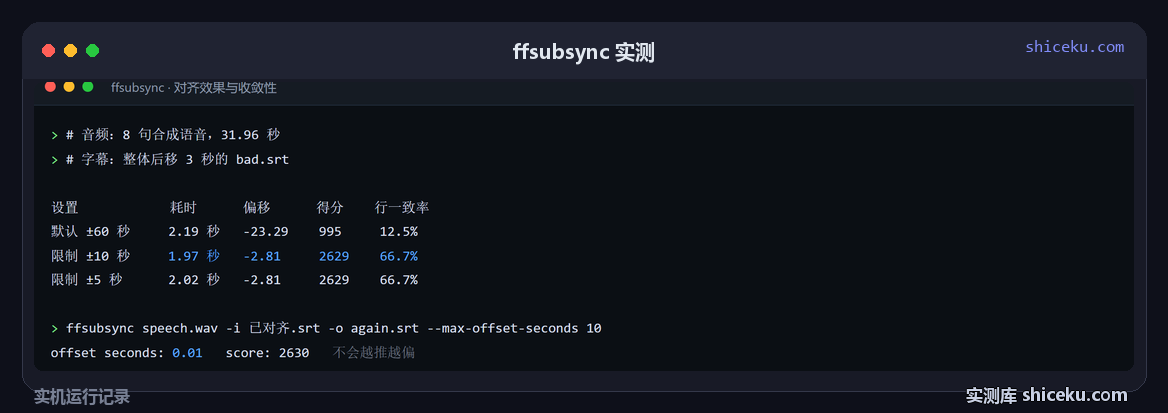
| 设置 | 耗时(秒) | 算出的偏移(秒) | 相关得分 | 与正确版行一致率(%) |
|---|---|---|---|---|
| 默认(搜索 ±60 秒) | 2.19 | -23.29 | 995 | 12.5 |
| 限制 ±10 秒 | 1.97 | -2.81 | 2629 | 66.7 |
| 限制 ±5 秒 | 2.02 | -2.81 | 2629 | 66.7 |
默认参数把偏移算成 -23.29 秒,相关得分只有 995,对齐后跟正确字幕只有 12.5% 的行能对上。原因在于搜索范围:默认允许在正负 60 秒内找最佳匹配,而这段音频只有 31.96 秒,范围比音频本身还长,等于在一个几乎没有重叠的空间里滑,很容易滑到一个「碰巧得分也不低」的位置。
把范围收到 ±10 秒,偏移算成 -2.81 秒,与真值 -3.00 秒差 0.19 秒,相关得分跳到 2629,行一致率 66.7%。收到 ±5 秒结果完全一样,说明真值落在范围内之后,范围再收窄不影响结果。
0.19 秒的误差来自语音活动检测的边缘:它判断「有人说话」的起点比真实发音稍晚,整体平移量就偏了一点。对字幕来说 190 毫秒可以接受,观众几乎察觉不到。
已经对齐的字幕再跑一次
> ffsubsync speech.wav -i v_限制10秒.srt -o again.srt --max-offset-seconds 10
offset seconds: 0.01
score: 2630
耗时 1.99 秒
拿已经对齐的版本再跑一次,算出的偏移是 0.01 秒,得分 2630,比上一次的 2629 还高一点。说明这个算法在正确位置上是稳定的,来回跑不会把字幕越推越偏。
这个性质很重要:如果工具每次都随机偏个几百毫秒,反复对齐就会让字幕慢慢漂走。0.01 秒说明它是收敛的。
失败时会发生什么
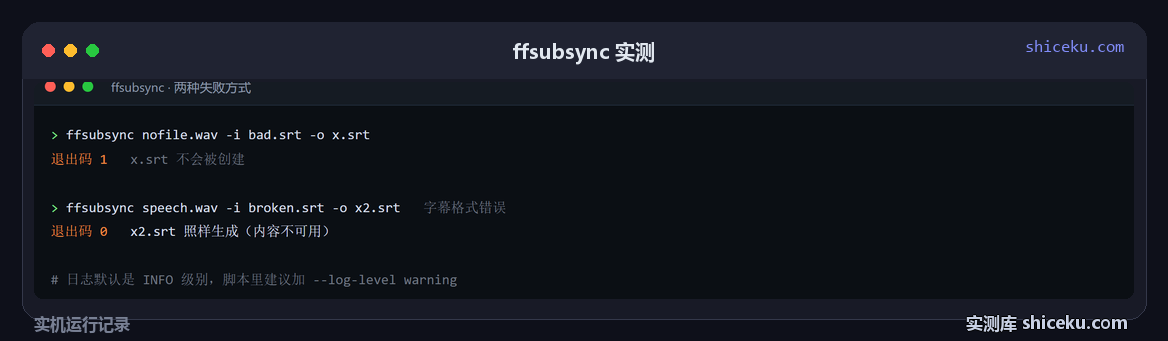
> ffsubsync nofile.wav -i bad.srt -o x.srt
退出码 1,x.srt 没有被创建

> ffsubsync speech.wav -i broken.srt -o x2.srt
退出码 0,x2.srt 照样生成(内容不可用)
音频文件不存在时会失败退出,输出文件不生成,脚本里可以用退出码判断。
字幕文件格式不对时反而更麻烦:它不报错,退出码 0,照样写一个输出文件出来。因为解析不出有效的字幕条目,最后等于把空内容写了一遍。这种情况只能自己检查产物——比较输入输出条目数,或者看看输出文件是不是 0 条。
另外它的日志很啰嗦,默认会把每一步的 INFO 都打出来。脚本里调用建议加 --log-level warning,不然一大段无用的输出会混进你的管道。
什么时候值得用
整份字幕早或晚了几秒。这是它最擅长的场景:一个整体偏移量,一次平移解决,不足 2 秒跑完。
字幕来自不同版本。同一部片子的蓝光版和流媒体版时长不同,字幕要重新对,用它算偏移比手动拖准。
要处理分段错位。它算的是一个全局偏移,前半段对后半段错的字幕处理不了。这种要按段落切开分别对齐,或者人工修。
音频里几乎没人说话。音乐、环境音、纯解说的长静音,语音活动检测抽不出有效时间轴,相关就会失效。这种情况它不会告诉你「我算不准」,只会给一个偏移量。
还没测的两项:真实影视音频上的准确率 / 与 subsync 这类图形工具的对比。前者需要带已知偏移的电影片段,后者要装桌面程序逐帧比对。