monolith 是 Rust 写的单文件 exe,作用只有一个:把网页连样式、图片、脚本、字体一起塞进一个 HTML 文件。存下来的页面断网也能打开,图片不会变成红叉,样式不会丢。它不依赖浏览器,命令行直接抓。
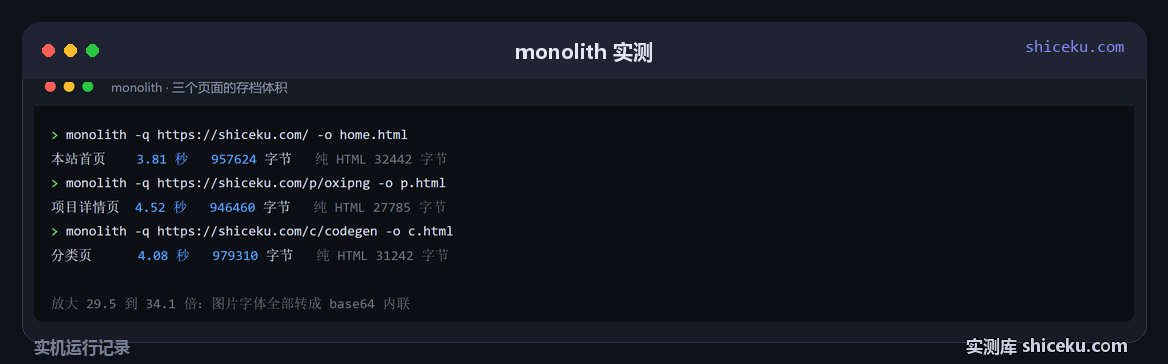
代价是文件会变大。站内三个页面存下来都在 950 KB 上下,而纯 HTML 只有 3 万字节出头,放大了 29.5 到 34.1 倍。
一条命令存一个页面
monolith --version
monolith 2.11.6

monolith -q https://shiceku.com/ -o home.html
-q 是安静模式,不打进度。-o 指定输出文件。不指定就打到标准输出,可以管道给别的程序。整个 exe 5.2 MB(5486592 字节),不带 Chromium 也不带 Node,抓页面用的是自带的 HTTP 客户端加 HTML 解析。
它的做法是把每个外部资源抓下来,转成 data URI 内联进 HTML:图片转 base64、样式表直接塞进 style 标签、字体也一样。所以产物是一个自包含的 HTML,双击就开,不需要网络也不需要原站。
三个页面的实际体积
同一台机器、同一个站内页面各存一次,同时记下纯 HTML 的字节数做对照:
| 页面 | 耗时(秒) | 单文件(字节) | 纯 HTML(字节) | 放大倍数 |
|---|---|---|---|---|
| 本站首页 | 3.81 | 957624 | 32442 | 29.5 |
| 项目详情页 | 4.52 | 946460 | 27785 | 34.1 |
| 分类页 | 4.08 | 979310 | 31242 | 31.3 |
3 到 4.5 秒一个页面,时间主要花在依次下载图片和字体上,解析本身很快。放大 30 倍左右是 base64 的固有代价:二进制转成文本本身就会膨胀,再加上一个页面几十个资源。
950 KB 里七成半是图片
把首页那个 957624 字节的文件拆开,数里面所有 base64 内联块:
| 内联内容 | 字符数 | 占全文(%) |
|---|---|---|
| image/webp | 680880 | 71.1 |
| image/png | 29168 | 3.0 |
| image/x-icon | 9088 | 0.9 |
| image/svg+xml | 804 | 0.1 |
| base64 合计 | 719940 | 75.2 |
| 内联资源个数(个) | 26 | — |
| script 标签(个) | 2 | — |
| link 标签(个) | 11 | — |
一共 26 个内联资源,图片占了 719940 个字符中的绝大部分,其中 webp 一项就 680880 个字符。剩下的四分之一是 HTML 本身、2 个 script 和 11 个 link 带进来的样式。
这决定了减体积的方向:想让存档小,先处理图片(-i 直接不内联),字体其次(-F)。从 CSS 上抠是没有意义的。
值不值看用途。一份 950 KB 的 HTML 断网能看、能发邮件、能丢进 Git 仓库长期存档,比几十个零散文件和一堆相对路径省心得多。
去掉 JS 反而更大
它有个 -j 参数,含义是丢弃脚本。按直觉文件应该变小,实测结果相反:
| 设置 | 体积(字节) | 差值(字节) | 相对默认(%) |
|---|---|---|---|
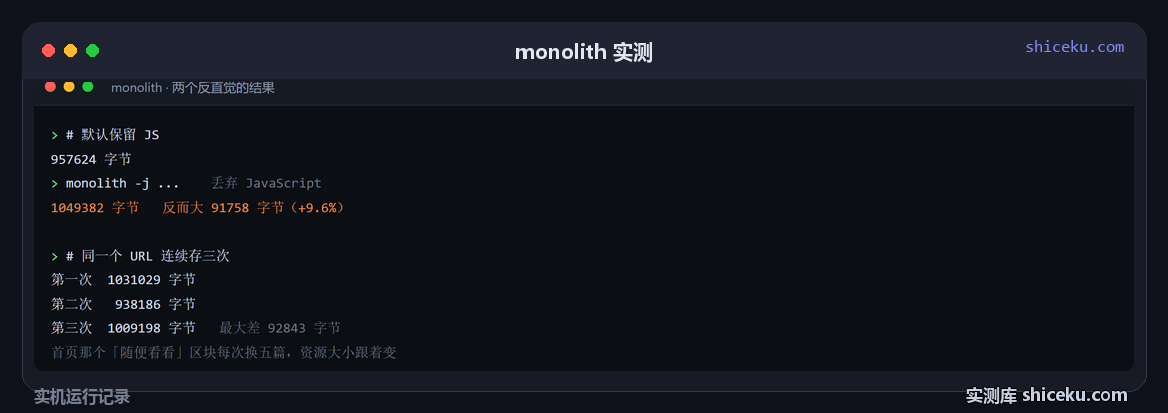
| 默认(保留 JS) | 957624 | 0 | 0 |
| 加 -j(丢弃 JS) | 1049382 | 91758 | +9.6 |
加了 -j 之后反而大了 91758 字节。原因是这个站点的脚本里带着一份打包好的前端资源,丢弃脚本会连带丢掉脚本内联的部分资源,页面改用别的回退路径,反而把更多内容以原始形式内联了进来。这个行为不是 bug,但对「只想减小体积」的人来说是反直觉的。
要压缩体积,更有效的做法是不存档首页这种带动态内容的页面,或者直接用 -F/--no-fonts 把字体排除掉,字体通常占大头。
每次存出来的文件都不一样
第一次  1031029 字节
第二次   938186 字节
第三次 1009198 字节| 次序 | 体积(字节) |
|---|---|
| 第一次 | 1031029 |
| 第二次 | 938186 |
| 第三次 | 1009198 |
| 最大差值 | 92843 |
| exe 自身体积 | 5486592 |
同一个 URL 连续存三次,体积在 938186 到 1031029 之间浮动,最大差 92843 字节。原因是页面里有随机内容:首页那个「随便看看」区块每次请求换五篇不同的项目,带出来的封面图大小也不一样。
这意味着存档结果不能拿字节数做校验。要判断两次抓取是否一致,得比对页面里的静态部分,或者干脆接受它本来就不是确定性输出。
打不开的页面直接报错
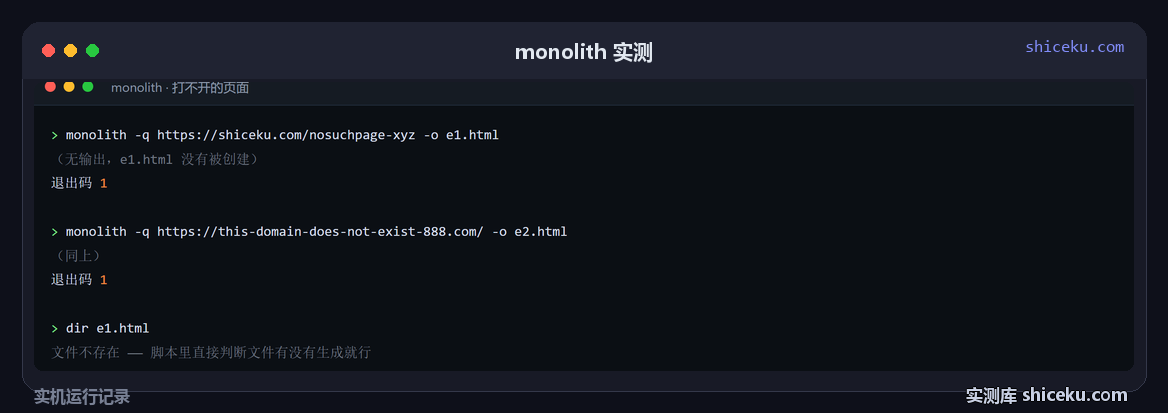
> monolith -q https://shiceku.com/nosuchpage-xyz -o e1.html
(无输出,e1.html 没有被创建)
退出码 1

> monolith -q https://this-domain-does-not-exist-888.com/ -o e2.html
(同上,退出码 1)
404 和域名解析失败都是退出码 1,输出文件不会生成,也不留一个空文件。这点比某些工具好——脚本里可以用「文件是否存在」判断成功与否,不用额外解析输出。
它的报错比较安静:加 -q 之后连错误原因都不打。排查的时候要去掉 -q,才能看到是 DNS 失败还是服务端返回了错误码。
什么时候适合用它
要长期存档网页。一个 950 KB 的文件丢进归档目录,几年后双击还能看到当年的样子,不依赖原站是否还活着。
要发给别人看。一个 HTML 附件比「先装这个插件再打开」省事,对方不需要任何工具,浏览器双击就行。
要保留排版证据。截图只能证明外观,单文件 HTML 还能选中文字、能搜索、能打印,做记录比截图完整。
只想抓文字内容。它会把所有图片字体都带上,950 KB 里有九成是资源。只要正文的话,用 readability 类工具抽文本更合适。
要存需要登录的页面。它自己发请求,不带浏览器会话,处理不了登录态和 JavaScript 渲染出来的内容。这类页面得用带浏览器的方案。
还没测的两项:带 Cookie 的登录页抓取 / 与 SingleFile 在同一页面上的体积对比。前者要造一套登录态,后者那个工具在 Windows 上启动失败,没跑出数据。