用拼音做检索或排序时,把名字转成拼音是第一步。pypinyin 装完只花 14 秒,常用词几乎都对,但我拿五个真实姓名一试,五个全读错:单田芳成了 dan tian fang,仇英成了 chou ying。这不是 bug,是它没有姓氏读音词典,遇到多音字一律按最常见的音猜。
它是纯 Python 实现的汉字转拼音库,能输出十几种样式,从带声调的完整拼音一直到只要声母。常用来做排序键或检索索引。
下面这些结果都是在本机实际跑出来的,代码和输出都贴了。
不想写代码的话,我打了个 exe
上面都是 Python 代码。要是不想装环境,我把查询功能打成了单文件 exe,11.1 MB,双击就能用。
在里面输入汉字,一次给出四种结果:带声调、纯字母、首字母、声母。
还单独做了个姓氏提醒:输入「单田芳」,它照样会给出 dan tian fang,但下面会补一句「开头是姓氏「单」,人名里常读 shàn」。把这篇里踩的坑直接做进了工具里。
按 d 可以查看内置的十个多音字姓氏表。整个程序本地运行,不联网也不上传任何东西。
装它有多快
python -m venv venv
venv\Scripts\pip.exe install pypinyin
从建虚拟环境到装完 14 秒,装出 pypinyin 0.55.0。纯 Python,没有 C 扩展,不需要编译器,MIT 协议。
三种最常用的输出
拿一句有四个「重」的话来试:
pinyin('重庆的重是重量的重吗', style=Style.TONE)
lazy_pinyin('重庆的重是重量的重吗')
lazy_pinyin('重庆的重是重量的重吗', style=Style.FIRST_LETTER)
带声调出来是 [['chóng'],['qìng'],['de'],['zhòng'],['shì'],['zhòng'],['liàng'],['de'],['zhòng'],['ma']]。
不带声调是 chong qing de zhong shi zhong liang de zhong ma,首字母是 c q d z s z l d z m。
注意这一句里的四个「重」全部判对了:重庆读 chóng,重量读 zhòng。有上下文时它是准的。
没有上下文就靠猜
单独查一个字,它只能给最常见读音:
| 字 | 默认输出 | 反例 |
|---|---|---|
| 长 | zhǎng | 长江该读 cháng |
| 乐 | lè | 音乐该读 yuè |
| 得 | dé | 跑得快该读 de |
| 差 | chà | 出差该读 chāi |
| 重 | zhòng | 重庆该读 chóng |
所以单字查出来的拼音不能直接当结论,一定要连词一起转。
姓氏几乎全错
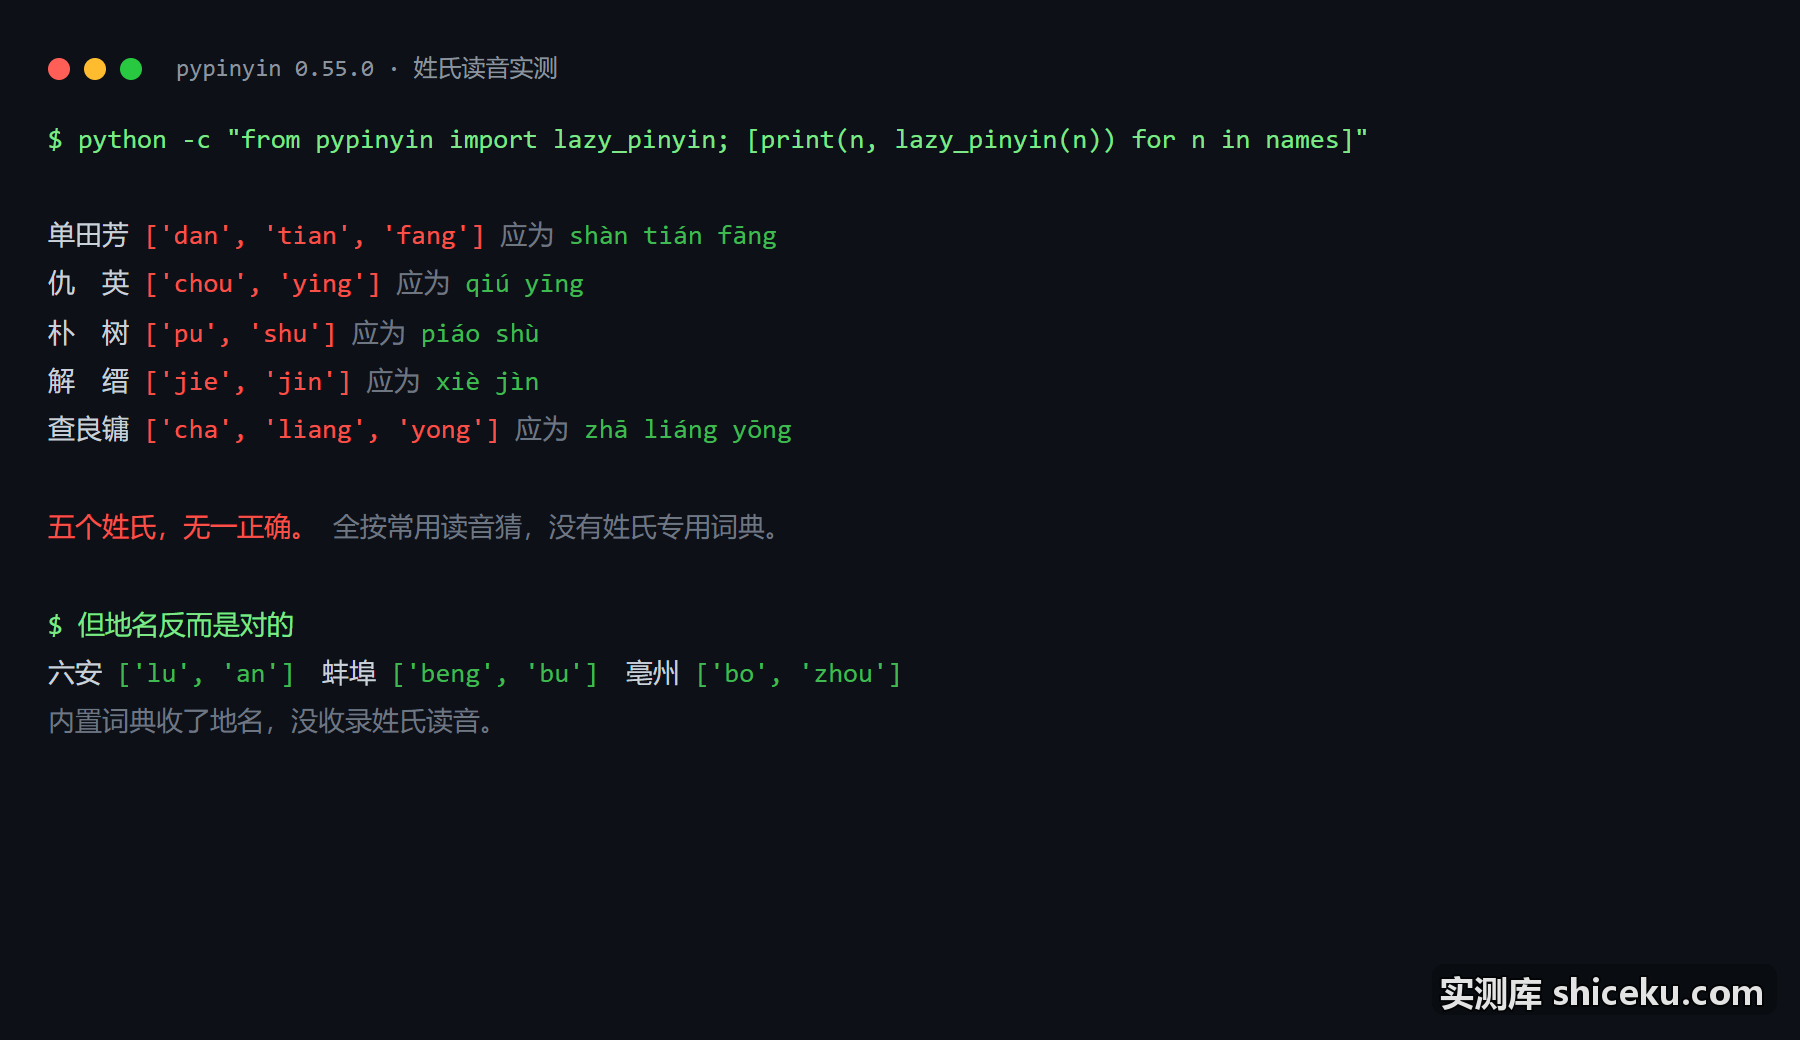
这是最值得记的一条。我拿了五个真实姓名:
| 姓名 | pypinyin 给出 | 实际读音 |
|---|---|---|
| 单田芳 | dan tian fang | shàn tián fāng |
| 仇英 | chou ying | qiú yīng |
| 朴树 | pu shu | piáo shù |
| 解缙 | jie jin | xiè jìn |
| 查良镛 | cha liang yong | zhā liáng yōng |
五个全错。做通讯录或者作者索引这类功能时,拼音错一个就会导致搜不到人,用户会以为系统坏了。
有意思的是地名反而都对:六安读 lu an,蚌埠读 beng bu,亳州读 bo zhou,丽水读 li shui。可见内置词典收了地名,唯独没收姓氏读音。
怎么修:加自己的词组词典
官方给了 load_phrases_dict,可以把正确的读音塞进去:
from pypinyin import load_phrases_dict
load_phrases_dict({
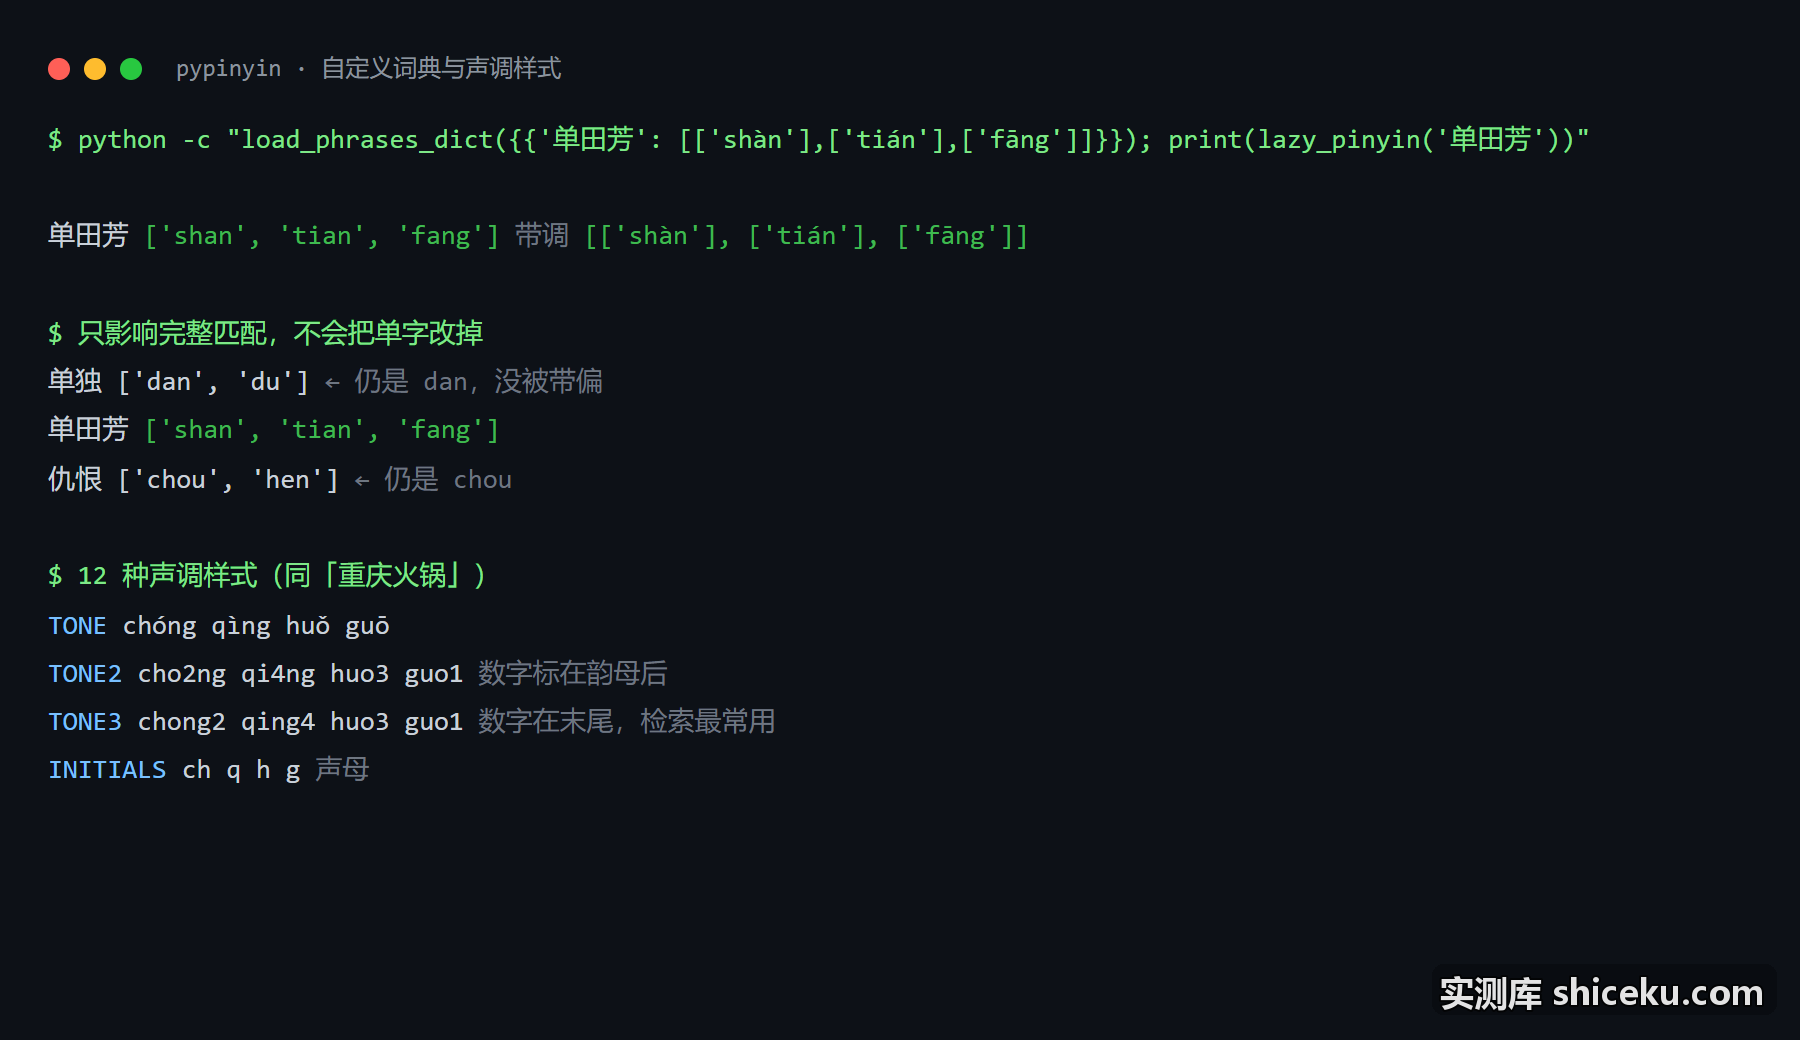
    "单田芳": [["shàn"], ["tián"], ["fāng"]],
    "仇英":   [["qiú"], ["yīng"]],
    "朴树":   [["piáo"], ["shù"]],
})
加完之后三个名字全对了,带调输出分别是 shàn tián fāng,qiú yīng,piáo shù。
关键是不会误伤别的词:同一个进程里「单独」还是 dan du,「仇恨」还是 chou hen。它只匹配完整词组,不会把单字读音整体改掉。
做法上建议建一个自己的姓氏表,启动时加载一次,覆盖百家姓里那些多音字姓氏,比如单和仇这两个最常踩坑的。
十几种声调样式怎么选
同一个「重庆火锅」,不同 style 参数出来的结果不一样:
| Style | 输出 | 适用 |
|---|---|---|
TONE | chóng qìng huǒ guō | 给人看,注音显示 |
TONE2 | cho2ng qi4ng huo3 guo1 | 数字标在韵母后,少见 |
TONE3 | chong2 qing4 huo3 guo1 | 做检索键最省事 |
INITIALS | ch q h g | 只要声母 |
要存数据库当排序键的话,用不带声调的 lazy_pinyin 更省空间,反正排序不需要声调。
速度和资源
1.2 万字的重复文本,跑一次的结果:
lazy_pinyin:0.101 秒pinyin:0.049 秒,因为返回嵌套列表、不做额外样式处理,反而更快
都是纯 Python,没有并发问题,几万条数据建索引完全够用。
中英混排会原样保留
输入「我用 Python 3.13 处理了 12000 条数据」,输出里英文和数字是原样保留的:['wo','yong',' Python 3.13 ','chu','li','le',' 12000 ',...]。
这对建索引是好事,但如果你只想要纯拼音,得自己过滤掉非中文项,别直接 join。
常见问题
能自动识别姓氏吗
不能。实测五个常见姓氏全读错,必须自己用 load_phrases_dict 补词典。
为什么「重庆」对、「重」错
它内置了词组表,碰到「重庆」这种完整词组会查表;单独一个「重」没有上下文,只能给最常见读音 zhòng。
要装 jieba 才能准确吗
这次没验证。jieba 依赖包 19MB,本地下载一直超时没装上。从默认表现看,常用两字词已经能处理对,姓氏问题得靠自定义词典而不是分词。
繁体字和生僻字支持吗
这次没测。文档里提到支持,但我只跑了简体常用字。
适合谁
几种典型场景:
- 做中文检索时生成拼音索引,让「zhongqing」也能搜到「重庆」
- 通讯录按拼音首字母分组
- 给生僻字加注音
它的强项是有上下文的词组,弱项是单字和姓氏。如果你的数据里人名占比高,做好被读音坑一次的准备,提前把姓氏表建起来。