jieba 是中文分词库,纯 Python,装完 import 就能用。中文没有空格,做搜索、关键词统计、文本分类之前都得先切词,它做的就是这件事:把一句话切成「开源 / 软件 / 实测 / 平台」这样的词串,带三种粒度、自定义词典和关键词提取。
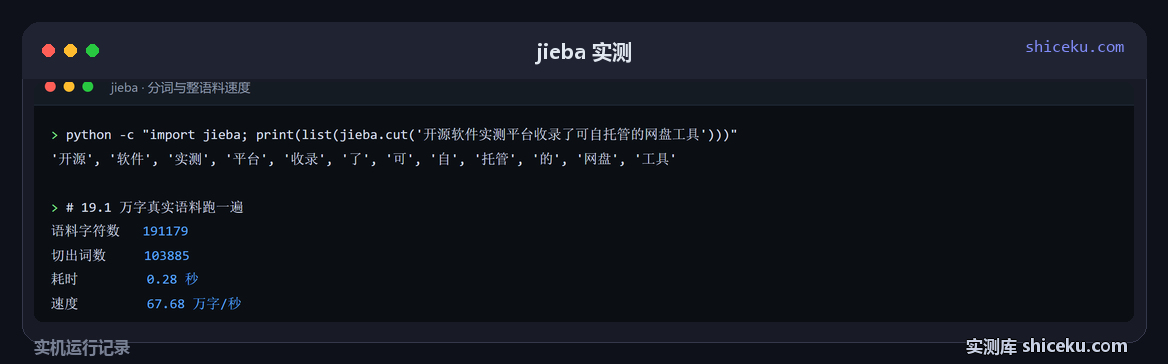
速度是它最不用担心的部分。19.1 万字的真实语料跑一遍 0.28 秒,折合 67.68 万字/秒。
装完就能切
pip install jieba

import jieba
list(jieba.cut("开源软件实测平台收录了可自托管的网盘工具"))
# ['开源', '软件', '实测', '平台', '收录', '了', '可', '自', '托管',
#  '的', '网盘', '工具']
纯 Python 包,没有编译依赖也没有模型文件,装完占 41.0 MB,其中内置词典 dict.txt 一个文件就 4.8 MB。import 本身 0.45 秒,但要到第一次调用 cut() 才真正加载词典,那一步 0.38 秒。
这 0.38 秒值得记住:如果服务是冷启动的,第一个请求会明显比后面的慢。预热一次就行,比如启动时先 jieba.cut("预热") 一下。
19 万字跑一遍
语料是站内 76 篇文章的正文,去掉 HTML 标签后 191179 个字符,混着技术名词、数字、英文和标点,比干净的新闻语料更难切:
| 指标 | 数值 |
|---|---|
| 语料字符数 | 191179 |
| 切出词数 | 103885 |
| 耗时(秒) | 0.28 |
| 速度(万字/秒) | 67.68 |
0.28 秒处理将近 20 万字,搜索建索引、日志分析这类场景完全够用。
三种模式切出来不一样
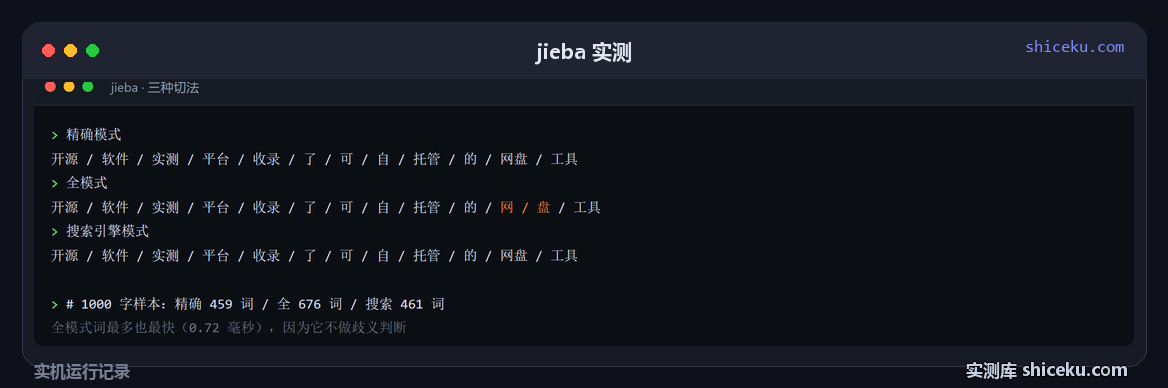
同一段 1000 字样本,三种模式的差别:
| 模式 | 词数 | 耗时(毫秒) | 特点 |
|---|---|---|---|
| 精确模式 | 459 | 1.31 | 每段只切一种最合理的结果 |
| 全模式 | 676 | 0.72 | 所有可能的词都出来,有重复 |
| 搜索引擎模式 | 461 | 1.59 | 长词再切一遍短词,给召回用 |
全模式词最多但最快,因为它不做歧义判断。精确模式和搜索引擎模式词数接近,因为这段样本里长词不多,拆开之后增量很小。
同一句话三种切法摆在一起就能看出区别:
精确:开源 / 软件 / 实测 / 平台 / 收录 / 了 / 可 / 自 / 托管 / 的 / 网盘 / 工具
全 :开源 / 软件 / 实测 / 平台 / 收录 / 了 / 可 / 自 / 托管 / 的 / 网 / 盘 / 工具
搜索:开源 / 软件 / 实测 / 平台 / 收录 / 了 / 可 / 自 / 托管 / 的 / 网盘 / 工具
「网盘」在全模式里被拆成「网」和「盘」两个单字,因为全模式会把构成双字词的单字也输出。做搜索索引要用搜索引擎模式,做词频统计用精确模式。
自定义词典补专业词
内置词典认不出「可自托管」「网盘工具」这类组合,会把它们拆开。加一份词典就能改:
# userdict.txt
可自托管 100 n
网盘工具 100 n

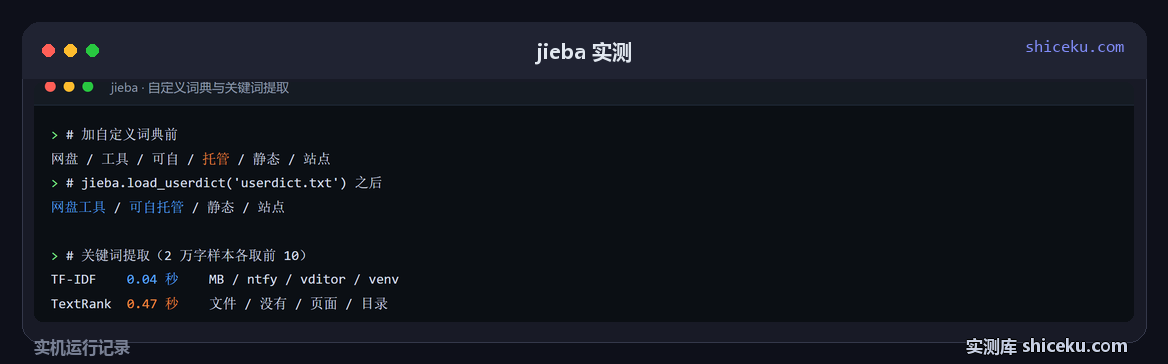
加词典前:网盘 / 工具 / 可自 / 托管 / 静态 / 站点
加词典后:网盘工具 / 可自托管 / 静态 / 站点
jieba.load_userdict("userdict.txt") 是全局生效,之后所有 cut 都按新词典切。文件每行「词 词频 词性」,词频和词性可以省略。词频给 100 意味着这个词出现频率约每百万次 100 次,给太小会被更高的内置词压过去,等于没加。
关键词提取:两种算法差 11 倍
同样取 2 万字样本、各取前 10 个词:
| 方法 | 耗时(秒) | 相对 TF-IDF(倍) | 结果特点 |
|---|---|---|---|
| TF-IDF | 0.04 | 1 | 偏具体的词,术语和英文缩写排前面 |
| TextRank | 0.47 | 11.75 | 偏通用的词,虚词也能排进前十 |
TF-IDF 0.04 秒,TextRank 0.47 秒,差 11.75 倍。差在算法本身:TF-IDF 一遍统计就完事,TextRank 要建词图再到图上迭代收敛。
结果也不一样。TF-IDF 排出的是 MB、ntfy、vditor、venv 这种具体名词,正是技术文章的特征词;TextRank 第一名是「文件」,前十里有「没有」「实际」这类词,因为它在图上按共现关系排序,虚词连接得多就容易靠前。做标签提取选 TF-IDF,做摘要选 TextRank。
边界情况
jieba.cut("")                    →  []
jieba.cut("hello world foo_bar") →  ['hello', ' ', 'world', ' ', 'foo', '_', 'bar']
jieba.cut("1234567890!!!???。。。") →  ['1234567890', '!', '!', '!', '?', '?', '?', '。', '。', '。']
单行 12 万字                       →  0.16 秒,60000 词
空字符串返回空列表,不报错,可以直接喂进循环。纯英文按空格切,空格本身也作为一个 token 返回,所以做词频统计时要自己过滤掉空白。标点会被逐个拆成单字符,数字串和英文单词不会被切碎。
12 万字的单行文本 0.16 秒切完,没有长度限制也没有爆栈。真正的坑在别处:jieba.cut 返回的是生成器,直接 len() 会报 TypeError: object of type 'generator' has no len(),要先 list() 转一下。
什么时候别用
要处理上千万字的语料。67.68 万字/秒是单线程数字,一千万字要 15 秒以上。这个量级换 HanLP 或者预分词好的检索引擎更合适。
需要识别新词和歧义。jieba 用的是词典加分词图再加 HMM,遇到没收录的新词只能靠 HMM 猜,准确率有限。要更好的效果得用基于预训练模型的方案。
只做英文处理。它对英文只是按空格和标点切开,没有词形还原和词干提取,NLTK 或 spaCy 才是对的选择。
还没测的两项:并发调用下的线程安全性 / 与 HanLP 在同语料上的准确率对比。前者要起多线程压测,后者要人工标注语料才能算准。