hyperfine 是命令行的基准测试工具,Rust 写的单文件 exe。给它几条命令,它每条跑几十轮,然后告诉你均值、标准差、最快最慢,以及「B 比 A 慢百分之多少」。做性能对比的时候,不用自己写计时循环,也不用担心第一轮冷启动把均值带偏。
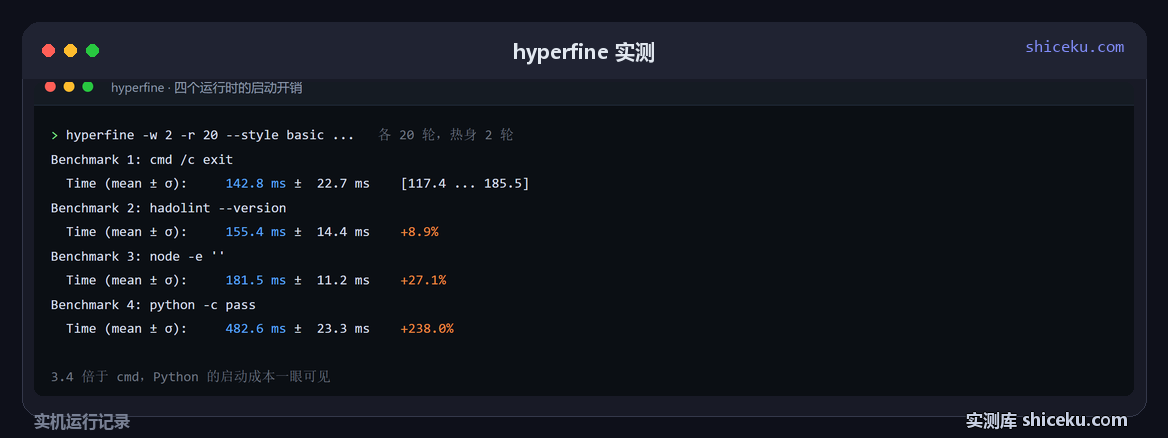
拿它量这台机器上的几个运行时,结论挺直观:Python 启动一次 482.6 毫秒,是 cmd 的 3.4 倍;Node 181.5 毫秒,只比 cmd 慢 27.1%。
一条命令跑一组对比
hyperfine -w 2 -r 20 --style basic \
  -n "cmd /c exit"    "cmd /c exit" \
  -n "python -c pass" "python -c pass"
-n 给每条命令起个名字,报告里显示这个名字。-w 2 是热身 2 轮不计入成绩,-r 20 是正式跑 20 轮。默认情况下 hyperfine 会自己决定跑几轮,但对比启动开销这类毫秒级任务时,固定次数更利于复现。
输出是四列:均值、标准差、最小值、最大值,最后给一行相对基准的百分比。这个百分比以第一条命令为基准,后面每条都跟它比。
四个运行时的启动开销
同一台机器、各 20 轮、热身 2 轮,比的是「什么都不干,启动起来立刻退出」要多久:
| 命令 | 均值(毫秒) | 标准差(毫秒) | 比 cmd 多(毫秒) | 相对 cmd |
|---|---|---|---|---|
| cmd /c exit | 142.8 | 22.7 | 0 | 基准 |
| hadolint --version | 155.4 | 14.4 | 12.6 | +8.9% |
| node -e "" | 181.5 | 11.2 | 38.7 | +27.1% |
| python -c pass | 482.6 | 23.3 | 339.8 | +238.0% |
cmd 自身 142.8 毫秒,这是 Windows 上起一个 shell 进程的底价,任何走 cmd 的方式都逃不掉。hadolint 只贵 12.6 毫秒,一个 Haskell 写的静态检查器启动开销几乎可以忽略。Node 比 cmd 多 38.7 毫秒,Python 多 339.8 毫秒。
标准差这一列也值得看:cmd 的 22.7 毫秒最大,说明它波动最大;Python 的 23.3 毫秒也不小。做对比时如果两条命令的差值小于标准差之和,这个差值就不太可信。
同一个任务,两种写法差 13%
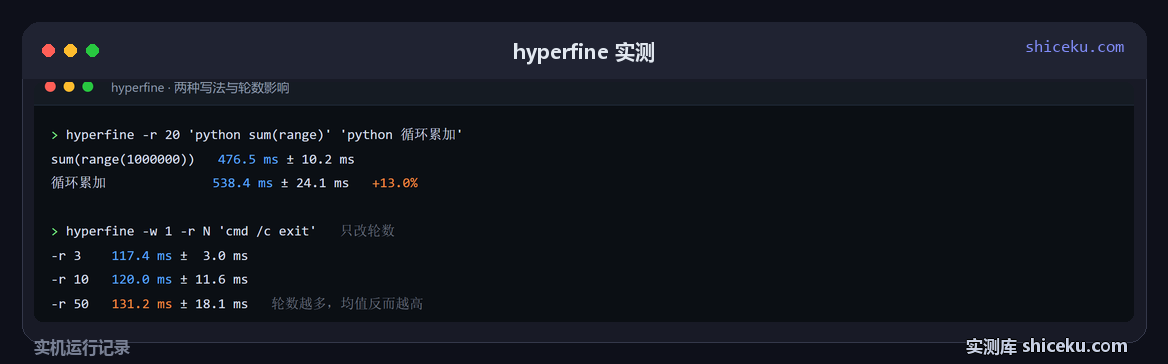
把 0 到 999999 求和,一个是内置的 sum(range()),一个是手写循环累加,各跑 20 轮:
| 写法 | 均值(毫秒) | 比内置多(毫秒) | 相对内置 |
|---|---|---|---|
| sum(range(1000000)) | 476.5 | 0 | 基准 |
| 循环累加 | 538.4 | 61.9 | +13.0% |
差值只有 61.9 毫秒,而两者的启动开销都在 476.5 与 538.4 这个量级,等于九成的耗时跟算法无关。这也说明一件事:Python 短脚本做微基准测试意义有限,先扣掉启动成本再看。
hyperfine 的做法是先热身再计时,扣不掉解释器启动,因为它测的是整条命令的墙钟时间。想只测算法,得在命令内部自己打点。
轮数不是越多越好
| 轮数 | 均值(毫秒) | 标准差(毫秒) |
|---|---|---|
| -r 3 | 117.4 | 3.0 |
| -r 10 | 120.0 | 11.6 |
| -r 50 | 131.2 | 18.1 |
同一台机器上测同一件事,跑 3 轮得到 117.4 毫秒,跑 50 轮反而涨到 131.2 毫秒,标准差也从 3.0 涨到 18.1。原因不复杂:跑得越久,系统上别的东西越可能插进来,风扇转速、后台更新、测温轮询都会体现在均值里。
所以轮数不是越高越准。毫秒级命令用 10 到 20 轮就够,需要判断差异是否显著时看标准差,别只看均值。
结果能直接导出
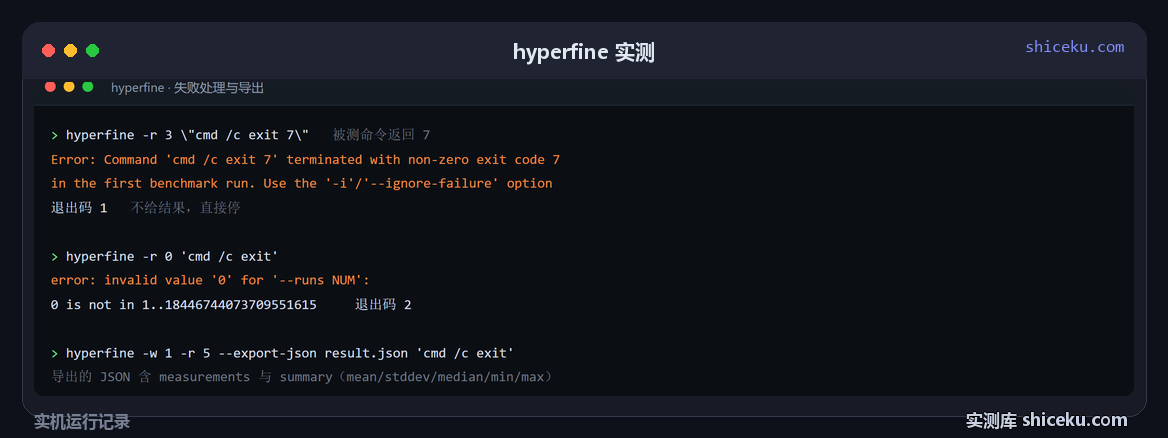
hyperfine -w 1 -r 5 --export-json result.json "cmd /c exit"导出的 JSON 里有每条命令的 measurements 数组和 summary,summary 里带 mean、stddev、median、min、max 和每轮的耗时。写进报告、画曲线、做回归对比都能直接用。除 JSON 外还支持 CSV 和 Markdown。
被测命令失败会中断
> hyperfine -r 3 "cmd /c exit 7"
Error: Command 'cmd /c exit 7' terminated with non-zero exit code 7
in the first benchmark run. Use the '-i'/'--ignore-failure' option
if you want to ignore this.

退出码 1
只要被测命令返回非零,hyperfine 立刻停下,不给你结果,退出码 1。这是防止「测一条一直报错的命令还得出漂亮数字」的设计。确实需要测失败路径时加 --ignore-failure,它会把失败轮次照样计入统计。
命令本身不存在时报的是 program not found,和退出码非零是两种不同的错误,脚本里能区分。另外 -r 0 会在参数校验阶段就被拒,报 0 is not in 1..18446744073709551615。
什么时候它帮不上忙
测的是内存分配或 CPU 指令数。hyperfine 只测墙钟时间,GC、缺页、调度抖动都会混进去。要看分配和指令,得用 perf、valgrind 这类工具。
单次耗时低于 1 毫秒。进程启动本身就一百多毫秒,被测代码再快也被淹掉,得把循环写进被测命令里,测 N 次的平均值。
需要控制 CPU 频率和负载。它不锁频也不隔离核心,同一台机器上跑两次结果差 10% 很正常。要做严格对比,得自己保证环境一致,或者多跑几组看分布。
还没测的两项:--parameter-list 参数扫描的实际用法 / 与 Linux 下 hyperfine 的差异对比。前者要设计一组参数矩阵,后者要另一台机器。