把简体文档转成繁体发给台湾客户,很多工具给出来的结果会让人尴尬:字是繁体了,但「鼠标」还是「鼠標」、「软件」还是「軟件」。台湾人不这么讲,他们说的是「滑鼠」和「軟體」。OpenCC 能把这一层也处理掉,前提是配置选对——带 p 和不带 p,结果完全是两回事。
它是开源的中文转换工具,支持简繁互转,带 p 后缀的配置还会处理台湾用词(s2twp、tw2sp)。既有 C++ 库,也有 Python 包和命令行工具。
我在 Windows 上装了 1.4.2,12 个配置都能加载;转换结果则对比了 s2t、s2tw、s2twp、s2hk 和 t2s、hk2s、tw2sp 这几组。
不想敲命令的话,我打了个 exe
上面这些都在命令行里验证的。考虑到不是所有人都愿意开终端,我把同一套东西打成了单文件 exe,10.1 MB,双击就出菜单,不用装 Python,也不联网。
里面有这些:
- 7 种转换方向,覆盖简转繁、简转台(含用词)、简转港、以及三个反向
- 整段文字直接粘贴就能转,也可以把 txt 文件拖进来批量处理
- OpenCC 1.4.2 的 38 个词典文件全部打进包里,用的时候不用再下
- 每次转完显示耗时,并注明「由实测库 shiceku.com 转换」
它就是把这篇里的命令行操作包了一层菜单,转换结果和 opencc -c s2twp 完全一样。想要自己写代码调库的,下面也有官方 wheel。
装它要多久
python -m venv venv
venv\Scripts\pip.exe install OpenCC
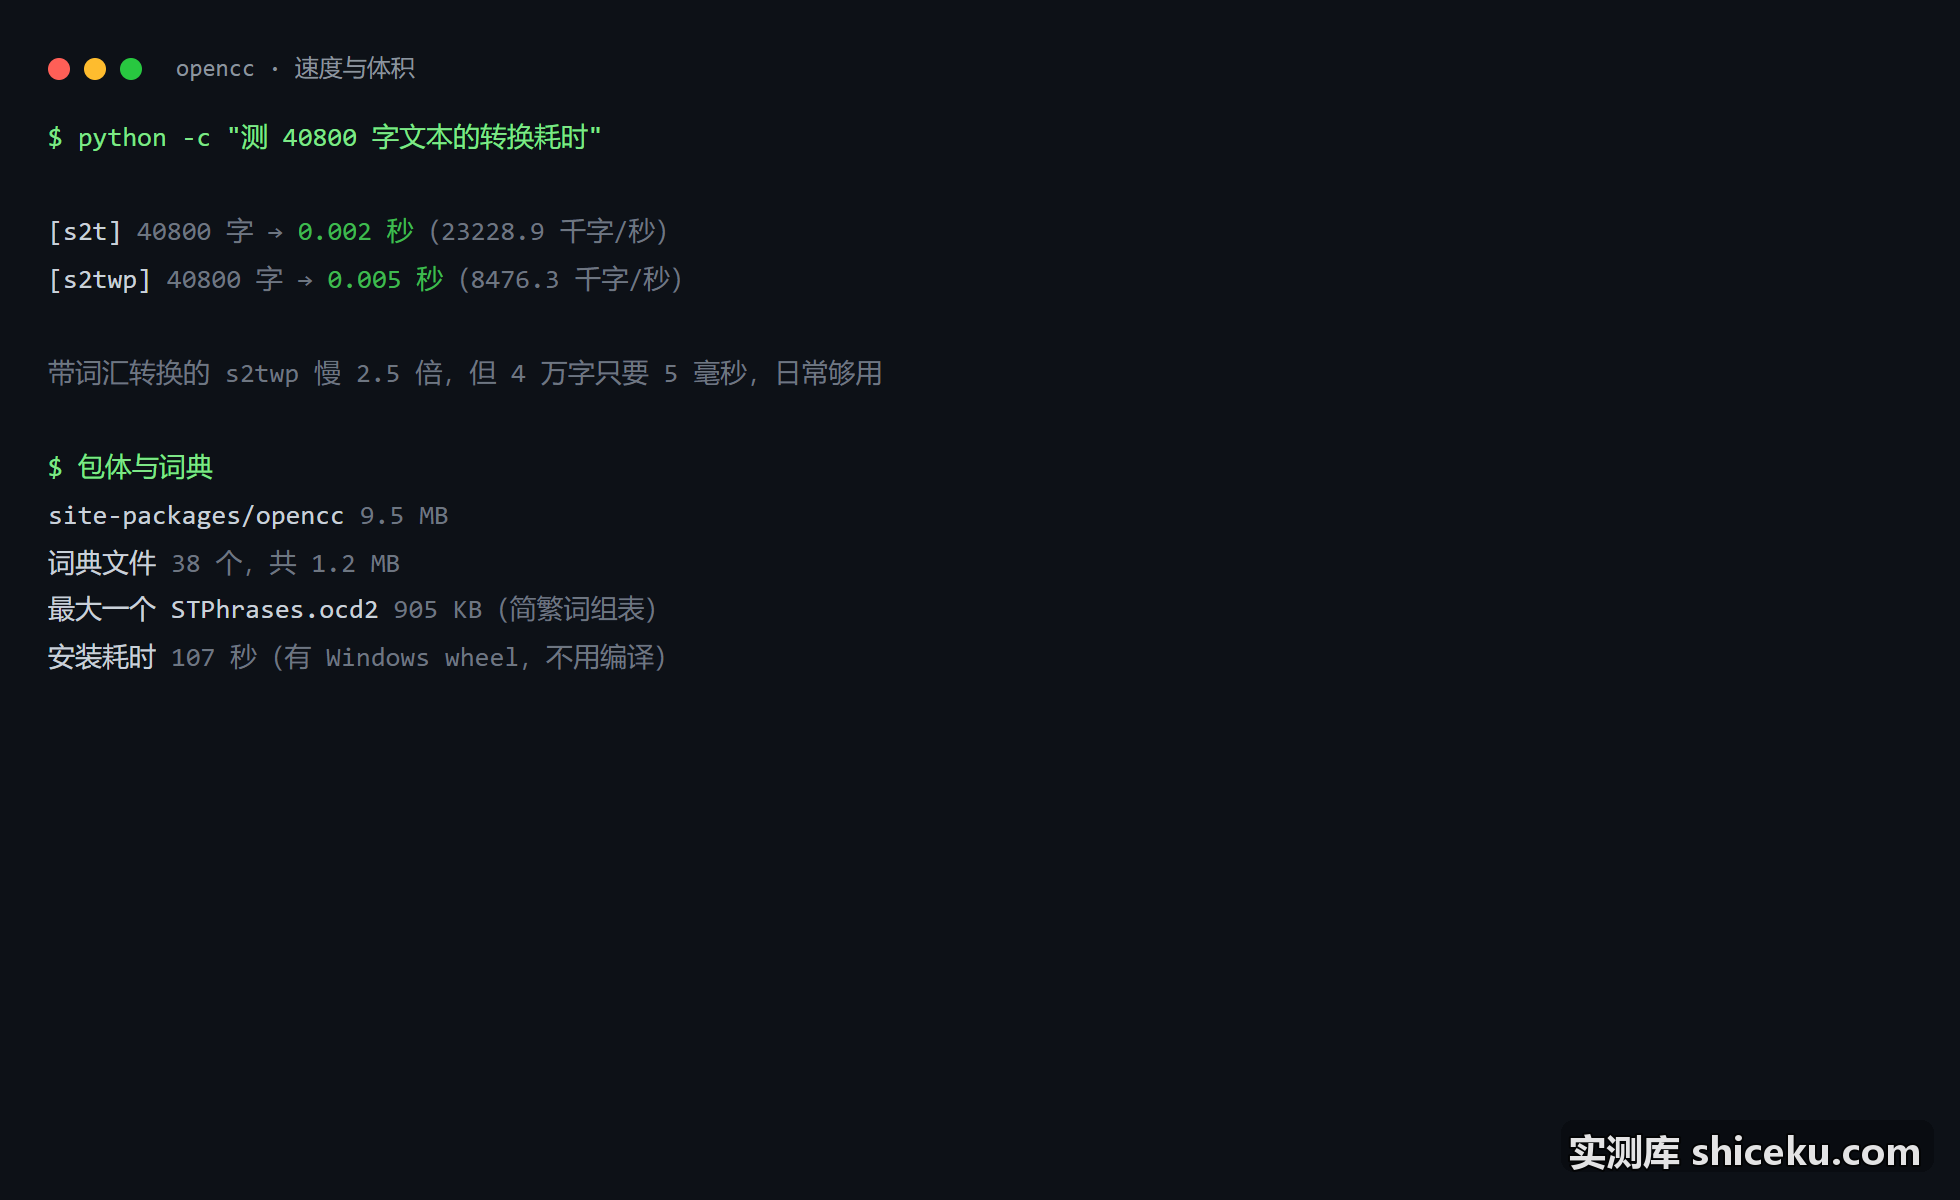
全程 107 秒。PyPI 上有现成的 win_amd64 wheel,不需要 MSVC 编译,也不用先装 cmake,这一点比很多 C++ 项目省事。
装完 site-packages/opencc 占 9.5 MB,同时会在 Scripts 下生成一个 opencc.exe 命令行工具。
12 个配置分别管什么
命名规律很好记:s 是简体,t 是繁体,tw 指台湾,hk 指香港,jp 是日文新字体,p 后缀表示带词组转换。
| 配置 | 方向 |
|---|---|
s2t | 简体 → 繁体,只换字形 |
s2tw | 简体 → 台湾正体,只换字形 |
s2twp | 简体 → 台湾正体,含用词转换 |
s2hk | 简体 → 香港繁体 |
t2s | 繁体 → 简体,只换字形 |
tw2sp | 台湾正体 → 简体,含用词转换 |
hk2s | 香港繁体 → 简体 |
t2tw / t2hk | 繁体内部互转地区变体 |
t2jp / jp2t | 繁体与日文新字体互转 |
12 个配置全部加载成功,没有一个报缺词典。
最关键的一点:字形不等于用词
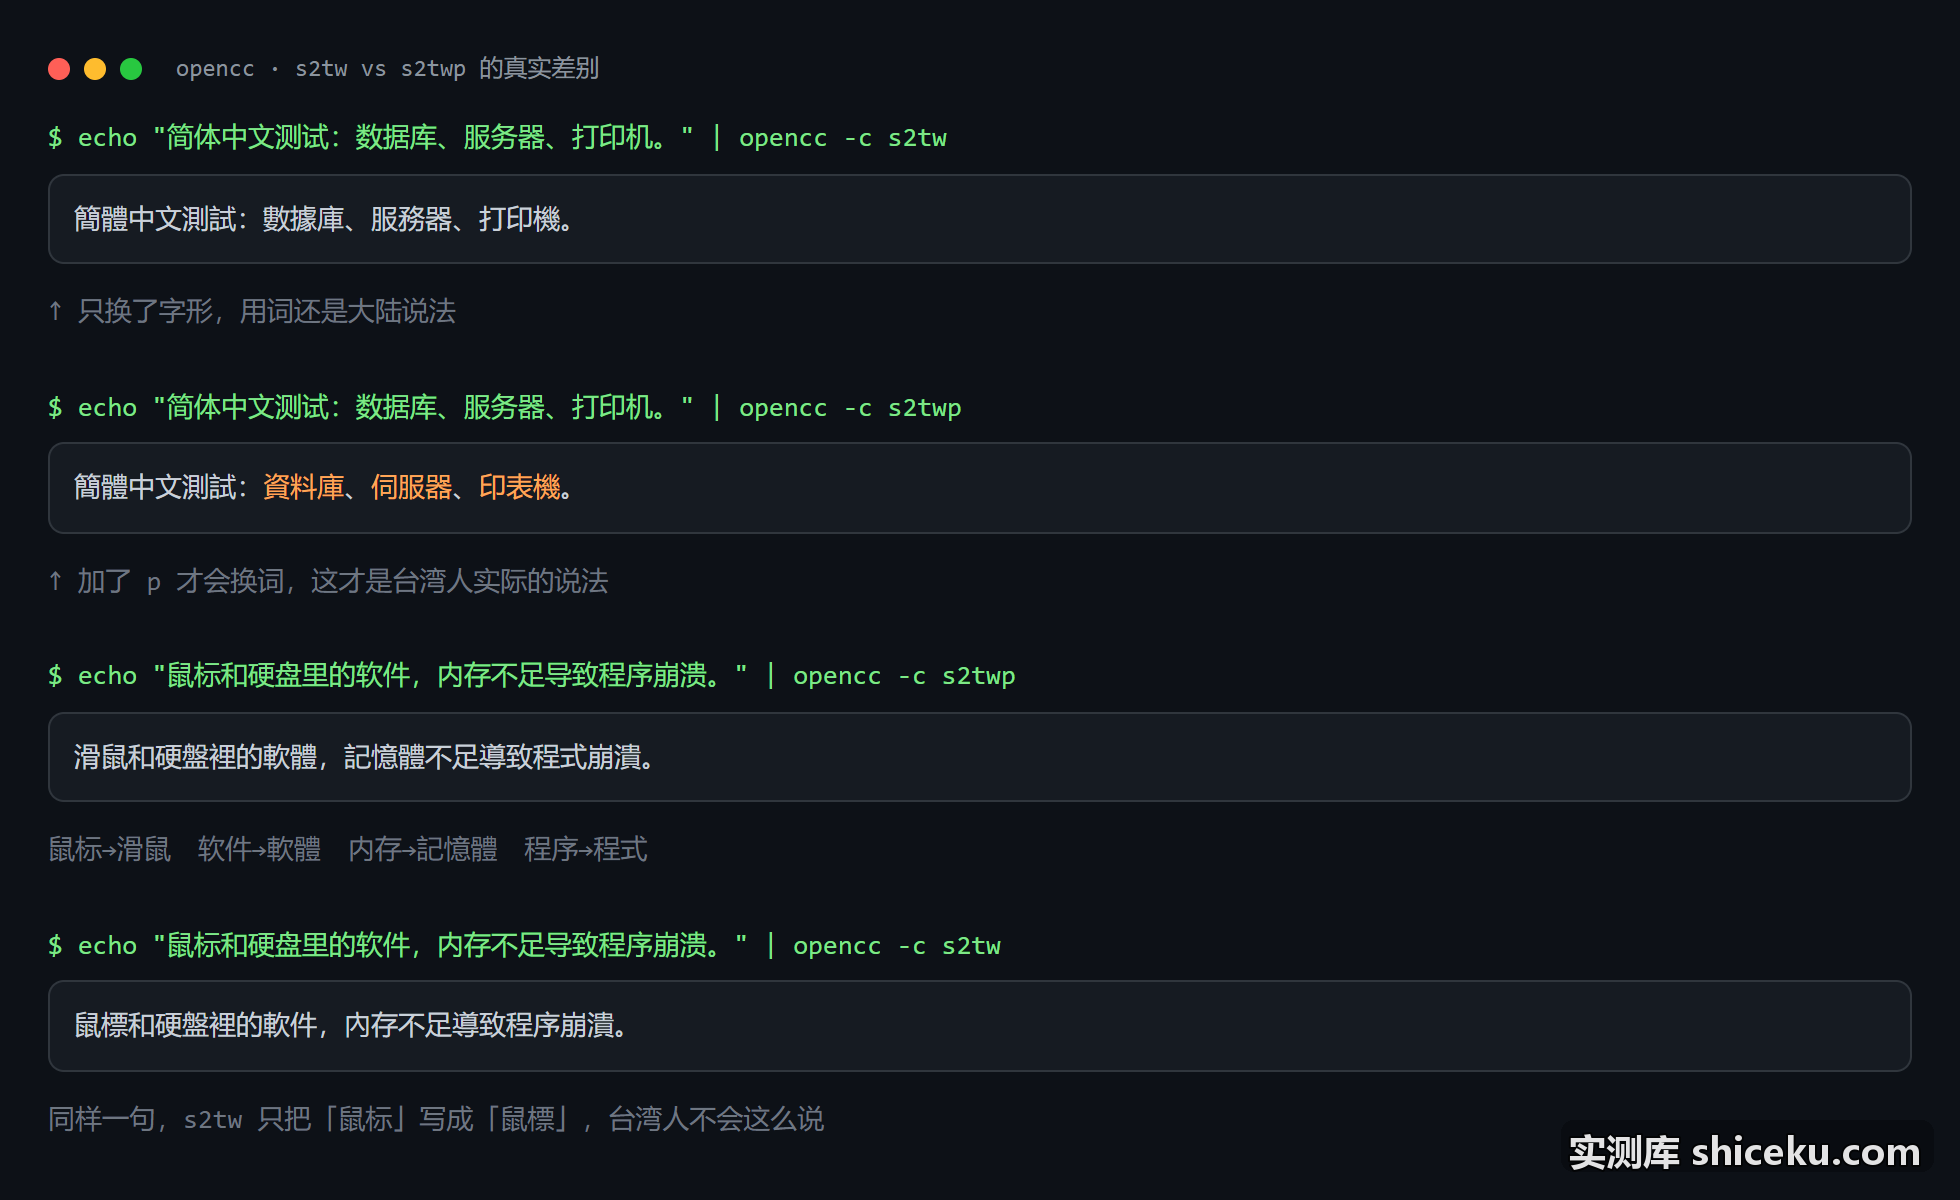
拿同一句话分别过四个「简转繁」配置,输入是「鼠标和硬盘里的软件,内存不足导致程序崩溃」。
| 配置 | 输出 |
|---|---|
s2t | 鼠標和硬盤裏的軟件,內存不足導致程序崩潰 |
s2tw | 鼠標和硬盤裡的軟件,內存不足導致程序崩潰 |
s2hk | 鼠標和硬盤裏的軟件,內存不足導致程序崩潰 |
s2twp | 滑鼠和硬盤裡的軟體,記憶體不足導致程式崩潰 |
前三行几乎一样,只是「里」的写法有差别。只有 s2twp 把「鼠标」换成了「滑鼠」,把「软件」换成了「軟體」,把「内存」换成了「記憶體」,把「程序」换成了「程式」。
简单讲,s2tw 只是把简体字写成繁体字,s2twp 才是改成台湾人真会用的说法。要发给台湾读者,选后者。
再看一组更直观的:
$ echo "简体中文测试:数据库、服务器、打印机。" | opencc -c s2tw
簡體中文測試:數據庫、服務器、打印機。

$ echo "简体中文测试:数据库、服务器、打印机。" | opencc -c s2twp
簡體中文測試:資料庫、伺服器、印表機。
数据库在台湾叫資料庫,服务器叫伺服器,打印机叫印表機。这种差别靠字形转换永远得不到。
反方向也有同样的问题
拿一段台湾写法转回简体,输入「滑鼠和硬碟裡的軟體,記憶體不足導致程式當機」。
t2s输出「滑鼠和硬碟里的软体,记忆体不足导致程式当机」,只是把字形换成了简体,「滑鼠」没变成「鼠标」hk2s表现和 t2s 一样tw2sp才对:「鼠标和硬盘里的软件,内存不足导致程序当机」
注意最后那个「当机」没有转成「崩溃」。词组表覆盖不到的地方,它不会自作主张替换,这一点要心里有数。
速度:4 万字要多久
拿一段 40800 字的重复文本测了一遍:
| 配置 | 耗时 | 折算速度 |
|---|---|---|
s2t | 0.002 秒 | 23228.9 千字/秒 |
s2twp | 0.005 秒 | 8476.3 千字/秒 |
带用词转换的 s2twp 慢 2.5 倍,原因是它要多查一张词组表。但绝对耗时都是毫秒级,转一本书也用不了一秒。
命令行怎么用
装完会多一个 opencc.exe,不给参数就从标准输入读、往标准输出写,所以能直接接管道:
echo "要转换的文字" | opencc -c s2twp处理文件用 -i 和 -o:
opencc -c s2twp -i in.txt -o out.txt还有一个 --resource-zip,可以从压缩包里加载配置和词典,适合把词典跟程序一起分发。
词典里到底是什么
site-packages 下一共有 38 个词典文件,合计 1.2 MB。
STPhrases.ocd2905 KB,简繁词组表,占了绝大部分体积TSCharacters.ocd251 KB,繁简单字对照STCharacters.ocd245 KB,简繁单字对照TWPhrases.ocd2和TWPhrasesRev.ocd2各 23 KB,台湾用词的正反表
词组表比单字表大二十倍,这解释了为什么带 p 的配置慢一些,也解释了为什么它能处理「鼠标 → 滑鼠」这种整词替换。
常见问题
s2tw 和 s2twp 到底差在哪
差在要不要换用词。s2tw 只做字形映射,「鼠标」变「鼠標」;s2twp 会查词组表,变成「滑鼠」。发给台湾读者必须用 s2twp。
Windows 上装要不要编译
不用。PyPI 上直接有 cp313-win_amd64 的 wheel,pip 装完 107 秒就能用,不需要 MSVC 或 cmake。
能处理整本小说吗
从速度看没问题,40800 字只要 5 毫秒。但整本书的内存占用这次没测,超大文件建议先用几千字试一下。
转换结果能直接用吗
不能完全直接发。词组表覆盖不到的地方会保留原词,比如「当机」不会转成「崩溃」。正式发布前建议人工过一遍,尤其是专业术语。
只有 Python 能用吗
不是。它本身是 C++ 项目,官方提供可重用库,其它语言也有绑定。这次只验证了 Python 包和它自带的 opencc.exe 命令行工具。
适合谁
几种典型的用法:
- 把产品文档、说明书发给台湾或香港客户
- 把繁体资料批量转成简体做内部参考
- 做字幕、电子书时统一地区用词
如果你只是偶尔转一两句话,网页版工具够用,不必装。要批量处理、要接进脚本流水线,它这套命令行加库的组合会省很多事。