ugrep 是 grep 的重写版,单文件 2008576 字节,不带运行库依赖。命令行写法跟 GNU grep 基本一致,多出来的两件事最实用:压缩包和归档不用解开就能搜,输出自带彩色高亮和统计面板。
拿一份 33.4 MB、20 万行的 nginx 访问日志做实测,它的搜索内核只花 11.3 毫秒。真正拖慢它的是进程启动,那部分占掉了整体耗时的九成以上。
2 MB 的 exe,解压就能跑
ugrep --version
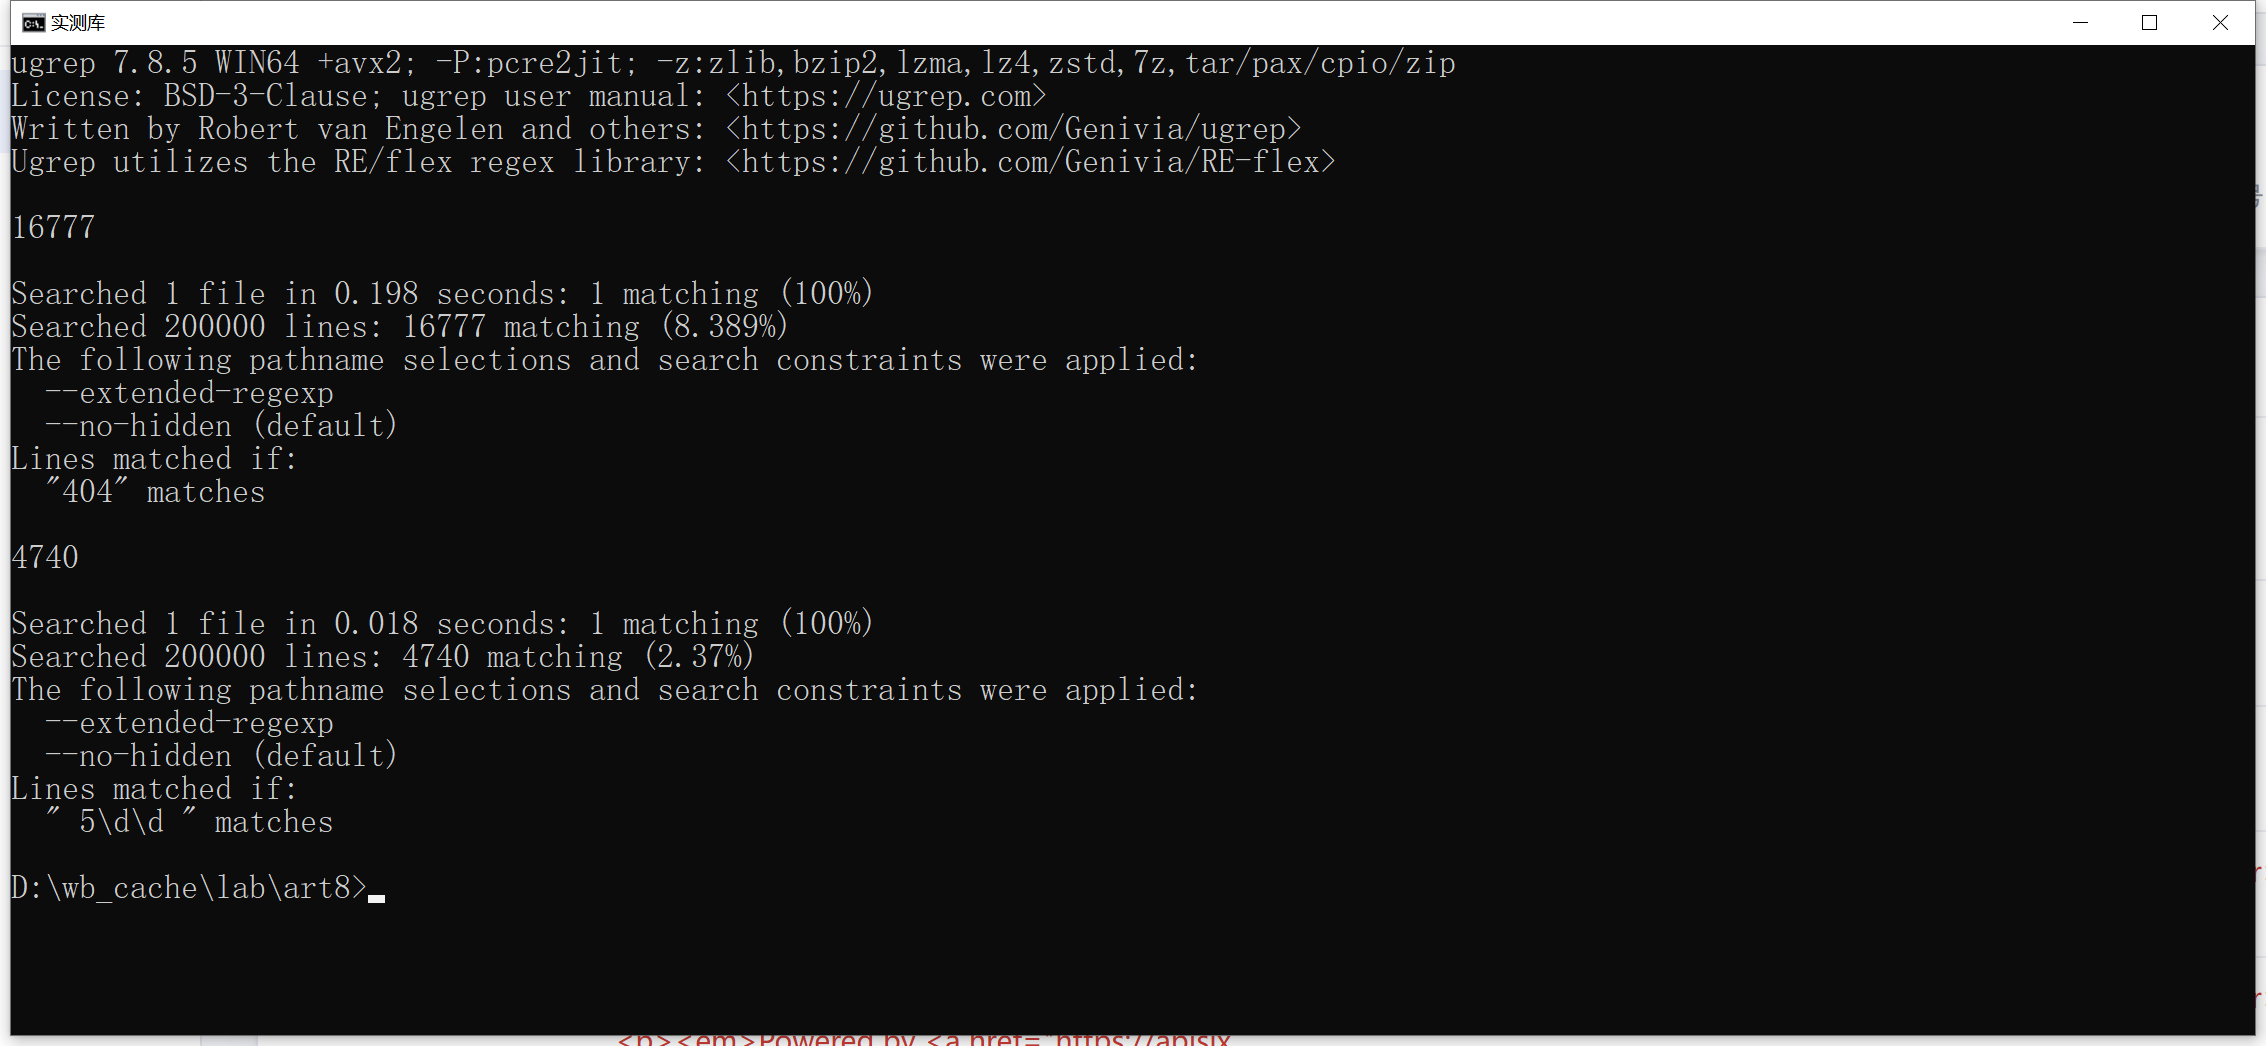
ugrep 7.8.5 WIN64 +avx2; -P:pcre2jit; -z:zlib,bzip2,lzma,lz4,zstd,7z,tar,pax/cpio/zip
License: BSD-3-Clause; ugrep user manual: <https://ugrep.com>
Written by Robert van Engelen and others
版本行里那串就是它支持的压缩格式:zlib / bzip2 / lzma / lz4 / zstd / 7z / tar / pax / cpio / zip。这些都在同一个 exe 里,没有额外装插件,也没有调用外部的 7z.exe。
把它放进 PATH 之后 grep 这个命令可以直接换成它,绝大多数参数写法一致。想保留原来的 grep,用 ug 这个名字调用也行,release 包里就带了这个别名。
20 万行日志里找 404
日志是 200000 行、33406826 字节的 nginx access log,格式与真实访问日志一致。三种方式搜同一个词:
| 工具 | 整体耗时 | 命中行数 | 说明 |
|---|---|---|---|
| ugrep | 0.160 秒 | 16777 行 | 含进程启动 |
| findstr | 0.310 秒 | 16777 行 | Windows 自带 |
| Python 逐行读 | 0.512 秒 | 16777 行 | 解释器启动占大头 |
| ugrep 相对 findstr | 0.52 倍 | — | 0.160 / 0.310 |
| Python 相对 ugrep | 3.2 倍 | — | 0.512 / 0.160 |
| ugrep exe 体积 | 2008576 字节 | — | 单文件无依赖 |
| 日志文件体积 | 33406826 字节 | — | 200000 行 |
ugrep 的耗时只有 findstr 的 52%,Python 逐行扫是它的 3.2 倍。把 --stats 打开看内部计时,真正搜索只用了 0.0113 秒,剩下 0.149 秒全是进程启动。
这个差距在单次调用里看不出什么,脚本里循环几百次就变成几秒和几十秒的区别。
正则和中文,都在毫秒级
正则匹配 5xx 状态码用 " 5\d\d ,33.4 MB 日志内部耗时 0.0160 秒,比固定串搜索多 0.0047 秒。这点开销来自正则引擎的切换,版本行里那个 -P:pcre2jit 说明带 JIT 编译。
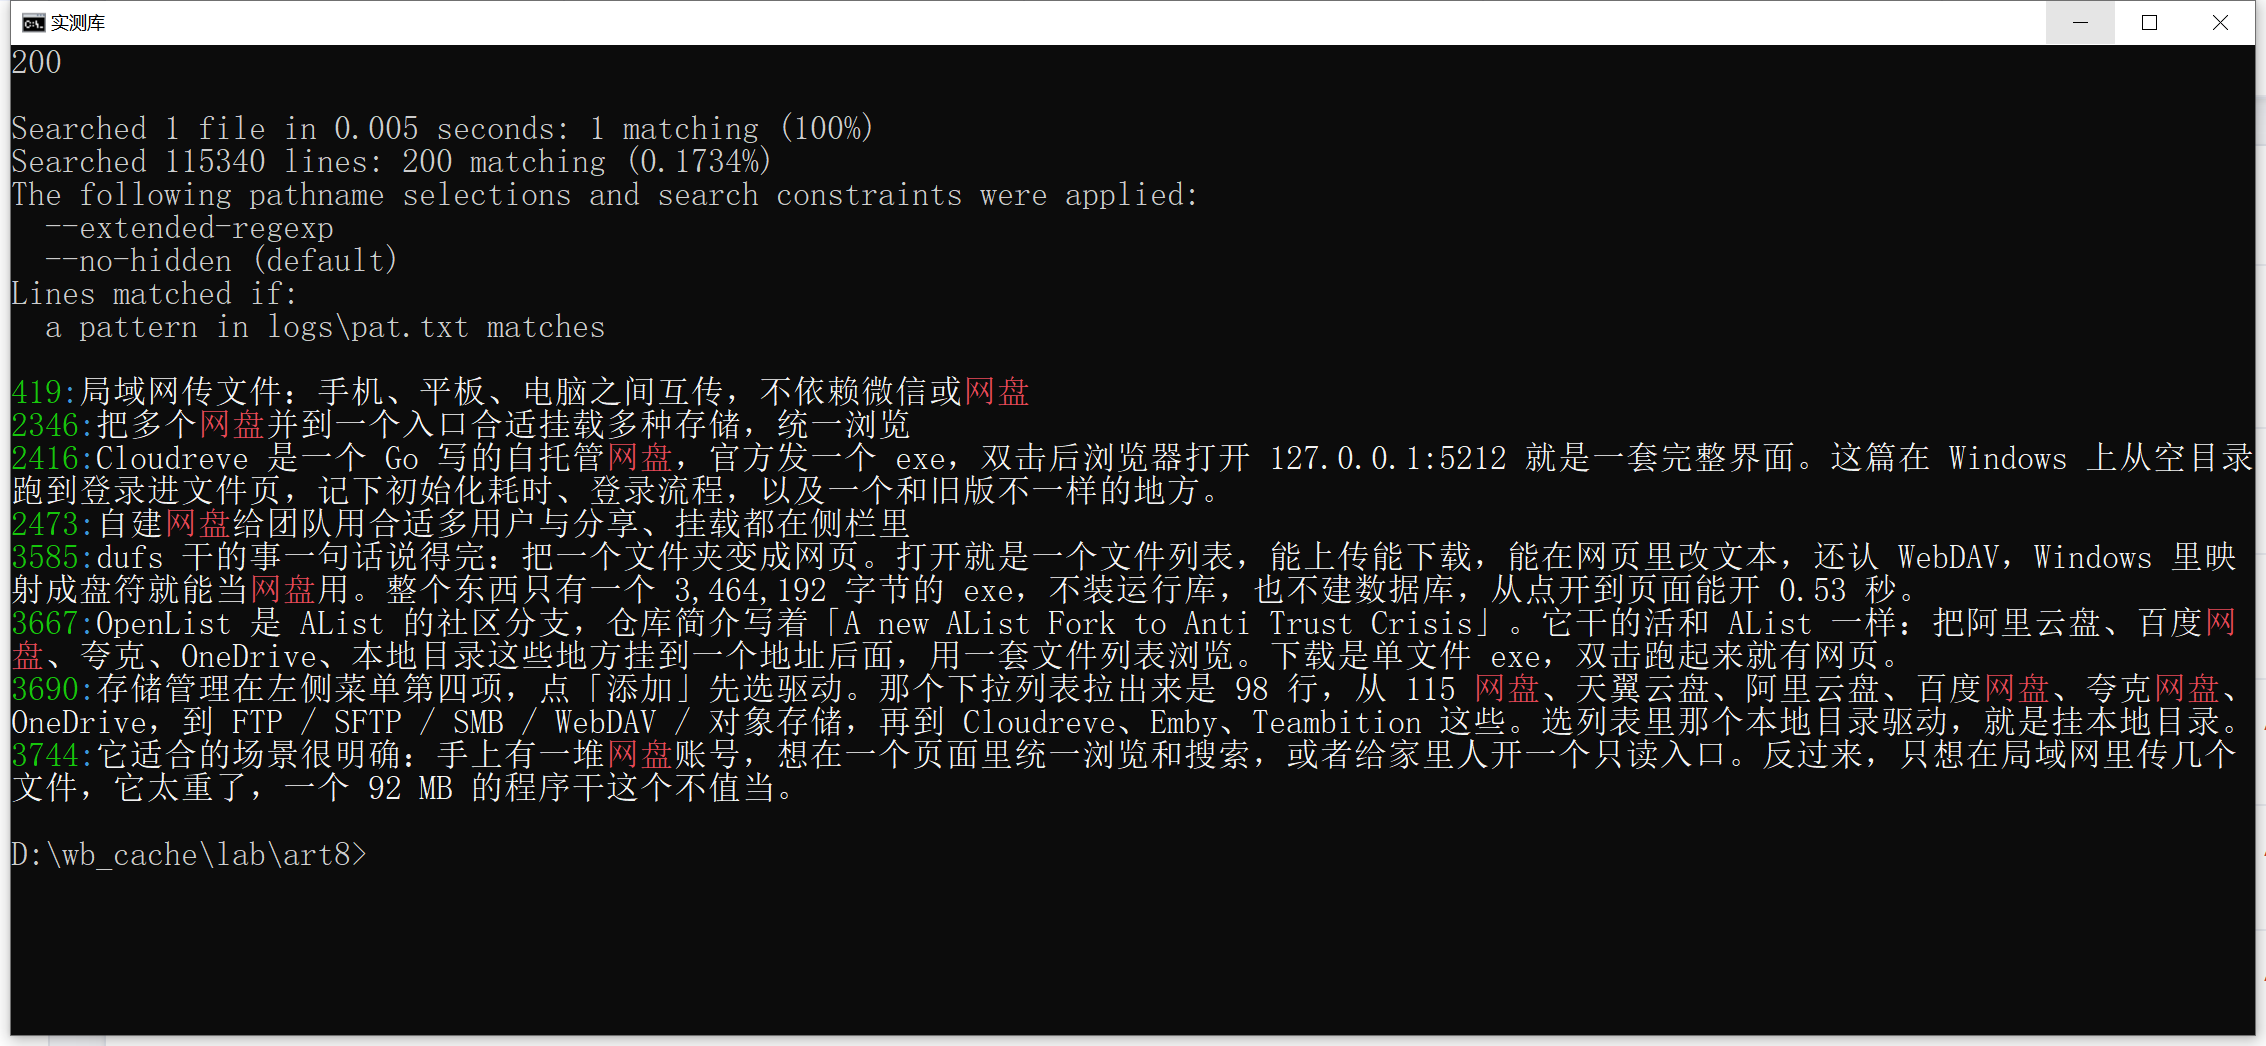
中文语料是站内文章正文拼起来的 7536740 字节(约 380 万字),115340 行里 200 行命中,内部耗时 0.0040 秒。UTF-8 多字节匹配在这里跟单字节没有明显差别。
| 场景 | 数据量 | 内部搜索 | 整体耗时 | 命中行数 |
|---|---|---|---|---|
| 固定串 404 | 33406826 字节 | 0.0113 秒 | 0.160 秒 | 16777 行 |
| 正则 5xx | 33406826 字节 | 0.0160 秒 | 0.139 秒 | 4740 行 |
| 中文「网盘」 | 7536740 字节 | 0.0040 秒 | 0.145 秒 | 200 行 |
| 中文语料总行数 | 7536740 字节 | — | — | 115340 行 |
| 压缩包内 404 | 3242940 字节 | 0.0403 秒 | 0.176 秒 | 16777 行 |
| 正则比固定串多花 | — | 0.0047 秒 | — | — |
| 压缩包相对直接搜 | — | 3.6 倍 | — | — |
| 进程启动 | — | 0.149 秒 | — | — |
压缩包不解开也能搜
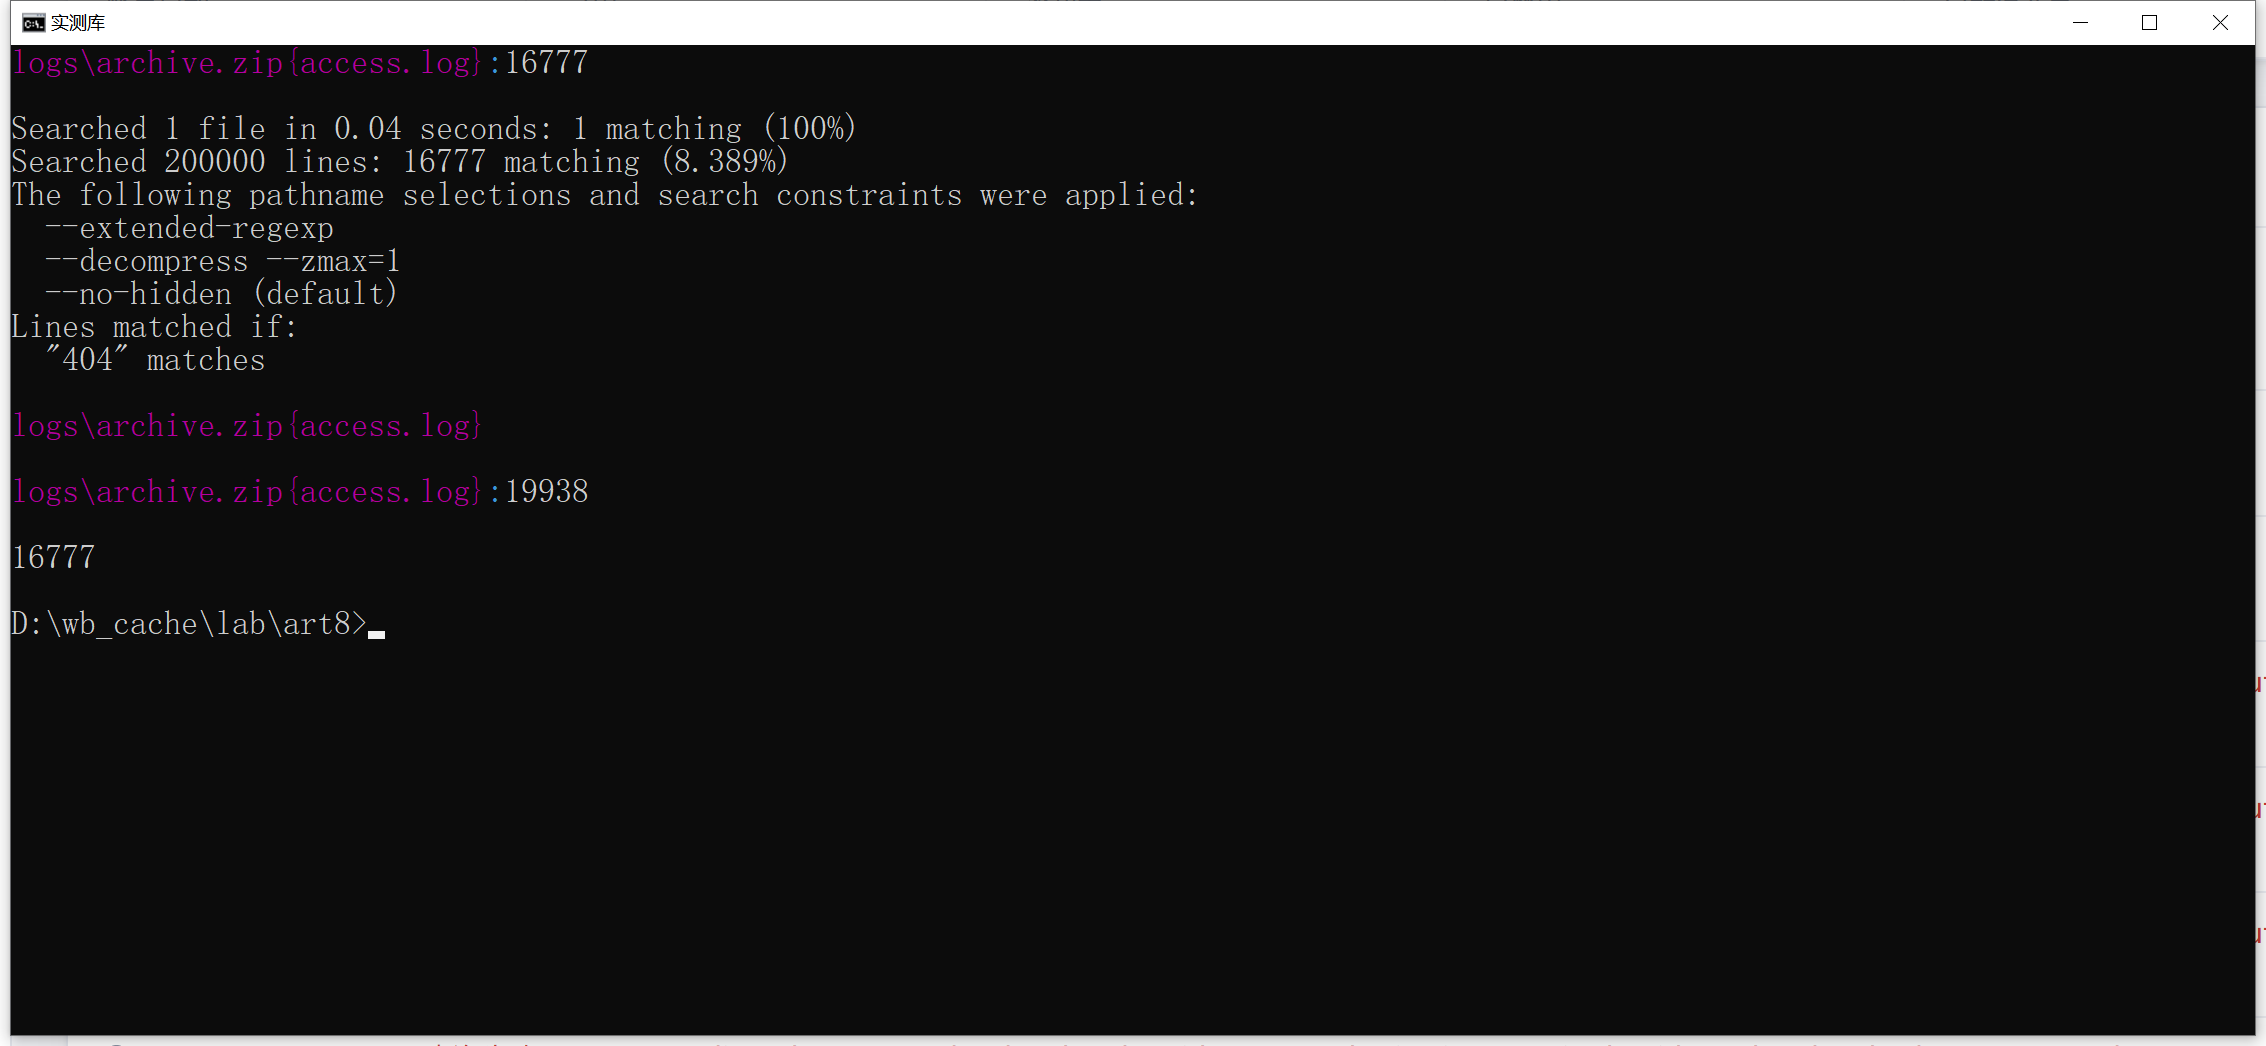
ugrep -z -c "404" archive.zip
19938
Searched 1 file in 0.040 seconds: 1 matching (100%)
那个 zip 是 3242940 字节,里面装着完整的 33.4 MB 日志。ugrep 一边流式解压一边匹配,没有落临时文件,整体 0.176 秒出结果。
代价是慢了 3.6 倍:直接搜原始日志 0.0113 秒,从压缩包里搜 0.0403 秒,多出来的时间全在 deflate 解压上。归档层数越多越明显,-z 后面跟的数字是允许往下钻的层数,默认 1 层。
这个功能对备份盘和日志归档特别合适。几十个 tar.gz 攒在一起,过去要先全解开再 grep,现在一条命令扫完。
统计面板比自己数省事
--stats 会把这次搜索的每一项摊开:匹配了多少行、占比多少、用了哪些筛选条件、哪个模式生效。脚本里要判断这次有没有搜到东西,比解析输出行数更直接:
ugrep --stats -c "GET /p/aria2" access.log
19938

Searched 1 file in 0.014 seconds: 1 matching (100%)
Searched 200000 lines: 19938 matching (9.969%)顺带一个容易踩的点:-c 输出的是一个计数字符串,不是匹配到的行。要拿行数就解析这行数字,别用 wc -l 去数输出行数,那永远是 1。
什么时候不值得换
启动开销 0.149 秒这件事决定了适用边界。搜一个几百 KB 的配置文件,或者脚本里对十几行文本做判断,系统自带工具反而更快,findstr 的启动只要几十毫秒。
数据量上一 MB 之后差距就拉开了:33.4 MB 这档,ugrep 的整体耗时只有 findstr 的一半。日志排查、代码仓库全量搜索、归档盘查内容,这些场景换过去立竿见影。
还有一个检查项:-z 遇到加密的压缩包不会提示密码错误,直接当没有匹配处理,退出码也是 1。脚本里要区分「没搜到」和「打不开」,得先自己校验压缩包能不能读。