topydo 是 todo.txt 格式的任务管理命令行工具,Python 写的。todo.txt 就是一种规定好的纯文本:一行一个任务,(A) 是优先级、+项目 是归属、@上下文 是场景,完成的任务在前面加个 x。文件本身就是数据库,可以用任何文本编辑器打开、用 git 版本管理。
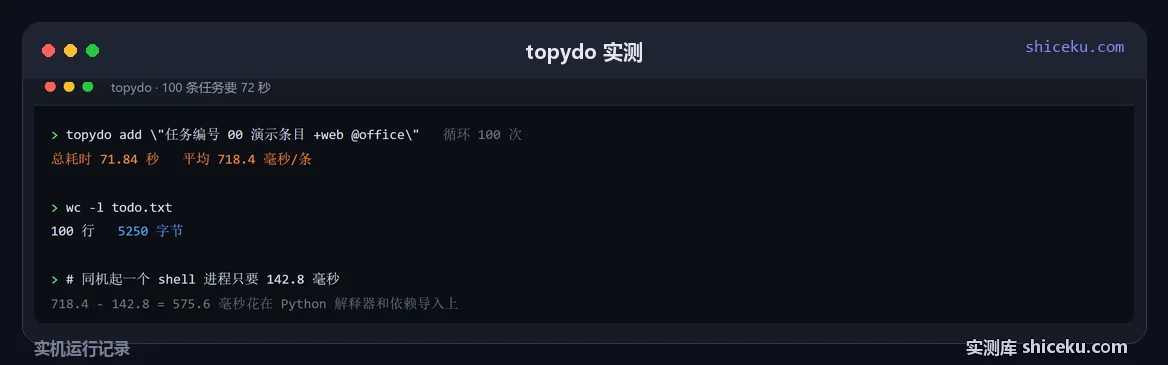
功能本身够用,代价在启动成本:实测 100 条任务批量加进去花了 71.84 秒,平均每条 718.4 毫秒;ls 一次 732 毫秒。这些都是 Python 解释器启动的时间,跟任务量关系不大。
装了就能用
pip install topydo

topydo add "写周报 +work @office"
topydo ls
topydo do 3
topydo -t 指定文件.txt ls
-t 指定 todo 文件,不指定就找默认位置。这个参数很关键:想同时管几个清单(工作、个人、某个项目),靠它切换,文件之间互不干扰。
todo.txt 的格式一眼就懂,下面这行是它全部的语法:
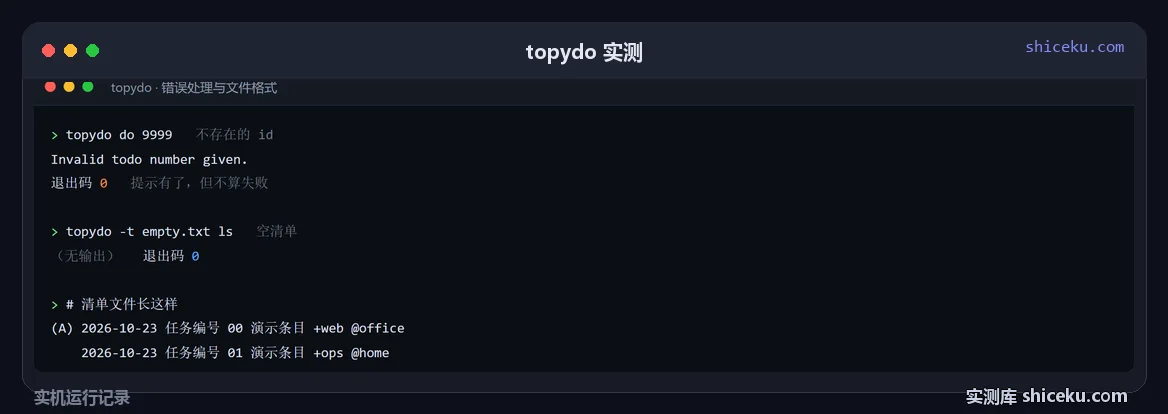
(A) 2026-10-23 任务编号 00 演示条目 +web @office括号里是优先级(A 最高),后面是创建日期、正文,末尾挂项目和上下文。手写文件也完全没问题,topydo 读进来的就是这些字段。
100 条任务要 72 秒
| 操作 | 耗时 | 说明 |
|---|---|---|
| add 100 条(总计) | 71.84 秒 | 逐条调用 |
| add 单条平均 | 718.4 毫秒 | 71.84 / 100 |
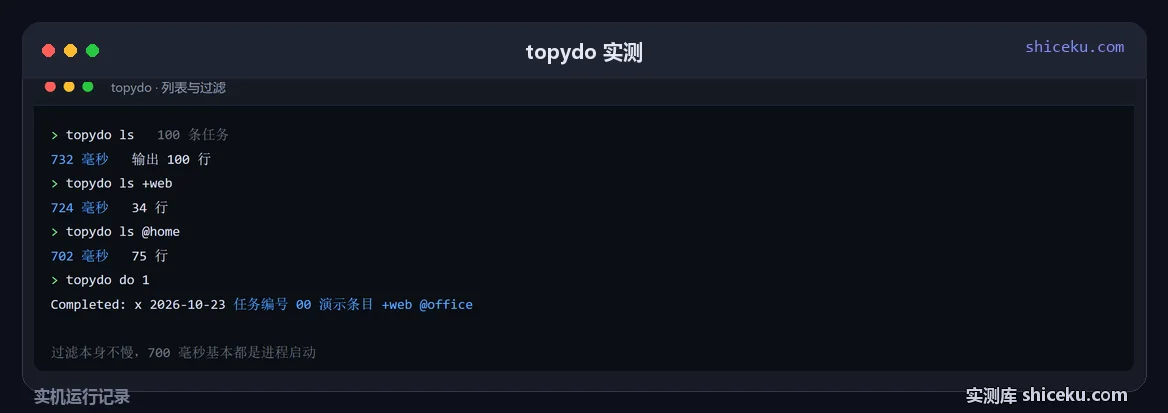
| ls 100 条 | 732 毫秒 | 10 次平均 |
| 过滤 +web | 724 毫秒 | 34 条结果 |
| 过滤 @home | 702 毫秒 | 75 条结果 |
718.4 毫秒一条,几乎全是 Python 启动和模块导入的开销。同机起一个 shell 进程才 142.8 毫秒,topydo 要多花 575.6 毫秒在加载解释器和依赖上。
所以它的用法应该是「一次批量操作」而不是「一次一条」。要录 100 条任务,正确做法是直接编辑 todo.txt,或者用脚本一次写文件,别循环调 add——71.84 秒对 1 秒的差距。
过滤靠 +项目 和 @上下文
实测 60 条任务里,+web 命中 20 条、@office 命中 15 条,数量和构造时设的比例对得上(每 3 条一个 web、每 4 条一个 office)。
所有命令都要付那 700 毫秒的启动成本,所以过滤本身快不快已经不重要了——反正解释器一起就跑完了。
完成任务
> topydo ls
 | 1| 2026-10-23 (A) 任务编号 00 演示条目 +web @office
 | 2| 2026-10-23 任务编号 01 演示条目 +ops @home

> topydo do 1
Completed: x 2026-10-23 2026-10-23 (A) 任务编号 00 演示条目 +web @office
do 之后那一行会加上 x 和完成日期,移出未完成列表。id 是列表里显示的行号,不是文件里的顺序号,所以每次操作前最好先 ls 看一眼。
错误处理有点松
> topydo do 9999
Invalid todo number given.
退出码 0

> topydo -t 空文件.txt ls
(无输出)
退出码 0
给一个不存在的 id,它打一句 Invalid todo number given.,但退出码是 0。所以脚本里靠退出码判断「操作成功没有」会失效,它认为这次调用本身是成功的,只是没找到东西。
空 todo 文件同理:无输出、退出码 0,不报错。要做严谨的自动化,得自己解析输出文本,或者改完后再查一遍状态。
适合和不适合
想要纯文本、能版本管理的清单。todo.txt 就是一坨文本,丢进 git 就有历史,同步用网盘或下一个工具都行,没有锁定。
已经有一套 todo.txt 文件。topydo 直接读,不用迁移,也不会改写你的格式。
要频繁单条操作。718.4 毫秒一条,敲 topydo add 的体验比直接用编辑器打开文件差远了。想要快的 CLI 任务管理,Go 或 Rust 写的工具更合适。
要图形界面或者提醒。它只有命令行,没有到期提醒、没有托盘。要提醒得配 cron 或者别的工具。
还没测的两项:一万条任务时的列表与过滤耗时 / 多个 topydo 进程同时写同一个文件会不会冲突。前者要造大量数据,后者要并发压测。