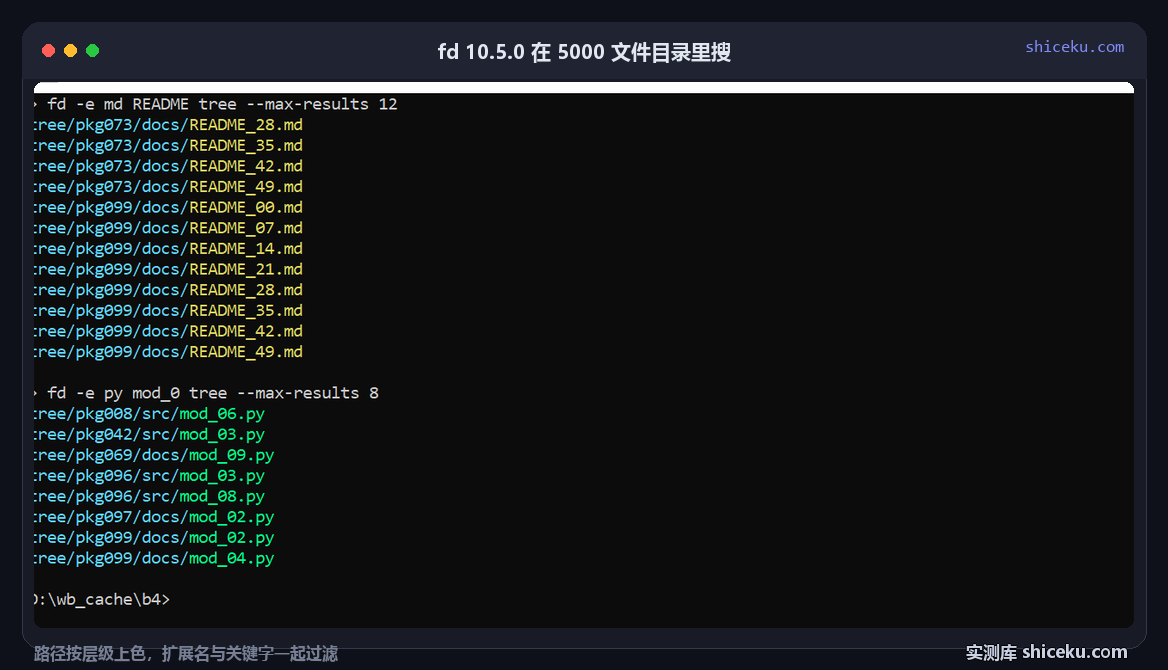
fd 是一个文件搜索工具,主程序 4104192 字节,替掉的是 dir /s /b 再接 findstr。敲 fd 关键字,它按文件名匹配,结果带颜色,路径按层级分段上色。
它解决的问题是「找一个文件要翻三层目录」。Windows 自带的 dir 只能按通配符筛,出了结果还得眼看;fd 支持正则,支持按扩展名和文件类型过滤,还能按层数收窄,结果可以直接交给下一个命令。
这次在 5000 文件、100 个目录的测试树上跑了完整一轮:解压 0.04 秒,版本命令 194 毫秒,搜 4200 个匹配用 166 毫秒,同样条件 dir /s /b 是 351 毫秒。
一个 4104192 字节的搜索器
官方 zip 1535063 字节,解开 14 个条目,主体是 fd.exe 与两套补全脚本。没有安装向导,不写注册表。
| 文件 | 字节 | 作用 |
|---|---|---|
| fd.exe | 4104192 | 主程序,单文件 |
| zip 整体 | 1535063 | 解压后 14 个条目 |
| autocomplete\ | 6 个脚本 | bash / zsh / fish / PowerShell |
| LICENSE-MIT | 1084 | 双授权之一 |
版本命令 194 毫秒
连跑三次分别是 256 毫秒 / 152 毫秒 / 194 毫秒。第一次的 256 毫秒是杀毒软件扫新文件,后两次才接近真实开销。
# 三次耗时 256 / 152 / 194 毫秒
fd --version
fd 10.5.0
输出只有一行版本号,没有构建信息。要核对包,还是比 zip 的 sha256。
装之前只要一个 PATH
单文件程序,没有运行时依赖。要注意的是命令行的两个习惯差异。
| 条件 | 本次实测值 | 说明 |
|---|---|---|
| 系统 | Windows 10 22H2(19045.6466) | 官方给 msvc 的 x64 与 arm64 包 |
| 代码页 | chcp 65001 | 中文路径在 936 下可能显示成问号 |
| 参数顺序 | 先模式后路径 | 写反了路径会被当成搜索词 |
| 授权 | MIT / Apache-2.0 | 可商用,可再分发 |
zip 只有 1535063 字节,因为匹配引擎和忽略规则,连配色都编译进了 exe。它不依赖 git,但会读 git 仓库里的忽略文件。
5000 文件里 156 毫秒出结果
测试树是 100 个目录、每目录 50 个文件,共 5000 个文件加 200 个子目录。三次跑同一个关键字,结果稳定在 156 到 167 毫秒。
| 命令 | 结果数 | 耗时 |
|---|---|---|
| fd mod_ 树目录 | 4200 | 167 / 156 / 166 毫秒 |
| fd -e md README 树目录 | 800 | 193 / 179 / 174 毫秒 |
| fd --glob "*mod_1*.py" 树目录 | 126 | 190 / 171 / 257 毫秒 |
| dir /s /b *mod_* | 4200 | 363 / 350 / 351 毫秒 |
| 测试树规模 | 5000 个文件 | 100 个目录,每目录 50 个文件 |
差距主要在遍历方式
同样的 4200 个结果,fd 中位 166 毫秒,dir 中位 351 毫秒,差两倍多。dir 要把每个匹配的完整路径拼成字符串再输出,fd 走的是自己的目录遍历,边读边匹配。
第三次 257 毫秒那个是缓存抖动,同一条命令多跑几次就会回到 170 附近。报数时看中位数比看单次更靠谱。
它默认替你忽略什么
这是最容易误判的地方:fd 默认跳过隐藏文件,在 git 仓库里还会读 .gitignore。测试树里放一条 *.md,结果直接从 800 变成 0。
| 场景 | 结果数 | 说明 |
|---|---|---|
| 普通目录,-e md README | 800 | .gitignore 不生效,不是仓库 |
| git 仓库内,同上 | 0 | .gitignore 写了 *.md,全被忽略 |
| git 仓库内,加 -I | 800 | -I 关掉忽略规则 |
.gitignore 只在仓库里生效
同一个目录,先不 git init 再跑,忽略文件当摆设,800 条照出;git init 之后同样的命令立刻变 0 条。这个差别解释了很多「为什么别人的机器上搜得到」。
要临时关掉忽略规则,加 -I;要连隐藏文件一起搜,加 -H。两个开关管的是不同的事,别混用。
正则与 glob 是两套语法
默认用正则,--glob 之后换成通配符。同一句 *mod_1*.py,不加参数会被当正则解析,星号在正则里表示前一个字符重复,语义完全不同。
# 正则:mod_ 后面任意字符,最后是 .py
fd "mod_.*\.py" 目录

# glob:通配 * 表示任意字符
fd --glob "*mod_1*.py" 目录

# 按扩展名,最常用
fd -e py mod_0 目录
# glob 那条在测试树上出 126 个结果
cmd 里通配符要先加引号
cmd 不会展开 *,但会把带空格的参数拆开。写 --glob "*mod_1*.py" 时引号留给 fd 自己解析,去掉引号在某些 shell 里会被提前展开成文件列表。
实测那 126 个结果是 glob 模式跑出来的,正则模式同样的意图要写成 mod_1.*\.py。
四个真会踩的地方
把路径当成了搜索词
fd D:\项目 不会列出这个目录,它把整串当模式去搜当前目录,结果是 0 条。列目录要写 fd . D:\项目,前面那个点才是模式。
搜不到刚写的文件
隐藏文件默认跳过,git 仓库里的忽略规则也生效。先加 -H 再试,还不行就加 -I。
结果太多刷屏
5000 文件的树上一条泛匹配就是 4200 行。加 --max-results 20 或者 --max-depth 3,再配合 -x 对结果批量操作。
中文文件名显示成问号
conhost 停在 936 代码页时,UTF-8 路径会乱。先 chcp 65001,字体换等宽中文字体。
什么场景值得上
项目目录里找「那个叫 config 的文件」最合适。166 毫秒出 4200 条,按扩展名一收就剩几百条,比在资源管理器里点目录快。
写批处理时也顺手。--max-results 加 -x 能把结果直接喂给下一个命令,不用先落一个临时文件。
反过来,只偶尔找个下载的文件,用资源管理器的搜索框就够。fd 的价值在「重复找」和「嵌进脚本」这两件事上。
| 项目 | 数值 |
|---|---|
| exe 字节 | 4104192 |
| zip 字节 | 1535063 |
| 4200 条结果 | 166 毫秒 |
| dir 同样结果 | 351 毫秒 |