zoxide 是一个「更聪明的 cd」。你在终端里 cd 过的目录它会记下来并按访问次数排序,之后输入 z 关键词 就能直接跳过去,不用敲完整路径。Rust 写的单文件 exe,数据库就是一个几 KB 的文本文件。
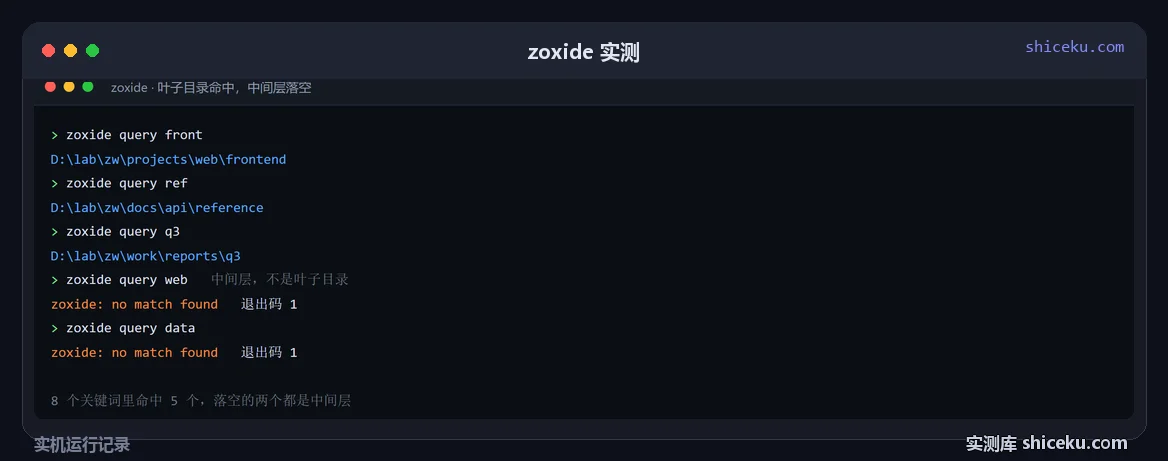
它不是全盘搜索,只认你真正进去过的目录。这一点决定了它的行为和你的预期可能不一样:实测 18 个目录里,查中间的层级名一个都查不到,只有叶子目录才命中。
装法:一个 exe 加一行 init
zoxide --version
zoxide 0.10.0

zoxide init powershell     # 输出 4312 字符、132 行
zoxide init bash           # 输出 6285 字符、181 行
Release 页给的是 zip,解压出一个 zoxide.exe,1261568 字节,不到 1.3 MB,没有运行库依赖。init 生成的是 shell 钩子脚本:它把 cd 换成自己的函数,每次切换目录时顺手把路径记进数据库,同时定义 z 和 zi 两个命令。
钩子脚本要加进 shell 的启动文件,重开终端才生效。PowerShell 放在 $PROFILE,bash 放 .bashrc。
建 18 个目录,看能查到几个
造一棵有辨识度的目录树,逐个 zoxide add 进去,再拿关键词查:
| 关键词 | 命中条数 | 第一条结果 |
|---|---|---|
| front | 1 | frontend |
| ref | 1 | reference |
| q3 | 1 | q3 |
| podcast | 1 | podcast |
| ios | 1 | ios |
| web | 0 | 无 |
| data | 0 | 无 |
「web」和「data」查不到,因为它们是中间层:数据库里存的是 projects\web\frontend 这种完整路径,但匹配是按路径尾部做的,中间的一段不能单独命中。想让「web」能跳,得给它一个自己的目录并 add 进去。
这个设计有它的道理:z 的目的是「跳到我常去的那个地方」,而不是「按前缀找目录」。要按名字搜整棵树,fd 或 fzf 更合适。
常去的目录自动排前面
同一个关键词命中多个时,按 rank 排序。rank 由访问次数和最近一次访问时间共同决定,反复进出会加分。实测里给 projects\web\frontend 加了 6 次、docs\api\reference 加了 4 次之后,查「front」和「ref」都能直接拿到想要的那个。
zoxide query -l 关键词 会列出所有命中项而不只是第一条,脚本里做排除或者看候选很好用。
比 cd 慢,但要看你跟什么比
| 指标 | 数值 |
|---|---|
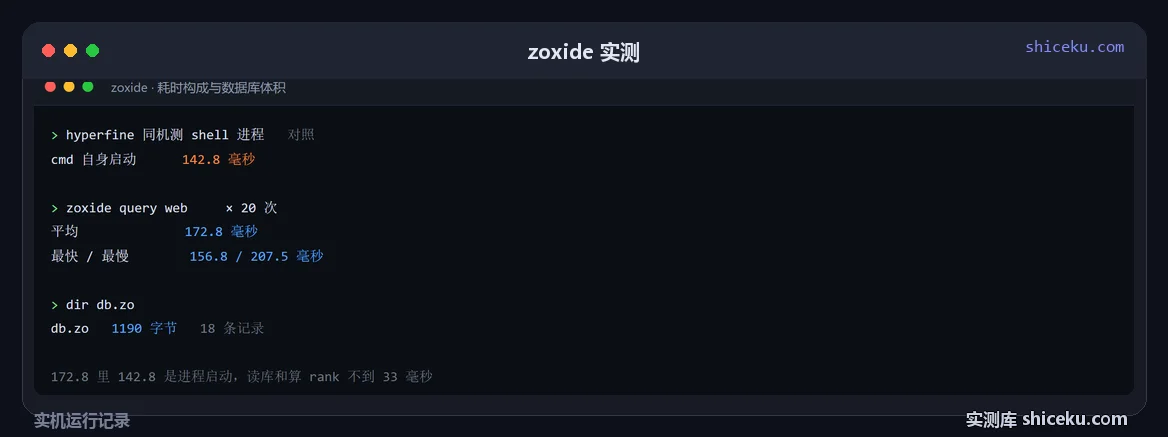
| 一次 query 耗时(20 次平均) | 172.8 毫秒 |
| 最快 / 最慢 | 156.8 / 207.5 毫秒 |
| 18 条记录的数据库 | 1190 字节 |
| exe 体积(字节) | 1261568 |
| 对照:同机起一个 shell 进程 | 142.8 毫秒 |
172.8 毫秒这个数字看着吓人,但其中约 140 毫秒是 Windows 启动进程的固定成本(同机测 cmd 本身就要 142.8 毫秒),真正读数据库和算 rank 的时间只有几十毫秒。数据库 1190 字节,18 条记录,读完就是一次文件读取的事。
实际使用中这 172.8 毫秒被 shell 钩子吃掉了:z 是命令替换,跑完才 cd,所以你能感知到的停顿就是这一下。习惯之后可以接受,但如果你在写循环里反复 cd,累积会明显。
查不到时给的是退出码
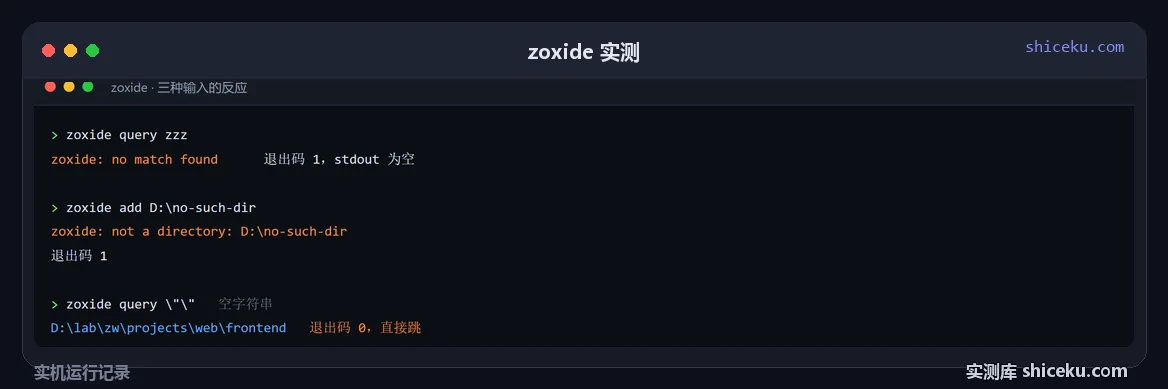
> zoxide query zzz
(标准输出为空)
zoxide: no match found
退出码 1

> zoxide add D:\no-such-dir
zoxide: not a directory: D:\no-such-dir
退出码 1
没有匹配时错误写在 stderr,stdout 是空的,退出码 1。脚本里可以直接判断。add 一个不存在的目录同样退出码 1,不会悄悄建一条无效记录。
有个地方要留意:zoxide query ""(空字符串)不报错,退出码 0,直接返回 rank 最高的那个目录。所以别用空参数做「无输入 = 不跳转」的判断,会跳到意料之外的地方。
适合和不适合
目录层级深、名字记得住。要跳的目录有辨识度,z 项目名 一次到位,比敲 cd ../../.. 强得多。
想在多个 shell 间共享历史。数据库是一个文件,PowerShell、bash、Git Bash 都在往里写,换终端不用重新积累。
需要按名字搜索没去过的目录。它只认 add 过的路径,没进过的目录永远查不到,这一块交给 fd。
在脚本里大量 cd。每次 172.8 毫秒,循环一百次就是 17 秒。脚本里该用绝对路径。
还没测的两项:数据库涨到一万条后的查询耗时 / 多个 shell 同时写数据库会不会冲突。前者要造大量记录,后者要开几个终端并发压。