pandoc 3.13 是文档格式转换器,Windows 包 42983200 字节,解开只有 4 个文件,其中 pandoc.exe 一个就 239168264 字节,占整个目录的 99.8%。
它要解决的是:一份 Markdown 要同时变成网页、Word 和纯文本,用三个工具各写一套脚本。pandoc 把它们收进一条命令,输出格式换一个参数就行。
这次拿它自带的 358616 字节手册当输入,量了四件事:进程本身的启动成本、同一份文档转四种格式各要多久、写文件和不写文件的差别,以及一个 17 字节的空文档为什么也要 200 毫秒。
一个 239168264 字节的 exe
官方 zip 是 42983200 字节,解开 4 个文件共 239630854 字节。压缩比 5.6,因为主程序里静态链接了所有解析器和写出器。
| 文件 | 字节 | 说明 |
|---|---|---|
| pandoc.exe | 239168264 | 主程序,占目录 99.8% |
| MANUAL.html | 离线手册 | 转换参数的完整说明 |
| COPYRIGHT.txt | 许可 | GPL-2.0-or-later |
| COPYING.rtf | 许可副本 | 同一份协议的 RTF 版 |
| 压缩包 | 42983200 | 解压后 239630854,压缩比 5.6 |
239 MB 换的是零依赖
所有输入格式和输出格式的解析代码都编进了这一个 exe,所以它不需要 Lua 运行时、不需要 LaTeX(PDF 除外)、不需要任何 DLL。代价是 239168264 字节的镜像每次启动都要读。
只有 4 个文件
解压出来除了 exe 就是三份文档,没有文件夹层级。拷到 U 盘里在任何一台 Windows 上都能直接跑。
启动本身 172 毫秒
pandoc --version 连跑五次,中位 172 毫秒、最快 167 毫秒。这段时间几乎全花在把 239168264 字节映射进内存上,没做任何转换。
| 命令 | 中位 | 最快 | 输出 |
|---|---|---|---|
| pandoc --version | 172 ms | 167 ms | 342 字节 |
| 17 字节 md → html | 201 ms | 173 ms | 39 字节 |
| 17 字节 md → docx | 200 ms | 194 ms | 10429 字节 |
17 字节的文档也要 200 毫秒
输入是一个标题加一行字的 17 字节文件,转 html 输出 39 字节,耗时 201 毫秒。减去 172 毫秒的启动,真正的解析加写出只占 29 毫秒。
docx 空文档就 10429 字节
同样 17 字节的输入转 docx 输出 10429 字节,因为这格式本质是个 zip,里面必须放 word/document.xml、样式表、关系文件这些骨架。文件再小也省不掉。
358616 字节的文档转四种格式
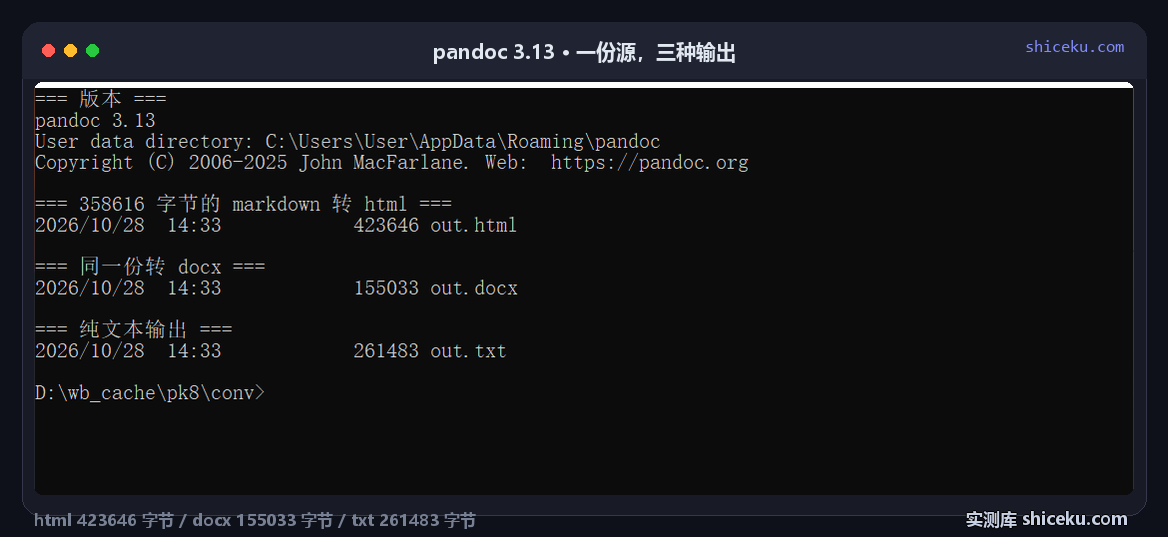
输入是自带的 MANUAL.html 转成 gfm 后的 358616 字节 Markdown。四种输出格式的中位耗时从 559 到 1102 毫秒,输出体积从 155033 到 423646 字节。
| 输出格式 | 耗时 | 输出字节 |
|---|---|---|
| plain 纯文本 | 559 ms | 261483 |
| html5 | 1017 ms | 423646 |
| gfm | 1045 ms | 358463 |
| docx | 1102 ms | 155033 |
html5 输出比源文件大 18%
358616 字节的 Markdown 转成 html5 是 423646 字节,多了 65030 字节,因为每个标题、每段文字都套了标签。转回 gfm 是 358463 字节,几乎等于原文件,说明往返转换基本无损。
docx 体积最小但最慢
155033 字节是四种里最小的,因为 Word 用样式表而不是逐段标记。但耗时 1102 毫秒最长,多出来的时间花在打包 zip 容器上。
纯文本快 458 毫秒的原因
plain 只要 559 毫秒,比 html5 快 458 毫秒。同一份输入、同一次解析,差别全在写出这一步。
| 对比 | 耗时差 | 输出差 |
|---|---|---|
| html5 对 plain | 458 ms | 162163 字节 |
| docx 对 plain | 543 ms | 少 106450 字节 |
写出比解析贵
四种格式的解析过程是一样的,只有写出不同。458 毫秒的差距说明在这个体量上,生成标记和打包容器比读懂 Markdown 更费时间。
docx 慢但输出更小
543 毫秒换来了少 106450 字节的输出。如果目标是发邮件或存档,多等半秒换三分之一的体积是划算的。
写文件和不写文件差 15 毫秒
把 html5 输出重定向到管道而不是写文件,用了 1029 毫秒,写文件是 1017 毫秒,差 12 到 15 毫秒。
| 方式 | 耗时 | 输出 |
|---|---|---|
| 写到 out.html | 1017 ms | 423646 字节 |
| 输出到管道 | 1029 ms | 423646 字节 |
423646 字节的写盘成本几乎为零
15 毫秒写完 423646 字节,说明瓶颈不在这里。真正的时间在解析和生成标记上,磁盘这几百 KB 可以忽略。
管道模式适合接下一步
既然两者耗时几乎一样,可以把输出直接接给别的程序,省掉一个中间文件。要注意的是管道模式下错误信息也会进标准错误,脚本里需要分开捕获。
几个真踩过的点
下面三条在这次测试里真实出现,附当时的处理方式。
| 现象 | 原因 | 处理 |
|---|---|---|
| 转 PDF 直接报错退出 | 包里不含 LaTeX 引擎 | 先装 MiKTeX 或用 html 中转,PDF 这一步 pandoc 自己做不了 |
| 中文 docx 字体变成宋体默认值 | 没有参考文档,样式取自内置模板 | 用 --reference-doc 指定一份自己的 docx |
| 命令跑完没有任何输出 | 默认静默,成功时零输出 | 用退出码判断,或加 --verbose 看过程 |
PDF 需要外部引擎
把输出格式写成 pdf 而系统里没有 LaTeX 时,pandoc 会直接失败退出并提示找不到引擎。它自己只负责生成中间格式,转 PDF 这一步交给 xelatex 或 wkhtmltopdf。
成功时零输出是设计
转换成功时终端什么都不打印,只有出错才有内容。脚本里如果靠输出判断成败会误判,应该看退出码。
什么场景值得上
手上有一批 Markdown 或 HTML 要同时产出多种格式,又不想为每种格式装一个工具时,一个 239168264 字节的 exe 全包了。
| 场景 | 合适度 | 说明 |
|---|---|---|
| Markdown 批量转网页 | 高 | 358616 字节输入 1017 毫秒出 423646 字节 |
| 生成 Word 交付件 | 高 | 1102 毫秒,155033 字节,可套自己的模板 |
| 格式互转做迁移 | 高 | 输入输出格式各一个参数 |
| 转 PDF | 低 | 要另装 LaTeX,不在这个包里 |
| 几十字节的小文件 | 低 | 200 毫秒里 172 是启动成本 |
小文件批量转换会被启动成本拖住
单个 17 字节文件要 201 毫秒,其中 172 毫秒是启动。100 个这样的小文件就是 20 秒,其中 17 秒在重复读那 239168264 字节。批量场景应该先合并成一个大文件再转一次。
授权与费用
GPL-2.0-or-later,个人和商业环境都不收费。源码在 GitHub 上,主要语言 Haskell,release 覆盖 Windows、macOS、Linux 三平台。