markitdown 是微软出的一个转换器,把各种文档转成 Markdown:PDF、Word、PPT、Excel、图片、音频、HTML、CSV、ZIP。它的目标场景很明确,是给大模型喂资料。你把一堆文档转成纯文本,再塞进知识库或者上下文,模型才读得进去。
装完是一个命令
它是个 Python 包,装完多一个 markitdown 命令:
pip install markitdown
markitdown 文件.pdf          # 输出到屏幕
markitdown 文件.docx -o 文件.md   # 输出到文件
用法上没有任何配置项,输入什么格式它自动判断。这对批量处理很友好:写一个循环遍历目录,不管里面混着 pdf 还是 docx,一条命令一个。
HTML 转出来结构全在
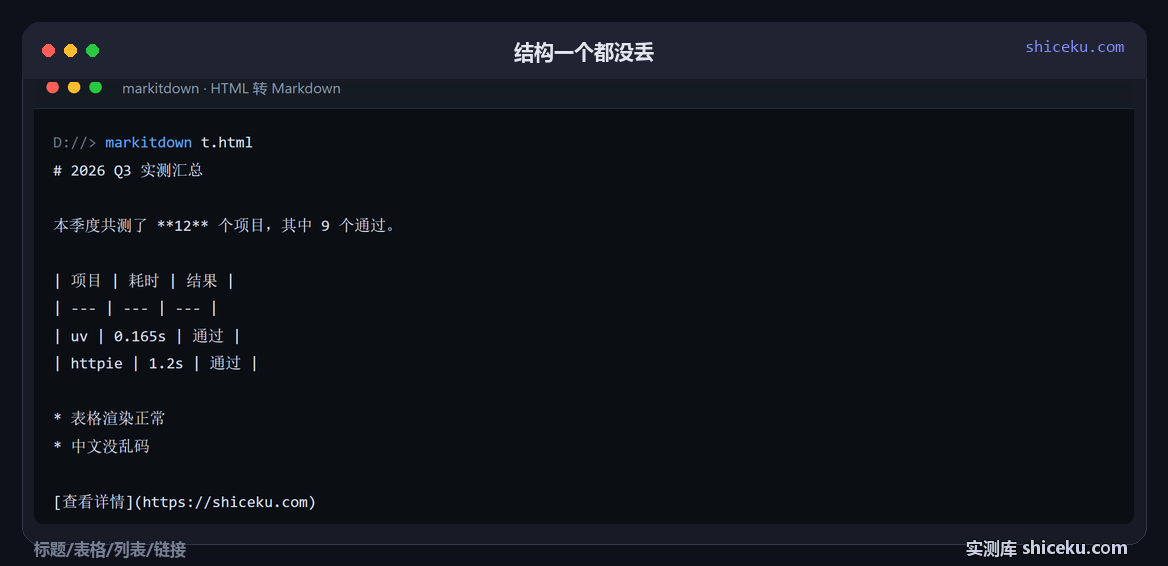
拿一个带标题、表格、列表、链接的 HTML 试:
标题 h1:2026 Q3 实测汇总
段落 p:本季度共测了 12 个项目,其中 9 个通过(12 是加粗)
表格 table:3 列 3 行
列表 ul:2 条 li
链接 a:查看详情,指向 shiceku.com
输出是标准的 Markdown:
# 2026 Q3 实测汇总

本季度共测了 **12** 个项目,其中 9 个通过。

| 项目 | 耗时 | 结果 |
| --- | --- | --- |
| uv | 0.165s | 通过 |
| httpie | 1.2s | 通过 |

* 表格渲染正常
* 中文没乱码

[查看详情](https://shiceku.com)
标题层级、加粗、表格、列表、链接,一个都没丢。中文也没出现乱码,这一点比很多同类工具强。
CSV 变成 Markdown 表格
CSV 输入,它直接给你排成 Markdown 表格,带表头分隔线:
| 项目 | 耗时 | 结果 |
| --- | --- | --- |
| uv | 0.165s | 通过 |
| httpie | 1.2s | 通过 |
| rich | 0.266s | 通过 |
这个转换对喂模型很有用:CSV 是一堆逗号,模型容易数错列;Markdown 表格有竖线对齐,行列关系一眼能看出来。
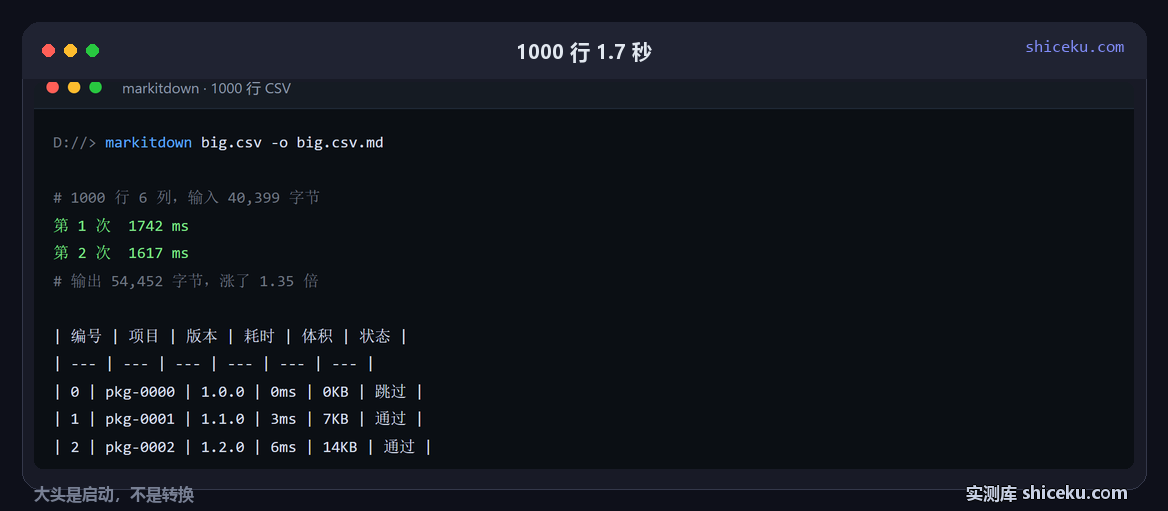
1000 行 CSV 用 1.7 秒
同样 6 列,测三档:
| 输入 | 大小 | 耗时 | 输出 |
|---|---|---|---|
| HTML(简单页) | 480 字节 | 1691 毫秒 | 约 200 字节 |
| CSV(3 行) | 60 字节 | 1586 毫秒 | 约 120 字节 |
| CSV(1000 行 × 6 列) | 40,399 字节 | 1617 到 1742 毫秒 | 54,452 字节 |
注意三档的耗时几乎一样,都在 1.6 到 1.7 秒。因为大头不在转换,在 Python 启动和 import 依赖:同样环境跑一个不联网的命令也要 1.2 秒左右。真正的转换只占 0.3 到 0.5 秒,1000 行 CSV 也没让这个数涨多少。
想批量转几百个文件,别一个个敲命令,直接在 Python 里 import 它:
from markitdown import MarkItDown
md = MarkItDown()
result = md.convert("文件.pdf")
print(result.text_content)
这样只启动一次解释器,几百个文件省下来的时间就是几百秒。
输出体积会涨 1.35 倍
40,399 字节的 CSV 转出来是 54,452 字节,涨了 1.35 倍。原因是 Markdown 表格每行都要加竖线和分隔线,原本一个逗号变成一个「竖线空格逗号空格竖线」。这个膨胀在接受范围内,但如果你要按 token 付费调模型,就得把这一层算进去。
它支持哪些格式
常见的都覆盖了:PDF、DOCX、PPTX、XLSX、图片(走 OCR)、音频(走语音转写)、HTML、CSV、JSON、XML、ZIP、EPUB,还有 YouTube 链接。
图片和音频这两类要额外装依赖,OCR 和转写不是开箱就有的。装的时候用 pip install markitdown[all] 会把它们一起带上,体积会大不少。
什么时候别用它
它只负责「把结构抽出来变成文本」,不负责保留原始排版。如果你要的是把 PDF 原样转成 Word 保持字体和页边距,它做不到,那是另一类工具的事。
扫描版 PDF 也是一样:如果整页是图片没有文字层,它要么走 OCR 要么直接给你空内容,取决于你有没有装 OCR 依赖。转之前先确认 PDF 里能选中文字。
没测的部分列一下,3 项:PDF 与 DOCX 的实际转换质量 / 图片 OCR 的识别率 / 音频转写的耗时。