sd 是一个命令行查找替换工具,主程序 2290176 字节。它把 sed -i 's/旧/新/g' 那套写法换成两个位置参数:一个正则,一个替换串。
它解决的问题是「批量替换要背 sed 语法」。Windows 上连 sed 都没有,替代品是手写 PowerShell 循环,转义规则各不相同,改一次配置要试三次。
这次拿 6577780 字节的文本文件做了三组对照,共 20 万行:原地改写、标准输入到标准输出、同样任务用 Python 处理。
解压出来 12 个条目
官方 zip 888027 字节,解开 12 个条目,主程序 2290176 字节,其余是 LICENSE、CHANGELOG 和六个 shell 补全脚本。
| 项目 | 字节 | 说明 |
|---|---|---|
| zip 整体 | 888027 | msvc 构建 |
| sd.exe | 2290176 | 单文件,无依赖 |
| 解压条目 | 12 个 | 含 6 个补全脚本 |
| 版本命令 | 150 毫秒 | 后两次 120 / 118 毫秒 |
版本号印的是 1.0.0
# 三次耗时 150 / 120 / 118 毫秒
sd --version
sd 1.0.0
包的标签是 v1.1.0,可程序自己印的是 1.0.0。这个版本串没跟着发版更新,拿文件名核对会以为下错了包。要确认手里的构建,看 zip 名里的日期比看这行输出可靠。
两个参数就够了
用法是 sd 正则 替换 文件。第三个参数给了文件就原地改写,不给就从标准输入读、往标准输出写。捕获组用 $1 引用,正则语法是 Rust 那套。
20 万行原地改写 226 毫秒
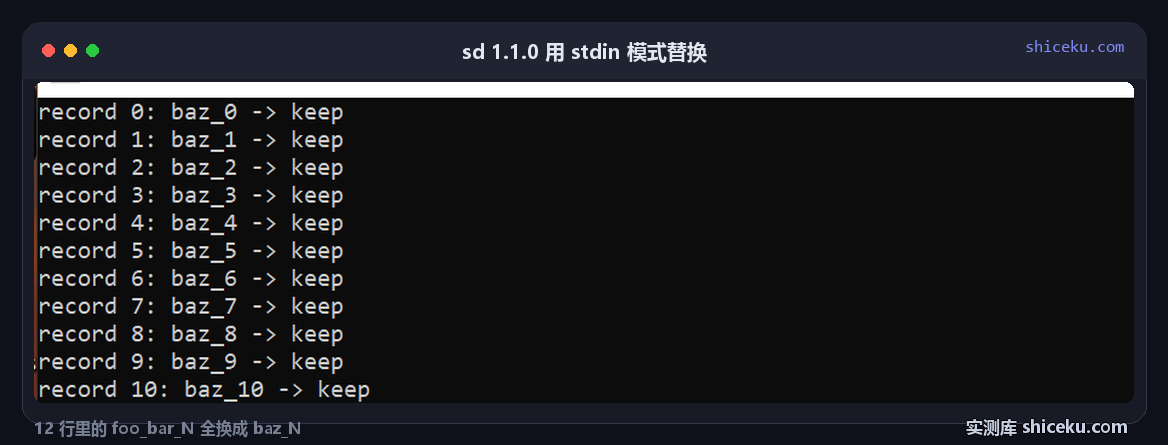
样本是 6577780 字节、20 万行,每行形如 line 0 value foo_bar_0。把 foo_bar_N 换成 baz_N,跑三次是 226 / 246 / 216 毫秒。
| 方式 | 三次耗时 | 输出 |
|---|---|---|
| sd 原地改写 | 226 / 246 / 216 毫秒 | 文件被改写,屏幕无输出 |
| Python re.sub 加写回 | 159 / 62 / 60 毫秒 | 同样改写文件 |
| sd 走标准输入输出 | 494 毫秒 | 5777780 字节 |
| sd 与 Python 差 | 164 毫秒 | 226 减 62 |
| 管道模式多花 | 268 毫秒 | 494 减 226 |
原地改写的输出是零字节
第一次跑完屏幕上什么都没有,容易以为失败了。看文件才发现 200000 处全换掉了,剩余 foo_bar_ 计数是 0。它的原地模式不打印任何东西,要确认就得回去读文件。
Python 快三倍多
同样的替换,Python 读文件加 re.sub 加写回,三次中位 62 毫秒,sd 是 226 毫秒,慢 164 毫秒。原因是 sd 会做编码检测、换行符归一和原子替换,这些都算在耗时里。
# sd:226 毫秒
sd 'foo_bar_(\d+)' 'baz_$1' work.txt
# Python:62 毫秒
python -c "import re;open('w','w').write(re.sub(r'foo_bar_(\d+)',r'baz_\1',open('t').read()))"
文件小了 800000 字节
原文件 6577780 字节,换完是 5777780 字节,差了 800000 字节。20 万行每行少 4 个字符,正好对上这个数,说明没有一行被漏掉或者多换。
| 项 | 数值 |
|---|---|
| 替换前字节 | 6577780 |
| 替换后字节 | 5777780 |
| 差值 | 800000 字节 |
| 每行减少 | 4 个字符 |
| 命中行数 | 200000 行 |
字节差是校验手段
批量替换最怕换了一半。改完比一次体积,差值应该等于行数乘以每行增减的字符数,对不上就说明有行漏掉或者正则多匹配了别的部分。
标准输入模式慢一倍
同样的规则走管道,494 毫秒,产物 5777780 字节。多出来的 268 毫秒花在读管道和写标准输出上,文件没被改,适合接在别的命令后面。
装之前先确认三件事
解压即用,不写注册表。要确认的是正则方言和编码行为,这两样直接决定替换结果对不对。
| 项 | 本次实测 | 说明 |
|---|---|---|
| 系统 | Windows 10 22H2(19045.6466) | 官方 msvc 包 |
| 授权 | MIT | 可商用,可再分发 |
| 正则 | Rust regex 方言 | 不支持反向引用 |
| 编码 | 自动识别 | UTF-8 与 GBK 都能读 |
正则不是 PCRE
\d 与 \w 能用,$1 也能用,(?<name>) 命名组同样支持。(?<=...) 这类后行断言不支持,从 sed 或 PCRE 迁过来的写法要改。
替换串里 $ 要小心
替换串里的 $1 是捕获组,想输出一个字面的美元符号得写成 $$。批量改配置文件时这一条最容易把变量名改坏。
三个真会踩的地方
不给文件就只读不写
漏掉第三个参数时它从标准输入读,结果打到屏幕上,文件纹丝不动。以为改完了,重启服务发现还是旧值,回头查半天。
改完没有输出不等于没改
原地模式跑完屏幕是空的,退出码 0。要确认结果就回头读文件,或者加一个 grep 数剩余命中数,别靠屏幕判断。
多重匹配会连环替换
替换串里包含被匹配的模式时,同一行可能被反复处理。写规则前用 --preview 看一遍改动,比改完再回滚省事。
什么场景值得上
一套配置模板要铺到几十个目录时最合适。一行命令带正则和捕获组,比 PowerShell 的 -replace 少一层转义,也不用担心 $ 被 shell 先吃掉。
反过来,只改一个文件里三处文字的人用不上。编辑器里的全部替换已经够,多装一个 2290176 字节的 exe 换不来时间。
| 项目 | 数值 |
|---|---|
| exe 字节 | 2290176 |
| zip 字节 | 888027 |
| 20 万行原地改写 | 226 毫秒 |
| 同任务 Python | 62 毫秒 |
| 产物字节变化 | 6577780 到 5777780 |