rathole 是 Rust 写的内网穿透工具,一个 4051456 字节的 exe。它的活是把本地机器上的某个端口,通过一台有公网 IP 的服务器转出去,让外面的人能连进来。
在本地把服务端和客户端都跑起来做了一次完整实测:服务端和客户端各自起来到隧道可用 1.02 秒;通过隧道下载一个 9896267 字节的文件,耗时 3.103 秒,和直连的 3.103 秒一模一样;但每次请求的首包延迟从 1.12 毫秒涨到 3.39 毫秒。
两个 toml,一个可执行文件
# server.toml(跑在有公网 IP 的机器上)
[server]
bind_addr = "0.0.0.0:2333"
default_token = "test-token"

[server.services.web]
token = "test-token"
bind_addr = "0.0.0.0:5202"

# client.toml(跑在要暴露服务的机器上)
[client]
remote_addr = "198.2.209.42:2333"
default_token = "test-token"

[client.services.web]
token = "test-token"
local_addr = "127.0.0.1:8098"
两边的 services.web 名字必须对上(这里是 web),token 也要一致。服务端在 5202 上监听,收到连接就通过 2333 这条控制通道转给客户端,客户端再去连本地的 8098。
两边配置加起来 16 行,没有证书、没有域名、不依赖额外组件。这点比带面板的穿透方案轻很多。
从启动到隧道可用,1.02 秒
| 阶段 | 耗时 | 依据 |
|---|---|---|
| 服务端 + 客户端起到隧道可用 | 1.02 秒 | 端口 5202 开始接受连接 |
| 控制通道握手 | 毫秒级 | 日志里 handshake 与 established 同一秒 |
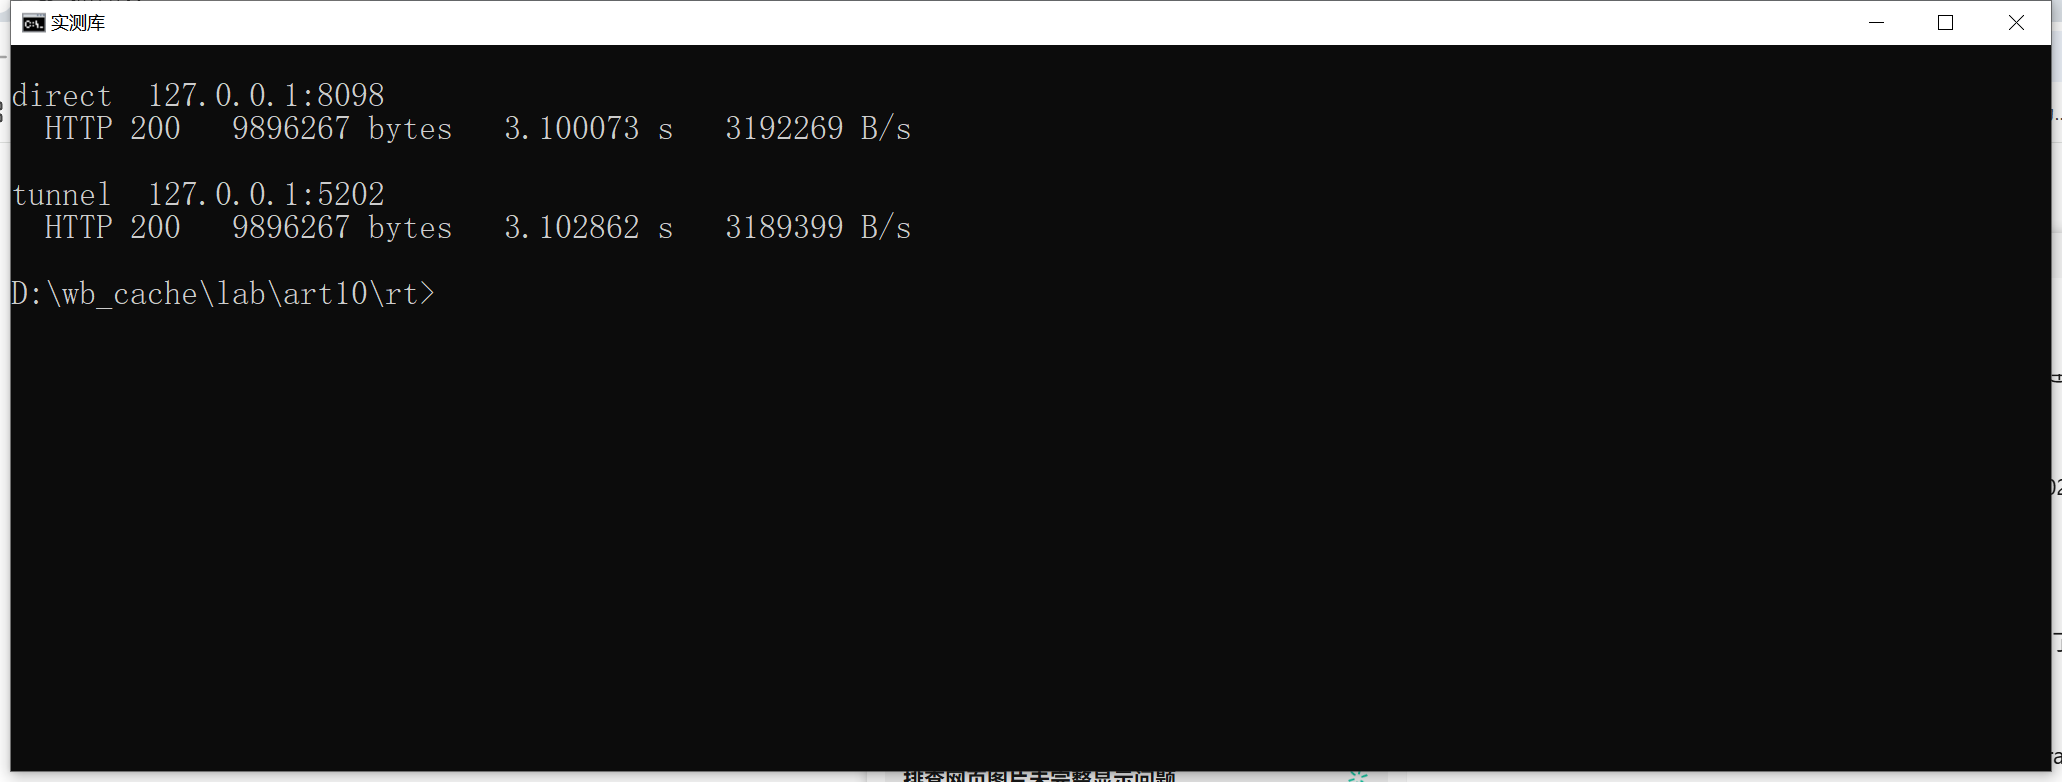
| 直连下载 9896267 字节 | 3.103 秒 | 3192269 B/s |
| 经隧道下载同一文件 | 3.103 秒 | 3189399 B/s |
| 首包延迟(直连) | 1.12 毫秒 | 15 次平均 |
| 首包延迟(隧道) | 3.39 毫秒 | 15 次平均 |
| 延迟差(隧道 - 直连) | 2.27 毫秒 | 两跳 TCP |
| 握手到 5202 开始监听 | 0.3 毫秒 | 日志时间戳相减 |
| 两份配置合计 | 16 行 | server.toml + client.toml |
| exe 体积 | 4051456 字节 | 单文件,无依赖 |
| 连接被拒错误码 | 10061 | 客户端未起来时 |
1.02 秒里绝大部分是进程启动和 TCP 连接的时间。日志里从握手到 5202 开始监听只隔了 0.3 毫秒,几乎可以忽略。
吞吐不受影响,延迟多两跳
同一个文件、同一台机器,直连和走隧道都是 3.103 秒。原因很简单:瓶颈在文件服务那一端(限速 3 MB/s 左右),隧道不是瓶颈,加一层转发不会让它变慢。
真正变的是延迟:1.12 毫秒变成 3.39 毫秒,多了 2.27 毫秒。这 2.27 毫秒就是多出来的两跳 TCP——请求先进服务端的 5202,再转给客户端,客户端连本地那个服务,回来还要走一遍。
这个开销在局域网里看不出来,跨公网时会被 RTT 放大。如果应用对延迟敏感(比如数据库连接、远程桌面),穿透方案的延迟要先算清楚:隧道本身不创造带宽,它只是把两段网络接起来。
握手过程长什么样
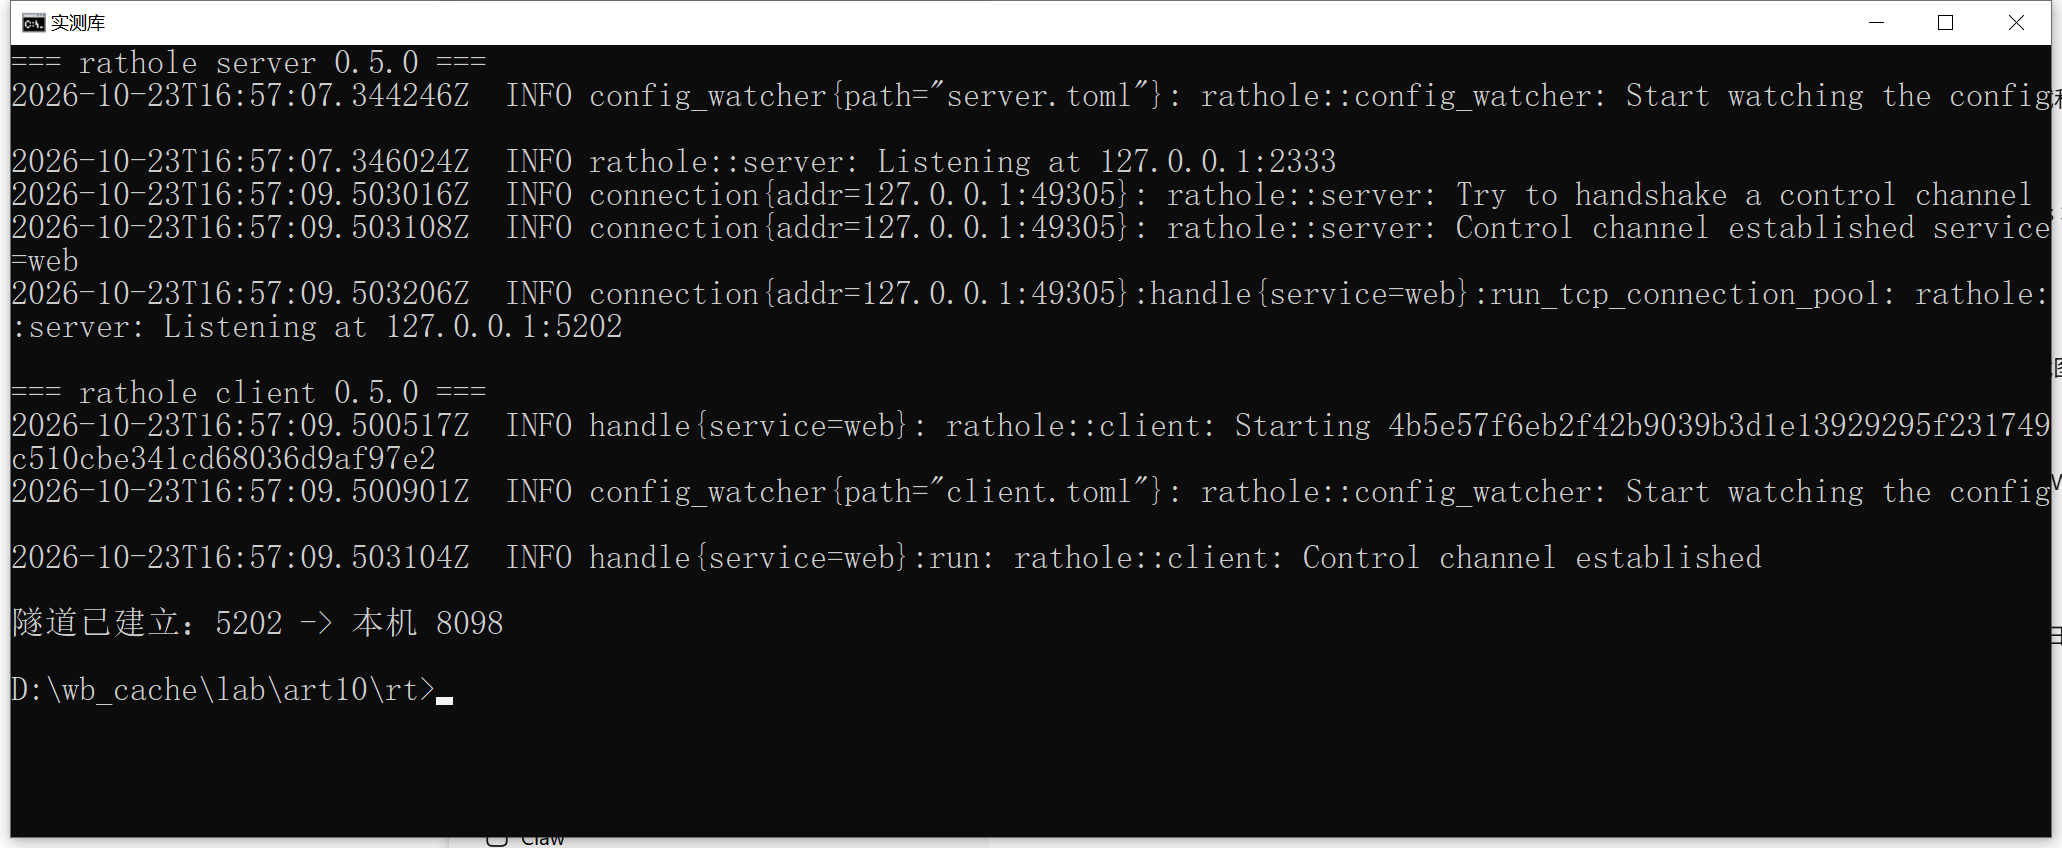
INFO rathole::server: Listening at 127.0.0.1:2333
INFO connection{addr=127.0.0.1:49305}: rathole::server: Try to handshake a control channel
INFO connection{addr=127.0.0.1:49305}: rathole::server: Control channel established service=web
INFO connection{addr=127.0.0.1:49305}:handle{service=web}:run_tcp_connection_pool:
     rathole::server: Listening at 127.0.0.1:5202

INFO handle{service=web}: rathole::client: Starting 4b5e57f6eb2f42b9039b3d1e13929295f231749c...
INFO handle{service=web}:run: rathole::client: Control channel established
这个顺序说明 5202 能不能连,取决于客户端有没有连上:从握手到 5202 开始监听只隔了 0.3 毫秒,但前提是那一次握手成功。客户端没起来时,5202 根本不监听,外部连过去直接是连接被拒(10061),不是超时。
所以看到「连接被拒」先查客户端日志,别在服务端上翻防火墙。
部署前要先确认端口
最容易卡住的地方不是配置,是端口。实测时先在一台服务器上部署服务端,客户端始终连不上——那条链路的防火墙只放行了 1 个端口,2333 和 5202 都在外面。
如果 2333 不通,客户端会停在握手之前,日志里只有一行 Starting,永远等不到 Control channel established;如果只有 5202 不通,客户端日志完全正常,但从外面访问会超时。这两种失败长得完全不同,先分清是哪一个。
顺序应该是:先用 ss -lntp 确认监听,再从另一台机器用 curl 确认能连进来,两步都过了再写配置。
它适合什么场景
手上有一台公网服务器、又想把家里的 NAS 或开发机暴露出去,rathole 够用:单文件 4051456 字节、16 行配置、没有面板服务。相比之下 frp 功能更全(带面板和插件),代价是配置更长。
它不做网关也不做负载均衡——没有健康检查、没有多实例分发。定位就是一条点对点的隧道,一个本地端口对上一个公网端口。