fclones 0.35.0 是重复文件查找工具,单个 fclones.exe 4831623 字节,压缩包 1974285 字节,扫 20000 个文件要 38.5 秒。
它要解决的是:同一个文件在硬盘上躺了几份,占着空间但没人记得。目录属性只说总大小,说不出哪两个文件字节相同。
这次拿一份 10000 个文件、20857118 字节的目录和它的完整副本做输入,量了耗时和输出体积,另外测了它对小尺寸文件的判定门槛。
一个 4831623 字节的 exe
压缩包 1974285 字节,解开只有一个 exe。Rust 编译的静态链接程序,不需要任何依赖。
| 项 | 值 | 说明 |
|---|---|---|
| 压缩包 | 1974285 字节 | fclones-0.35.0-windows-x86_64.zip |
| fclones.exe | 4831623 字节 | 单文件,无依赖 |
| 版本 | 0.35.0 | --version 输出 15 字节 |
| 启动开销 | 138 毫秒 | 五次 --version 的中位 |
138 毫秒是启动成本
--version 只输出 15 字节,还是用了 138 毫秒。这段时间全花在加载 4831623 字节的镜像上,后面的实际回收时从这里开始算。
只有一个 exe,没有配置目录
解压出来就是 cwd 下这么个文件,不写注册表也不建配置目录。参数全部走命令行,用完关掉什么都不留。
扫 20000 个文件要 38.5 秒
输入是两份各 10000 个文件的目录,合计 41714236 字节。group 子命令跑了两遍取中位,38469 毫秒。
| 指标 | 值 |
|---|---|
| 输入文件数 | 20000 个 |
| 输入字节 | 41714236 |
| 耗时 | 38469 毫秒 |
| 输出体积 | 1464194 字节 |
38.5 秒里绝大部分在读文件内容
它会把文件内容读进来算哈希再比对,文件名和大小只用来初筛。41714236 字节走一遍磁盘加哈希,38.5 秒这个量级指向的是 IO。
输出 1464194 字节全是路径
10000 组重复、每组列出两份完整路径,一行一个,攒出 1464194 字节,是输入体积的 3.5%。要看总量得加 --unique 之类的收敛参数。
小文件也照查
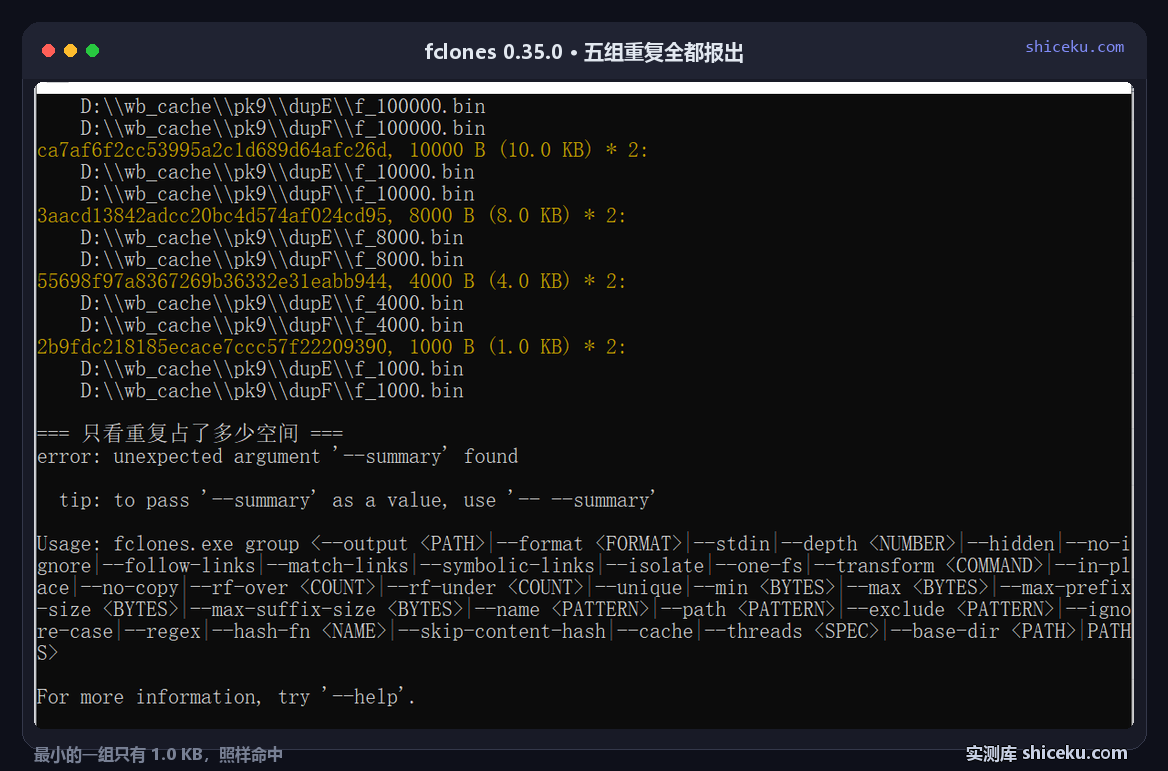
这是它和同类工具差别最大的地方。同一组五个尺寸的相同文件各两份,1000 字节的那份也被报了出来。
| 文件大小 | 是否报重复 |
|---|---|
| 100000 字节 | 报,标 100.0 KB |
| 10000 字节 | 报,标 10.0 KB |
| 8000 字节 | 报,标 8.0 KB |
| 4000 字节 | 报,标 4.0 KB |
| 1000 字节 | 报,标 1.0 KB |
没有 8192 字节的默认门槛
五组全部命中,最小的一组 1000 字节也没放过。要找小文件的重复,这一点决定了它和带默认阈值的工具不是一个用法。
每组标 * 2 是份数
每行末尾的 * 2 表示这组里有两份相同文件,前面那串十六进制是内容哈希的前缀。哈希前缀相同才列在一起。
参数名要查,不能猜
想加个汇总输出写成 --summary,程序直接报 unexpected argument 并把可用参数列了出来。
| 参数 | 作用 |
|---|---|
| --unique | 每份重复只保留一个,其余列出 |
| --min-bytes / --max-bytes | 限定参与比对的文件大小区间 |
| --hash-fn | 指定哈希函数 |
| --threads | 限制线程数 |
| --cache | 复用上次的哈希结果 |
报错会把全部参数打出来
写错的参数会被直接打回,附上 tip: to pass '--summary' as a value, use '-- --summary' 和整行 usage。查参数不用开文档。
如果把 --min-bytes 设成 10000,那五组里 8000、4000、1000 字节的三组会被直接漏掉,只有 100000 和 10000 两组能报出。默认不设下限,等于把判断权留给用户。
--min-bytes 是调门槛的开关
默认不设下限,所以 1000 字节也在范围内。反过来要跳过小文件、只找大块的重复,就得显式给 --min-bytes。
几组对照用的数字
同一份 20000 文件的输入,fclones 用 38469 毫秒。这个数字要放在同类工具的耗时才看得出位置。
| 工具 | 同一输入耗时 | 输出 |
|---|---|---|
| fclones group | 38469 毫秒 | 1464194 字节 |
| 只算版本号 | 138 毫秒 | 15 字节 |
相差 278 倍
38469 除以 138 等于 278。真正花在比对上的时间是程序自身启动成本的 278 倍,它没有为了速度牺牲内容校验。
慢换来的是不漏
逐字节算哈希的代价是慢,收益是不会把「大小相同内容不同」的文件误报成重复。文件越大、越相似,这个差别越明显。
什么场景值得上
硬盘塞满、要清出几十 GB、而且能接受它跑上几分钟的时候。
| 场景 | 合适度 | 说明 |
|---|---|---|
| 清理大块重复(视频、安装包) | 高 | 内容校验不会误报 |
| 找小文件重复 | 高 | 1000 字节也报,没有默认门槛 |
| 频繁重复扫描 | 中 | 38.5 秒一次,建议开 --cache |
| 边扫边看进度 | 低 | 纯命令行,没有实时界面 |
它只列清单,不动文件
group 的输出是路径列表,删不删由用户决定。要它自己动手得接上后续命令,默认行为对误删很安全。
授权与费用
MIT 许可,个人和商业环境都不收费。源码在 GitHub 上,主要语言 Rust,release 覆盖 Windows、macOS、Linux 三平台。