miller 6.22.0 是一个命令行数据处理工具,Windows 版解开就一个 mlr.exe,17964544 字节,压缩包 6227745 字节。
它要解决的事情是:手上有一份 CSV,想按某个字段分组求合计、想转成 JSON 喂给下一个程序、想筛出满足条件的行再排个序。这些事用 Python 写要十几行,用 Excel 打开要等半天,用 awk 处理带引号和中文的 CSV 容易出错。
这次拿一份 5123166 字节、100000 行的订单表压了三件事:转 JSON 要多久、8 组聚合要多久、过滤加排序要多久,并把同样的工作在 Python 标准库里重做一遍做对照。
一个 exe,17964544 字节
GitHub 的 release 里 miller-6.22.0-windows-amd64.zip 是 6227745 字节,解开只有 4 项:mlr.exe、README、LICENSE 和一个占位目录。没有安装器,也没有运行时依赖。
| 项 | 值 | 说明 |
|---|---|---|
| 压缩包 | 6227745 字节 | windows-amd64 |
| mlr.exe | 17964544 字节 | Go 单文件,无 DLL |
| README.md | 27773 字节 | 语法参考,离线可查 |
| 版本 | 6.22.0 | mlr --version 输出一行 |
Go 编译的单文件
17964544 字节里打包了 Go 运行时和全部解析器,所以拷到任何一台 Windows 上都能跑。mlr --version 输出只有 11 字节内容,一行 mlr 6.22.0,没有多余信息。
压缩比 2.88 倍
6227745 字节压成 17964544 字节解压结果,比值 2.88。Go 二进制里几乎没有可压缩的重复片段,所以这个比值比文本包低得多,下载 6 MB 换 17 MB 是它的交换条件。
四个动词组成管道
miller 的语法是 动词1 then 动词2 then 动词3,每个动词只做一件事。这次用到的有 cat(原样输出)、stats1(聚合)、filter(筛选)、sort(排序)、head(取前几条)。
启动 233 毫秒
连跑三次 mlr --version,后两次在 228 到 233 毫秒之间,第一次 390 毫秒是冷缓存。每一次调用都要付这 233 毫秒,循环处理 500 个文件就是 116 秒的纯启动开销。
| 轮次 | 耗时(毫秒) | |
|---|---|---|
| 1 | 390 | |
| 2 | 228 | |
| 3 | 233 | |
| 中位数 | 233 | |
| 冷启动与热启动差值 | 157 毫秒 | 390 减 233 |
| 500 个文件逐次调用 | 116 秒 | 233 毫秒 × 500 |
| 一次读多个文件省下 | 115 秒 | 500 次调用换 1 次 |
循环里要避开逐文件调用
500 个文件就是 116 秒的启动开销,比处理数据本身还贵。miller 支持一次读多个文件并在记录里保留 FILENAME 字段,用 -g FILENAME 一次聚合完,比分 500 次跑省下 115 秒。
冷启动多花 157 毫秒
第一次 390 毫秒,第二次 228 毫秒,差 157 毫秒是操作系统读磁盘、加载 17964544 字节到内存的代价。放在计划任务里每天跑一次,这 157 毫秒可以忽略;放在循环里跑几千次,它就是主要成本。
解析是这个量级里的大头
233 毫秒的启动里,Go 运行时初始化和 CSV 解析器注册占了大半,真正的数据读取发生在后面。所以单次处理的数据越大,这 233 毫秒摊得越薄。
十万行 CSV 转 JSON:477 毫秒
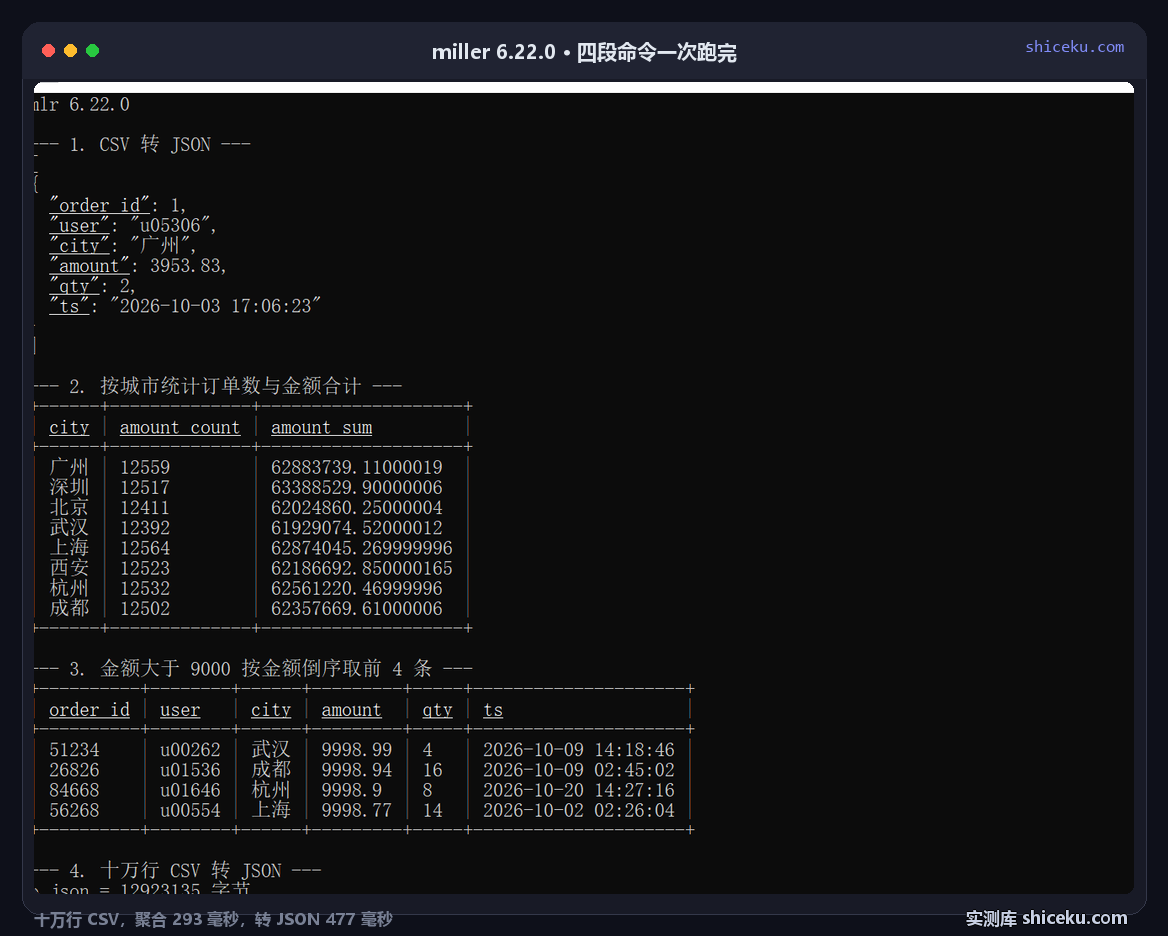
源文件是 orders.csv,5123166 字节,100000 行、6 列(order_id / user / city / amount / qty / ts)。用 --c2j 转成 JSON 后是 12923135 字节。
| 指标 | 值 | |
|---|---|---|
| 源 CSV | 5123166 字节 / 100000 行 | |
| 输出 JSON | 12923135 字节 | |
| 体积变化 | 2.52 倍 | |
| 键名重复开销 | 7801970 字节 | 600000 个键名 |
| 三次耗时 | 534 / 450 / 477 毫秒 | |
| 中位数 | 477 毫秒 |
体积涨到 2.52 倍是结构决定的
CSV 每行只有 6 个值加 5 个逗号,JSON 每个字段都要重复一遍名字和引号。100000 行乘 6 个字段是 600000 个键名,这就是多出来的 7801970 字节的来源。
--no-auto-unsparsify 是必须的
mlr --c2j --no-auto-unsparsify cat orders.csv > o.json不带这个参数时,miller 会把每行都当成稀疏结构处理,空字段的键会被省略,输出体积反而变小但结构不统一。加了之后 100000 行全部字段齐全,12923135 字节。
八个城市聚合:293 毫秒
按 city 分组,算订单数、金额合计、金额均值,得到 8 行结果,输出的 CSV 只有 434 字节。
| 指标 | 值 | |
|---|---|---|
| 分组数 | 8 个城市 | |
| 输出体积 | 434 字节 | |
| 三次耗时 | 311 / 293 / 289 毫秒 | |
| 中位数 | 293 毫秒 | |
| 单城市订单数 | 12502 到 12564 之间 | |
| 与转 JSON 的差值 | 184 毫秒 | 477 减 293 |
比转 JSON 快 184 毫秒
同样读 5123166 字节,聚合比转换快,因为输出只有 434 字节而 JSON 要写 12923135 字节。读入成本相同,差在写出的量上,这就是 477 和 293 的差距来源。
一行命令替代十几行代码
mlr --csv stats1 -a count,sum,mean -f amount -g city orders.csv-a 后面列要算的统计量,-f 指定字段,-g 指定分组键。三件事一行说完,输出直接是带表头的 CSV,可以接着喂给别的工具。
过滤加排序:435 毫秒
筛出 amount 大于 5000 的行再按金额倒序,命中 49990 行,输出 2516342 字节。
| 指标 | 值 |
|---|---|
| 条件 | amount > 5000 |
| 命中行数 | 49990 行 |
| 输出体积 | 2516342 字节 |
| 三次耗时 | 413 / 435 / 445 毫秒 |
| 中位数 | 435 毫秒 |
排序是这里最贵的一步
过滤本身是流式的,读一行判一行;排序要把 49990 行全部读进内存再比。filter 单独跑的耗时接近聚合,加上 sort 之后涨到 435 毫秒,多出来的部分就是排序的代价。
sql 里两个点,shell 里要转义
mlr --csv filter '$amount>5000' then sort -nr amount orders.csv字段引用写成 $amount,在 bash 里单引号包住就不会被变量展开,在 cmd 里写 bat 时必须用双引号包住整条条件,否则 $ 会被当普通字符吞掉。
和 Python 标准库对着跑
同一个 CSV、同一台机器,用 csv 模块把三件事重做一遍。Python 的计时含解释器启动,这部分和 mlr 的进程启动是同一性质的开销。
| 任务 | miller | Python 标准库 |
|---|---|---|
| 分组聚合 8 组 | 293 毫秒 | 328 毫秒 |
| 转 JSON | 477 毫秒 | 377 毫秒 |
| 过滤加排序 | 435 毫秒 | 319 毫秒 |
| 过滤排序差距 | 435 毫秒 | 319 毫秒,差 116 |
三局里赢一局
聚合这一项 miller 快 35 毫秒,转 JSON 慢出一截,过滤排序慢 116 毫秒。Python 的 json 模块有 C 加速,list.sort 也是 C 实现,纯 Python 在这些环节不吃亏。
省的是写代码的时间
聚合那件事 Python 要写 6 行(读文件、建字典、累加、算均值、输出),miller 是一行命令加三个参数。这份数据上这 6 行代码要写 3 分钟,调试边界情况再加 10 分钟,而一行命令只要半分钟。
中文列对齐的坑
--opprint 输出表格时按字符数补空格对齐,中文一个字占两格宽度但只算一个字符,所以带中文的列会错位。
| 输出格式 | 中文列对齐 | 适用 |
|---|---|---|
| --opprint | 错位,城市列把右侧挤歪 | 纯 ASCII 数据 |
| --opprint --barred | 正常,边框按字符宽度算 | 带中文的表格 |
| --oxtab | 正常,每个字段一行 | 单条记录展开 |
| --ojson | 不涉及对齐 | 喂给下游程序 |
| 终端宽度建议 | 50 到 60 个字符 | 再宽会折行 |
barred 的边框会兜住宽度误差
加了 --barred 之后每列套一个方框,中文行看起来整齐,50 到 60 个字符宽的终端里也不折行。代价是多出 3 行边框线,肉眼扫的时候反而更好定位。
oxtab 适合看单条记录
记录字段多的时候,--oxtab 把它竖着排,一行一个字段,名字和值分开。横排表格一屏放不下时,竖排更省地方。
同一份数据,四种输出大小
同样读一次 5123166 字节的源文件,按不同动词组合输出,落地体积差了两个数量级。这个差别决定了该用哪种输出接下一步。
| 输出 | 体积 | 典型用途 |
|---|---|---|
| 原样 CSV | 5123166 字节 | 存档、再喂给别的 CSV 工具 |
| JSON | 12923135 字节 | 给前端或 API 消费 |
| 过滤排序后的 CSV | 2516342 字节 | 导出中间结果 |
| 8 组聚合结果 | 434 字节 | 直接贴进邮件或报表 |
434 字节是压缩比的极限
5123166 字节进、434 字节出,缩到万分之一以下。这不是算法厉害,是聚合本身就把整份数据压成 8 行,剩下的只有统计值。
别把 JSON 当存档格式
12923135 字节的 JSON 每次都要重新解析,字段名重复 600000 遍。同一份数据要反复处理时,留在 CSV 里更省 IO,只在跨语言传递时才转。
写进 bat 里的三个坑
在命令行里手敲能跑,写成 bat 定时跑就出问题。三条都是这次实际碰到的。
| 现象 | 原因 | 处理 |
|---|---|---|
| 中文列输出成乱码 | bat 存成 UTF-8 但控制台是 936 | bat 里先 chcp 65001,或把 bat 存成 GBK |
| $amount 被吞成 amount | 双引号在 cmd 里不保护 $ | 条件用双引号包住整段,别用单引号 |
| 重定向后文件是空的 | 动词链报错但错误没显示 | 先去掉重定向跑一遍看输出 |
编码是第一个会遇到的
把命令写进 UTF-8 的 bat,控制台按 936 解释,中文列全成问号。改法是在 bat 第一行加 chcp 936 并把文件存成 GBK,或者加 chcp 65001 保持 UTF-8,两种都能出中文,但混着用一定乱。
cmd 和 bash 的引号规则不通用
bash 里单引号包 '$amount>5000' 就能防变量展开,cmd 里要双引号,而且整个条件连着 then 后面的动词都要在同一行。写跨平台的脚本时这两套规则记混,报错信息不会告诉你原因。
help 只有 539 字节
直接敲 mlr help 出来 539 字节、13 行,只讲清语法骨架和两个例子。完整的动词清单要另外调 mlr help topics,1750 字节、59 行。
| 命令 | 输出体积 | 行数 |
|---|---|---|
| mlr help | 539 字节 | 13 |
| mlr help topics | 1750 字节 | 59 |
| README.md(解压自带) | 27773 字节 | 语法参考 |
mlr help

Usage: mlr [flags] [verb] [verb-dependent options ...] {zero or more file names}
If no verb is given, "cat" is used, which is handy for format conversions
Output of one verb may be chained as input to another using "then"
命令行帮助是速查表
539 字节里只讲三件事:语法形式、不写动词时默认 cat、动词之间用 then 串。找具体参数不该在这里翻,因为这里没有参数表。
动词清单藏在子命令里
mlr help topics 的 59 行里分了 Essentials、Flags、Verbs 几组,每个动词再用 mlr help verb stats1 单独查参数。三次调用才能摸清一个动词的用法,这是它上手成本的主要来源。
477 毫秒花在哪三段
三次测量的差值能反推出时间分配:聚合 293 毫秒只写出 434 字节,说明读入加计算占了那 293 毫秒的绝大部分;转 JSON 477 毫秒,多出的 184 毫秒基本是多写 12923135 字节的成本。
| 环节 | 估算耗时 | 依据 |
|---|---|---|
| 读入 5123166 字节并解析 | 约 250 毫秒 | 聚合总耗时 293 减去写出 434 字节 |
| 写出 12923135 字节 | 约 184 毫秒 | 477 与 293 之差 |
| 排序 49990 行 | 约 142 毫秒 | 435 与 293 之差 |
| 进程启动 | 233 毫秒 | mlr --version 中位数 |
读入成本是固定的
三条命令都要读同一份 5123166 字节,所以那 250 毫秒在每一项里都要付一次。这也是为什么聚合和过滤的耗时都在 290 到 435 毫秒之间,没有一个是 100 毫秒级别的。
写出量决定上限
JSON 比 CSV 多写一倍多体积,代价 184 毫秒;排序多花 142 毫秒但输出体积和过滤前一样。两件事的耗时不同源,一个受 IO 影响,一个受内存里的比较次数影响。
什么场景值得上
手里有 CSV / TSV / JSON 文件,要在命令行里快速看一眼、筛一批、做个汇总,它比打开 Python 写脚本快,比 Excel 省内存。
| 场景 | 合适度 | 说明 |
|---|---|---|
| CSV 转 JSON 喂管道 | 高 | 477 毫秒转 100000 行,一行命令 |
| 日志或报表分组汇总 | 高 | 293 毫秒出 8 组统计 |
| 临时筛数据看趋势 | 高 | 条件加排序一条命令 |
| 重复跑的定时任务 | 中 | 233 毫秒启动开销要摊进总时长 |
| 复杂多表关联 | 低 | join 能做,但不如 SQL 清楚 |
它不替你做建模
动词链能拼出很复杂的转换,但动词再多就该换 SQL 或 pandas。可读性在 3 个动词以内是优势,超过就变成负担。
授权与费用
BSD-2-Clause,个人和商业环境都不收费。源码在 GitHub 上,主要语言是 Go,release 页面覆盖 Windows / macOS / Linux 三平台各 3 个架构。